 Rustango
ORM-Kochbuch
Muster für das Rustango-ORM jenseits der Grundlagen. Wenn du schon einmal mit einem ORM gearbeitet hast, werden dir die Formen hier vertraut vorkommen. Die meisten Beispiele setzen voraus, dass du bereits ein Post-Model aus Getting Started hast.
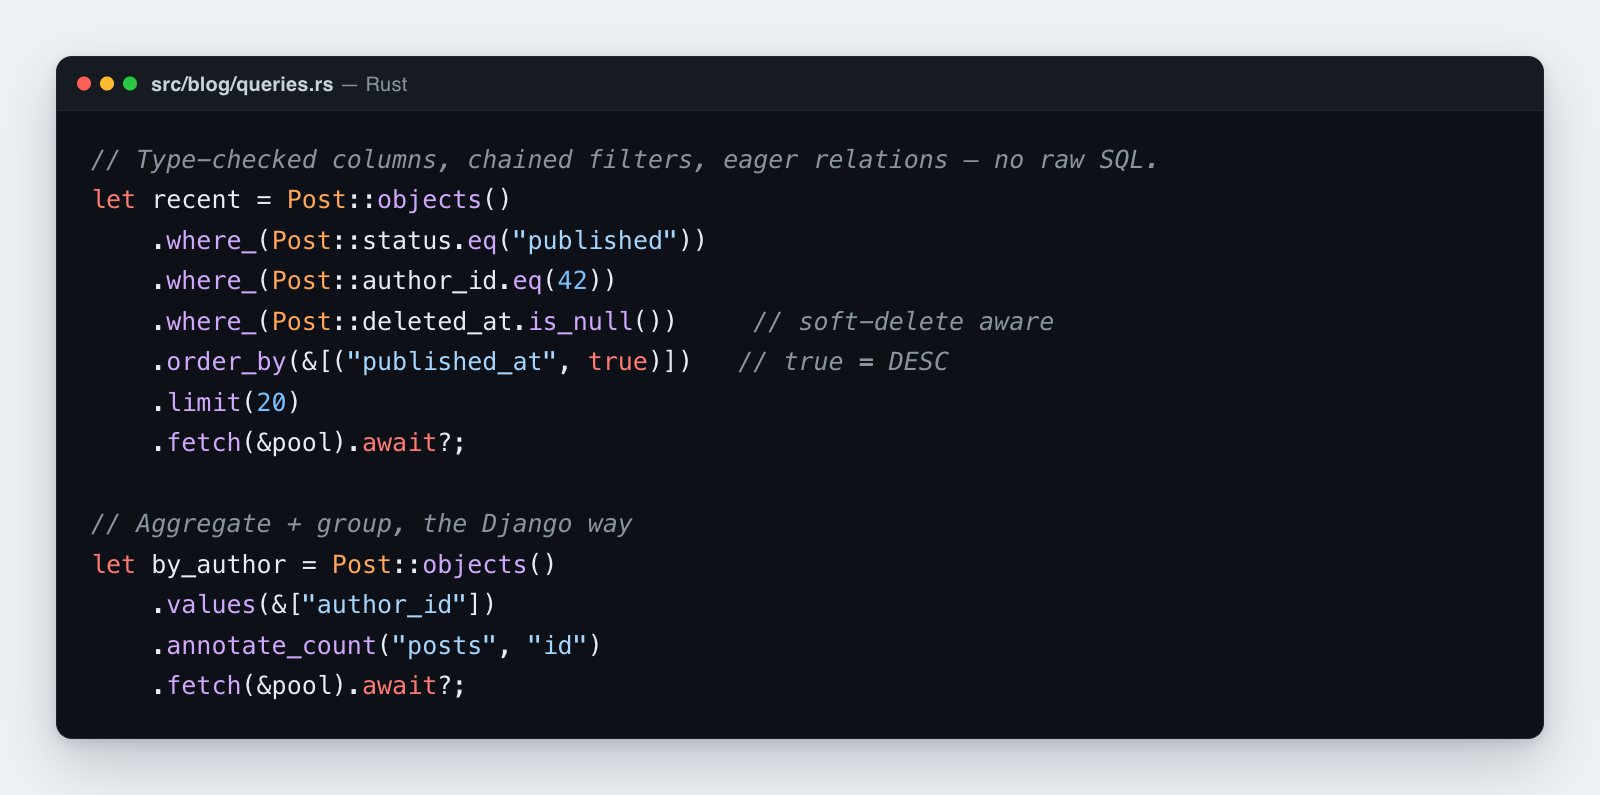
Quelle:
rustango::sql(QuerySet, dasQ!-Makro / derquery::Q-Builder) und die#[derive(Model)]-Query-API — immer kompiliert; wähle ein Backend-Feature (postgres/mysql/sqlite).Lauffähige Version: die Muster hier laufen im getesteten
orm_cookbook-Beispiel.Neu bei einem Begriff hier? Das Glossar definiert model, queryset, pool und migration in einfacher Sprache.
Ein paar Rust-Begriffe tauchen durchgehend auf. &pool ist eine geteilte Referenz auf einen Datenbank-Verbindungspool — hier ein rustango::sql::Pool, das Mehr-Backend-Enum, das fetch, count und die Writer (save, insert, delete) nehmen. Die _on-Methoden nehmen jeden SqlExecutor: dieses &pool, eine gehaltene Verbindung oder eine offene Transaktion. sql::Pool hat kein begin(); seine Transaktions-Einstiegspunkte sind transaction_pool und atomic. .await führt einen asynchronen Aufruf aus und wartet auf das Ergebnis. Option<T> ist ein Wert, der vorhanden (Some) oder abwesend (None) sein kann — Rusts Null. Result ist Erfolg-oder-Fehler; das nachgestellte ? an einem Aufruf kehrt bei einem Fehler früh zurück. Auto<i64> ist ein automatisch hochzählender Primärschlüssel, der entweder Set (aus der DB geladen) oder Unset (noch nicht eingefügt) ist.
Neuere Ergänzungen
Jüngste Releases haben eine Reihe von Features hinzugefügt, die noch nicht in jeden Abschnitt weiter unten eingearbeitet sind. Kurze Hinweise:
Q!-Makro +query::Q-Laufzeit-Builder — kompilierzeitsichere Filter.User::objects().where_(Q!(User.email__icontains = "alice"))lässt sich bei einem falsch geschriebenen Feldnamen nicht bauen. Laufzeit-komponierbare Variante für Admin-Filter-Chips:let q = rustango::query::Q::eq("active", true) & rustango::query::Q::gt("age", 18i64);..distinct_on(&["author_id"])— PG-nativ; portabler Fallback per Fensterfunktion auf MySQL / SQLite. Muster nach dem Schema "Neuestes pro Gruppe".bulk_upsert_pool(rows, unique_fields, update_fields, &pool)— viele Zeilen in einem Statement einfügen oder bei Konflikt aktualisieren. Tri-dialektisches ON CONFLICT / ON DUPLICATE KEY UPDATE. Wiederholt sich ein Schlüssel, gewinnt die letzte Zeile.explain_pool()— tri-dialektisches EXPLAIN. PGEXPLAIN (FORMAT JSON, ANALYZE, BUFFERS)/ MySQLEXPLAIN ANALYZE/ SQLiteEXPLAIN QUERY PLAN.- DB-Funktionsbibliothek —
Cast,LPad,RPad,MD5,SHA1,SHA256,Position,Repeat,Reverse,Sign,Mod,Power,Sqrt. Emission pro Dialekt mit klaren Fehlern dort, wo SQLite die Funktion nicht hat. - Feldtypen —
rust_decimal::Decimal(PG/MySQL-nativ, SQLite über einen Decode-Shim),chrono::NaiveTime,Vec<u8>(FieldType::Binary) werden jetzt von#[derive(Model)]akzeptiert (v0.42). ModelForm::prepare_save()/PreparedSave(v0.42) — validieren, ohne sofort zu schreiben. Jetzt validieren, das vorbereitete Schreib-Set mutieren, committen, wenn bereit.#[rustango(unique_when(columns = "...", condition = "..."))]— partielle Unique-Constraints. "Eindeutige E-Mail pro nicht-gelöschter Zeile" / "Eindeutiger Slug pro Mandant".manage makemigrations --merge(v0.42) — Merge-Knoten für divergente Branch-Ketten. Siehedocs/manage.md.
Das CHANGELOG führt den vollständigen Ticket-Index für jedes Release.
Inhaltsverzeichnis
- Abfragen
- Berechnete Werte & Datenbankfunktionen
- Aggregationen
- Joins & Vorladen verwandter Zeilen
- Massenoperationen
- Einfügen oder aktualisieren (Upsert)
- Transaktionen
- Many-to-many
- JSON / JSONB
- Soft Delete
- Audit-Trail
- Raw-SQL-Notausstieg
- Lazy-FK-Laden
- Vier Wege zu filtern
- Mandantengebundene Abfragen
- Signale
- Performance-Tipps
Abfragen
use rustango::prelude::*; holt die Erweiterungs-Traits des ORM (FetcherPool, CounterPool, ExistsPool, UpdaterPool, FetcherTx), Column, Model und Auto auf einmal in den Scope. Ohne sie scheitert .count(&pool) oder .fetch(&pool) mit "QuerySet is not an iterator". Die Beispiele unten importieren jeden Trait einzeln.
Zeilen aus der Datenbank lesen. Post::objects() startet eine Abfrage; du verkettest Filter und Sortierung und rufst dann .fetch(&pool).await? auf, um sie auszuführen und ein Vec<Post> zurückzubekommen. .where_(...) fügt eine per-AND verknüpfte Bedingung hinzu.
use rustango::core::Column as _;
use rustango::core::{Op, SqlValue, WhereExpr};   // for filter_op / where_raw below
use rustango::sql::FetcherPool as _;

// Simplest — fetch all
let posts = Post::objects().fetch(&pool).await?;

// Single equality filter
let drafts = Post::objects()
    .where_(Post::status.eq("draft"))
    .fetch(&pool).await?;

// Chained filters (AND)
let recent_drafts = Post::objects()
    .where_(Post::status.eq("draft"))
    .where_(Post::author_id.eq(42))
    .where_(Post::deleted_at.is_null())
    .order_by(&[("created_at", true)])        // true = DESC
    .limit(20)
    .fetch(&pool).await?;

// String-keyed filter (validated at compile of the queryset)
let by_id = Post::objects()
    .filter_op("id", Op::Eq, SqlValue::I64(42))
    .fetch(&pool).await?;

// OR / nested
let qs = Post::objects().where_raw(WhereExpr::Or(vec![
    Post::status.eq("draft").into(),
    Post::status.eq("review").into(),
]));

// XOR. Matches rows where an odd number
// of operands evaluate to true (binary case = "exactly one is true").
let either_but_not_both = Post::objects()
    .where_(Post::status.eq("draft").xor(Post::author_id.eq(42)))
    .fetch(&pool).await?;
// Tri-dialect emission: native logical XOR exists on MySQL but not PG
// or SQLite, so the writer emits a portable CASE-WHEN-1/0 tally
// `% 2 = 1`; a NULL operand counts as false.
Vergleichsfilter
Die alltäglichen Filtermethoden, eine pro SQL-Operator. Das sind die Feld-Lookups (__gt, __in, __icontains und so weiter) in typisierter Form.
Post::objects().where_(Post::view_count.gt(100)).fetch(&pool).await?;
Post::objects().where_(Post::view_count.gte(100)).fetch(&pool).await?;
Post::objects().where_(Post::view_count.lt(100)).fetch(&pool).await?;
Post::objects().where_(Post::view_count.lte(100)).fetch(&pool).await?;
Post::objects().where_(Post::status.ne("archived")).fetch(&pool).await?;
Post::objects().where_(Post::id.is_in([1, 2, 3])).fetch(&pool).await?;
Post::objects().where_(Post::status.not_in(["draft", "deleted"])).fetch(&pool).await?;
Post::objects().where_(Post::title.like("%draft%")).fetch(&pool).await?;          // case-sensitive contains
Post::objects().where_(Post::title.ilike("%draft%")).fetch(&pool).await?;         // case-insensitive contains
Post::objects().where_(Post::title.ilike("Hello%")).fetch(&pool).await?;          // case-insensitive starts-with
Post::objects().where_(Post::deleted_at.is_null()).fetch(&pool).await?;
Post::objects().where_(Post::published_at.between(start, end)).fetch(&pool).await?;
Ergebnisse sortieren
Sortiere Zeilen nach einer oder mehreren Spalten, nach einem Ausdruck oder mit expliziter Kontrolle darüber, wo NULLs landen. Über das grundlegende .order_by(&[("col", desc)]) hinaus bekommst du drei zusätzliche Dimensionen:
use rustango::core::funcs::lower;
use rustango::core::{F, NullsOrder};

// 1. Plain field + ASC/DESC (back-compat — implicit NULLS handling
//    differs between dialects; see the dialect note below).
Post::objects()
    .order_by(&[("published_at", true), ("id", false)])
    .fetch(&pool).await?;

// 2. Explicit NULLS FIRST/LAST control — portable across PG, MySQL,
//    and SQLite. MySQL has no native `NULLS …` keyword; the writer
//    emulates with an `<col> IS NULL` pre-sort term so the on-wire
//    ordering matches PG/SQLite.
Post::objects()
    .order_by_with_nulls(&[("score", true, NullsOrder::Last)])
    .fetch(&pool).await?;

// 3. Arbitrary Expr in the ORDER BY position — case-insensitive
//    title sort via `LOWER(title)`, computed sort keys via
//    `case() / when() / value()`, arithmetic via `F("a") + F("b")`.
Post::objects()
    .order_by_expr(lower(F("title")), false)
    .order_by_expr_with_nulls(F("score") + 1_i64, true, NullsOrder::Last)
    .fetch(&pool).await?;
NULLS-Behandlung pro Dialekt (kein explizites NullsOrder gesetzt):
| Dialekt | ASC-Standard | DESC-Standard |
|---|---|---|
| PostgreSQL | NULLS LAST | NULLS FIRST |
| SQLite | NULLS LAST | NULLS FIRST |
| MySQL | NULLs zuerst (Semantik des kleinsten Werts) | NULLs zuletzt |
Verwende .order_by_with_nulls(...) / .order_by_expr_with_nulls(...), um die Platzierung festzunageln; andernfalls gilt der native Standard der Datenbank. Auf MySQL emittiert der Writer <col> IS NULL <asc|desc> vor der eigentlichen Sortierung, um das nachzubilden; das emittierte SQL hat zwei ORDER-BY-Terme pro festgenagelter Spalte, aber die Semantik entspricht PG/SQLite.
Kettenkomposition. .order_by(...), .order_by_with_nulls(...) und .order_by_expr(...) sammeln sich in Registrierungsreihenfolge zu einer einheitlichen Liste. .replace_order_by(&[...]) löscht jeden vorherigen Order-by-Aufruf. .flip_order_by() invertiert jede Richtung UND tauscht NullsOrder::First ↔ NullsOrder::Last, sodass die Semantik "NULLs am selben Ende" eine Invertierung übersteht (für explizites First / Last; das Dialekt-Standardverhalten unter Default folgt weiterhin der Richtung).
Zufällige Sortierung
Gib Zeilen in zufälliger Reihenfolge zurück. Verwende .order_random(). Es emittiert ORDER BY RANDOM() auf PG und SQLite, ORDER BY RAND() auf MySQL. Praktisch für Banner-Rotation, Sampling oder A/B-Test-Bucket-Zuweisung, ohne Zeilen in die App zu ziehen, um sie zu mischen.
// Three random posts.
Post::objects()
    .order_random()
    .limit(3)
    .fetch(&pool).await?;

// Random tie-breaker after a primary sort: posts ordered by score
// descending, with ties shuffled.
Post::objects()
    .order_by(&[("score", true)])
    .order_random()
    .fetch(&pool).await?;
Die IR-Variante trägt keine Richtungs- oder NULLS-Klausel: zufällige Sortierung ist per Definition ungeordnet, und der Zufallsschlüssel wird pro Zeile berechnet (non-NULL).
Performance-Vorbehalt. ORDER BY RANDOM() erzwingt einen vollständigen Tabellenscan + In-Memory-Sortierung nach einem Zufallsschlüssel pro Zeile. Der Query-Planer kann keinen Index nutzen. Für Tabellen, die deutlich größer als der Speicher sind, bevorzuge das indexfreundliche Muster:
// Coin-flip offset; range-scans the PK index.
let max_id: i64 = Post::objects().max::<i64>("id", &pool).await?.unwrap_or(0);
let offset = rand::random::<u32>() as i64 % max_id.max(1);
Post::objects()
    .where_(Post::id.gte(offset))
    .order_by(&[("id", false)])
    .limit(1)
    .fetch(&pool).await?;
Der Kompromiss: die Nachbarschaft in den Ergebniszeilen spiegelt die PK-Nachbarschaft wider, ist also nicht "gleichverteilt zufällig" im strengen Sinn — dafür entgeht sie den Kosten des vollständigen Tabellenscans.
Paginierung
Hol dir jeweils eine Ergebnisseite auf einmal. .limit(size).offset(...) ist die einfache Seitennummern-Form; die Cursor-Form ("alles nach der letzten ID, die ich gesehen habe") skaliert bei großen Tabellen besser.
// Page-number — page 2 of 50-row pages = LIMIT 50 OFFSET 50.
let page = Post::objects().limit(50).offset(50).fetch(&pool).await?;

// Cursor (manual — no auto-next-token from QuerySet)
let next = Post::objects()
    .where_(Post::id.gt(last_id))
    .order_by(&[("id", false)])
    .limit(50)
    .fetch(&pool).await?;
Für Cursor-Paginierung auf HTTP-Seite verwende stattdessen ViewSet::cursor_pagination("id").
Zeilen in eine Map laden
Schlag viele Zeilen anhand einer Werteliste nach und bekomme sie als HashMap zurück, geschlüsselt nach dieser Spalte. Verwende .in_bulk(...) für "hol diese N Zeilen in einem Roundtrip, indiziert nach ID". Eine HashMap<K, V> ist Rusts Dictionary/Hash-Tabelle.
use std::collections::HashMap;
use rustango::sql::Auto;

// Default shape: keyed by the Auto<i64> PK.
let books: HashMap<i64, Book> = Book::objects()
    .in_bulk(Book::id, [1_i64, 2, 3], |b| match b.id {
        Auto::Set(v) => v,
        Auto::Unset  => unreachable!("fetched row has Auto::Set PK"),
    }, &pool)
    .await?;
assert_eq!(books[&1].title, "The Rust Programming Language");

// `field_name=` equivalent — key by any unique column.
let by_isbn: HashMap<String, Book> = Book::objects()
    .in_bulk(Book::isbn, ["isbn-1".to_string()], |b| b.isbn.clone(), &pool)
    .await?;
Komponiert mit vorherigen .where_()-Filtern — die IN-Liste wird per AND mit dem bestehenden WHERE verknüpft. Ein leeres ids schließt kurz mit einer leeren Map (es wird kein SQL abgesetzt). Der Closure behandelt das Auto<T> / ForeignKey<T, K>-Auspacken explizit und gibt den Aufrufern Kontrolle darüber, wie der Schlüssel materialisiert wird.
Mandantengebundenes Geschwister: in_bulk_on(column, ids, extract, &executor) nimmt jeden SqlExecutor — kombiniere es mit tenant.conn().await? für Schema-Modus-Mandanten.
Zeilen zum Aktualisieren sperren
Sperre die Zeilen, die du auswählst, sodass keine andere Transaktion sie ändern kann, bis du committest — der Standardweg, um Arbeit zu beanspruchen oder verlorene Updates zu verhindern. Rufe .select_for_update() auf; es hängt SELECT … FOR UPDATE (oder eine Variante) an, und die Sperre dauert für die umgebende Transaktion.
// Canonical "claim next available row" pattern. Worker A grabs the
// lowest-priority pending job; concurrent worker B with SKIP LOCKED
// skips A's row and grabs the next instead — no blocking.
let mut tx = rustango::sql::write_transaction(&pool).await?;
let claim: Vec<Job> = Job::objects()
    .where_(Job::status.eq("pending"))
    .order_by(&[("priority", false)])
    .limit(1)
    .select_for_update()
    .skip_locked()
    .fetch_on(&mut tx).await?;
// ... mark claim[0] as in-progress, do work ...
tx.commit().await?;
Builder-Methoden — verkette sie, um sie zu aktivieren:
.select_for_update()— schlichtesFOR UPDATE..skip_locked()— hängtSKIP LOCKEDan; Zeilen, die von einer anderen Transaktion gehalten werden, werden stillschweigend herausgefiltert, statt zu blockieren..nowait()— hängtNOWAITan; liefert sofort einen Treiber-Fehler, wenn irgendeine passende Zeile gesperrt ist. Schließt sich gegenseitig mitskip_lockedaus (der Writer wählt das permissivereSKIP LOCKED, wenn beide gesetzt sind)..no_key()— emittiert stattdessenFOR NO KEY UPDATE(PG 9.3+). Schwächere Sperre, die Schreiber nicht blockiert, die nur Nicht-Schlüsselspalten anfassen..of(&["table_or_alias", …])— beschränke die Sperre auf bestimmte Tabellen, wenn die Abfrage JOINt.
.skip_locked() / .nowait() / .no_key() / .of(…) ohne ein vorheriges .select_for_update() aufzurufen, aktiviert die Sperre implizit — der Aufruf bleibt so kurz wie möglich.
Tri-dialektisches Verhalten:
| Dialekt | Verhalten |
|---|---|
| PostgreSQL | Volle Unterstützung — jedes Flag emittiert seine native Syntax. |
| MySQL 8.0.1+ | Unterstützt alles außer NO KEY — dieses Flag fällt auf schlichtes FOR UPDATE zurück (die strengere Sperre). |
| SQLite | Keine Syntax für Sperren auf Zeilenebene; der Writer emittiert keine Klausel. Öffne die Transaktion mit rustango::sql::write_transaction(&pool): Sie nimmt die Schreibsperre der Datenbank beim BEGIN, sodass ein zweiter Worker wartet und dann die beanspruchte Zeile sieht. Eine transaction_pool-Transaktion sperrt nichts, bis sie schreibt, und der zweite Schreiber scheitert mit SQLITE_BUSY. Ein atomic-Block tut dasselbe: Sein äußerster SQLite-Block startet mit BEGIN IMMEDIATE. |
Muss innerhalb einer Transaktion laufen. FOR UPDATE außerhalb einer Transaktion ist auf PostgreSQL eine No-op (die implizite Ein-Statement-Transaktion gibt die Sperre sofort frei) und auf MySQL ein Fehler. Öffne sie mit rustango::sql::write_transaction(&pool) und lies mit .fetch_on(&mut tx); das läuft auf jedem Backend.
Abfragen kombinieren (Vereinigung, Schnitt, Differenz)
Führe zwei oder mehr Abfragen über dasselbe Model mit SQL-Mengenoperatoren zusammen: .union(), .intersection() und .difference().
// Posts that are EITHER drafts OR currently in review.
let inbox: Vec<Post> = Post::objects()
    .where_(Post::status.eq("draft"))
    .union(Post::objects().where_(Post::status.eq("review")))
    .order_by(&[("created_at", true)])
    .limit(50)
    .fetch(&pool).await?;
Builder-Methoden:
| Methode | SQL | Semantik |
|---|---|---|
.union(other) | UNION | Kombinieren + deduplizieren |
.union_all(other) | UNION ALL | Kombinieren, Duplikate behalten (günstiger, kein DISTINCT-Durchlauf) |
.intersection(other) | INTERSECT | Zeilen in BEIDEN Querysets |
.difference(other) | EXCEPT | Zeilen im ersten Queryset, aber NICHT in den anderen |
Jede Methode nimmt QuerySet<T> — beide Zweige müssen auf dasselbe Model T zielen, sodass die Spaltenform per Konstruktion passt (zur Kompilierzeit durch Rusts Generics geprüft). Aufrufe sammeln sich an; das Mischen von Operatoren in einer Kette ist erlaubt (a.union(b).intersection(c) wertet auf jedem Backend von links nach rechts aus, als (a ∪ b) ∩ c).
Äußere Modifikatoren gelten für das zusammengeführte Ergebnis:
// Outer .order_by() / .limit() / .offset() / .select_for_update()
// set AFTER the union apply to the combined resultset, NOT per-branch.
let page: Vec<Post> = qs_a
    .union(qs_b)
    .union(qs_c)
    .order_by(&[("id", false)])    // sorts the merged rows
    .limit(20)                     // caps the merged count
    .offset(40)                    // skips into the merged result
    .fetch(&pool).await?;

// Per-branch ORDER BY / LIMIT stay INSIDE the branch's parens:
let mixed = qs_a
    .union(qs_b.order_by(&[("id", true)]).limit(5))   // branch picks its top 5
    .fetch(&pool).await?;
Tri-dialektisch: PostgreSQL + SQLite unterstützen alle vier Operatoren auf jeder Version, die Rustango unterstützt. MySQL 8.0+ unterstützt UNION/UNION ALL; INTERSECT/EXCEPT kamen in MySQL 8.0.31 dazu. Ältere MySQL-Versionen liefern den Syntaxfehler des Treibers zur Fetch-Zeit — es gibt kein clientseitiges Gate.
Fehlerpfad auf dem typisierten Builder: .union(other_qs) (und .intersection() / .difference()) kompiliert den Zweig sofort und panickt, wenn der Zweig sich nicht kompilieren lässt (falsch geschriebene Spalte etc.). Für fehlbare Komposition, bei der der Aufrufer ein Result will, kompiliere den Zweig zuerst und übergib ihn per .with_compound(SetOp::Union, branch) — ein generischer Einstiegspunkt deckt jeden Operator ab. Die Panic-Form ist Absicht: ein fehlerhafter Zweig ist ein Programmierfehler, keine Laufzeit-Datenbedingung.
Große Ergebnismengen streamen
Verarbeite eine riesige Tabelle, ohne sie komplett in den Speicher zu laden. Rufe .iterator(chunk_size) auf; es holt chunk_size Zeilen auf einmal (per LIMIT N OFFSET M) und puffert nie die gesamte Ergebnismenge. Greif danach bei Millionen-Zeilen-Exporten, ETL-Pipelines und Batch-Jobs.
// 1. Whole-chunk loop — process N rows at a time.
let mut iter = Post::objects()
    .where_(Post::published.eq(true))
    .order_by(&[("id", false)])
    .iterator(2_000)?;
while let Some(chunk) = iter.next_chunk(&pool).await? {
    for post in chunk { /* … */ }
}

// 2. Row-by-row loop — buffer one chunk internally, yield one row.
let mut iter = Post::objects().order_by(&[("id", false)]).iterator(2_000)?;
while let Some(post) = iter.next_row(&pool).await? {
    /* … */
}
Setze ein order_by. OFFSET gegen eine Abfrage ohne stabile Sortierung liefert über Chunks hinweg unvorhersehbare Zeilen — typischerweise .order_by(&[("pk", false)]), sodass jeder Chunk sauber weitermacht. Die Methode erzwingt keine Sortierung (manche Abfragen wollen legitimerweise keine Sortierung, z. B. ein einmaliges Leeren), aber unsortierte Iteration ist eine Fußfalle.
Kompromiss gegenüber serverseitigen Cursorn. Das ist ein einfacher LIMIT/OFFSET-Chunker. Auf einer btree-indizierten Sortierspalte scannt PostgreSQL die ersten N Zeilen, bevor es die (N+1)-te zurückgibt — tiefe Paginierung ist also O(n²) Gesamtarbeit. Für ein 10M-Zeilen-Leeren ist das relevant; für 100k Zeilen meistens nicht. Der Chunker gewinnt bei Portabilität (funktioniert auf allen Backends ohne Transaktions-Overhead) und Einfachheit (kein Verwalten eines Cursor-Lebenszyklus). Für wirklich streamende Reads auf PG steig auf rohes sqlx auf einer gehaltenen Verbindung um (pool.acquire(), dann sqlx::query(...).fetch(...) auf dem Postgres-Zweig von conn.conn()) — das erweiterte Protokoll streamt vom Server ohne Offset-Reseek.
next_chunk und next_row auf demselben Iterator zu mischen ist sicher. Der interne VecDeque-Puffer leert sich in Zeilenreihenfolge vor jedem neuen DB-Fetch, sodass next_chunk nach einem partiellen next_row-Leeren zuerst die verbleibenden gepufferten Zeilen liefert und dann mit frischen Chunks fortfährt.
Sowohl .rows_seen() (kumulierter Zähler) als auch .is_exhausted() (Post-Drain-Flag) sind für Fortschrittsmeldung und Terminierungsprüfungen verfügbar.
Gefahr bei gleichzeitigem Schreiben. Jeder Chunk ist eine separate Abfrage, sodass zwischen Chunks eingefügte/gelöschte Zeilen übersprungen oder dupliziert werden können (das klassische "Windowing"-Problem der OFFSET-Paginierung). Für nur-lesbare / nur-anfügende Tabellen — den typischen Export-Anwendungsfall — ist das kein Thema. Für Tabellen, die gleichzeitig beschrieben werden, führe die Schleife in einem atomic-Block auf demselben Pool aus: Jeder Chunk läuft dann auf der Transaktion des Blocks und blättert nach Primärschlüssel (siehe unten). Mit einem transaction_pool-Handle, das ChunkedIter nicht annimmt, rolle den gechunkten SELECT gegen die Transaktion von Hand aus:
let mut tx = rustango::sql::transaction_pool(&pool).await?;
rustango::sql::raw_execute_tx(&mut tx, "SET TRANSACTION ISOLATION LEVEL REPEATABLE READ", vec![])
    .await?;

// Hand-loop LIMIT/OFFSET chunks against the tx with `.fetch_on(&mut tx)`,
// so every chunk reads from the same snapshot.
let chunk_size = 2_000_i64;
let mut offset = 0_i64;
loop {
    let rows: Vec<Post> = Post::objects()
        .order_by(&[("id", false)])
        .limit(chunk_size)
        .offset(offset)
        .fetch_on(&mut tx)
        .await?;
    if rows.is_empty() { break; }
    for post in &rows { /* … */ }
    if (rows.len() as i64) < chunk_size { break; }
    offset += rows.len() as i64;
}
tx.commit().await?;
In einem atomic-Block. Mit dem Pool des Blocks läuft jeder Chunk auf der Transaktion des Blocks: Er sieht die Schreibvorgänge des Blocks, behält die Zeilensperren von .select_for_update() bis zum Commit und blättert nach Primärschlüssel (WHERE pk > last) statt mit OFFSET, sodass Zeilen, die die Schleife aus dem Filter schiebt, nicht übersprungen werden. Das Queryset muss nach dem Primärschlüssel sortiert sein (in beide Richtungen) oder gar nicht, den Primärschlüssel auswählen und darf keine Mengenoperation sein; sonst liefert next_chunk ExecError::InAtomic. Siehe Transaktionen.
Außerhalb eines Blocks propagiert select_for_update() nicht über Chunks hinweg. Zeilensperren werden am Ende der impliziten Transaktion jedes Chunks freigegeben. Für ein gesperrtes Leeren auf einem transaction_pool-Handle hast du zwei Wege, jeder mit einem Kompromiss:
- Ganzes-Ergebnis
.fetch_on(&mut tx)— ein einziger Roundtrip, vollesVec<T>im Speicher. In Ordnung, wenn das Ergebnis passt. - Handgerolltes LIMIT/OFFSET innerhalb der Transaktion — dieselbe Form wie das Snapshot-Isolation-Snippet oben; Chunks bleiben gestreamt, aber du bist außerhalb der
ChunkedIter-API.
chunk_size muss > 0 sein. Null oder negative Werte panicken. Wähle einen Wert, der zu deinem Zeilengrößen-Budget passt (2000 ist ein guter Ausgangspunkt für schmale Zeilen, niedriger für breite TEXT/JSONB-Spalten).
Bestimmte Spalten auswählen
Hol nur ein paar Spalten statt ganzer Post-Structs, über .values(...) und .values_list(...). Verwende diese, wenn du nur ein paar Spalten aus einer breiten Tabelle brauchst, oder wenn das Ergebnis dynamischen Code speist (Templates, CSV-Export, JSON). Du bekommst Maps, Tupel oder eine flache typisierte Liste zurück statt Model-Instanzen.
use rustango::core::SqlValue;
use std::collections::HashMap;

// 1. Column-keyed map per row.
let rows: Vec<HashMap<String, SqlValue>> = Post::objects()
    .where_(Post::published.eq(true))
    .order_by(&[("id", false)])
    .values_dict(&["id", "title"])
    .fetch(&pool).await?;

// 2. Ordered tuple per row.
//    Cell ordering matches the column-list argument.
let rows: Vec<Vec<SqlValue>> = Post::objects()
    .values_list(&["title", "id"])  // title first, id second
    .fetch(&pool).await?;

// 3. Single-column typed scalar.
//    Returns Vec<U> directly via sqlx's typed scalar path.
let ids: Vec<i64> = Post::objects()
    .where_(Post::published.eq(true))
    .values_list_flat("id")
    .fetch::<i64>(&pool).await?;
Drei Builder, eine IR. Alle drei setzen SelectQuery::projection auf die validierte Spaltenliste — das SQL ist über die drei terminalen Formen identisch; nur das Zeilen-Decode unterscheidet sich:
| Builder | SQL-Form | Gibt zurück |
|---|---|---|
.values_dict(&[cols]) | SELECT col1, col2 FROM … | Vec<HashMap<String, SqlValue>> |
.values_list(&[cols]) | SELECT col1, col2 FROM … | Vec<Vec<SqlValue>> (geordnet nach cols) |
.values_list_flat(col) | SELECT col FROM … | Vec<U> (typisiert, über fetch::<U>(...)) |
Funktioniert mit dem Rest der Query-Kette. .where_(), .filter(), .order_by(), .limit(), .offset() und die Mengenoperatoren (.union() / .intersection() / .difference()) — jede Methode, die VOR .values_* aufgerufen wird, wird übernommen. Die Values-Builder sind terminal (nichts verkettet danach), also setze zuerst die Query-Form und fetche dann. Eine Mengenoperation, die nach einer Spalte außerhalb der Projektion sortiert, vergleicht diese Spalte mit und lässt sie dann aus den Zeilen weg.
Validierung zur .compile()- / .fetch()-Zeit:
- Leere Spaltenliste (
.values_dict(&[])) → [QueryError::EmptyValuesProjection]. - Falsch geschriebener Spaltenname (
.values_dict(&["nope"])) → [QueryError::UnknownField].
Tri-dialektisch: identische Projektions-Emission über PG / MySQL / SQLite (nur das Identifier-Quoting unterscheidet sich). Für .values_list_flat::<U>(...) muss U sqlx' Decode + Type auf jedem Backend implementieren, das die Binary anvisiert — gängige Auswahlen (i64, i32, String, bool, f64) funktionieren universell.
Warum das bestehende .values() nicht auf reine Projektion umstellen? QuerySet::values(cols) befördert bereits zum [AggregateBuilder] für den GROUP-BY-Auto-Inferenzpfad. Ein Umbenennen würde ~20 bestehende Aufrufstellen brechen. Die neuen .values_dict() / .values_list() / .values_list_flat()-Ketten-Methoden stehen daneben und lassen den Aggregatpfad unangetastet. Der vorbestehende QueryError::ValuesRequiresAggregate-Fehler feuert weiterhin für .values(cols).compile() ohne ein nachfolgendes .annotate(...) — seine Meldung verweist Aufrufer jetzt auf die neuen Reine-Projektion-Methoden.
Spalten einschließen oder ausschließen
Dieselbe Idee wie im vorherigen Abschnitt, aber als Einschluss-/Ausschluss-Paar: .only('id', 'name') behält nur die genannten Spalten, .defer('big_field') behält alles außer ihnen. Verwende diese bei breiten Tabellen, wo große TEXT / BLOB / JSONB-Spalten Listenansichten teuer im Lesen machen:
// .only(...) — fetch only the named columns.
let rows: Vec<HashMap<String, SqlValue>> = Post::objects()
    .where_(Post::published.eq(true))
    .only(&["id", "title"])
    .fetch(&pool).await?;

// .defer(...) — fetch everything except the named columns.
// Useful for "list view: skip body / metadata / large JSON".
let rows: Vec<HashMap<String, SqlValue>> = Post::objects()
    .defer(&["body", "raw_html"])
    .fetch(&pool).await?;
Semantik: .only(&[cols]) ist ein Synonym für .values_dict(cols) — gleiche IR, gleiche Rückgabeform, separater Einstiegspunkt der Lesbarkeit halber. .defer(&[cols]) berechnet das Komplement gegen das Model-Schema (jede Skalarspalte des Models AUSSER den aufgelisteten) und leitet auf denselben Pfad.
Vorbehalt — die Rückgabe ist kein Model. Es gibt keine teilweise hydrierten Model-Instanzen, die fehlende Felder beim Attributzugriff nachladen; die Rückgabeform ist Vec<HashMap<String, SqlValue>> (oder Vec<Vec<SqlValue>>, wenn du stattdessen .values_list(...) einwechselst). Typisiertes Teilzeilen-Decode ist für eine zukünftige Iteration vorgemerkt.
Tippfehlersicherheit: .defer(&["nope_col"]) liefert QueryError::UnknownField zur .compile()-Zeit — der Tippfehler verwandelt sich nicht stillschweigend in "alle Spalten projizieren". .only(&[]) liefert QueryError::EmptyValuesProjection; .defer(&[]) ist eine semantische No-op (projiziert jede Spalte).
Mit regulären Ausdrücken abgleichen
Gleiche eine Spalte gegen ein Regex-Muster ab, über die Lookups __regex / __iregex. .regex() ist case-sensitiv, .iregex() case-insensitiv, und .not_regex() / .not_iregex() sind die negierten Formen.
use rustango::core::Column as _;

// Names starting with "al" (case-sensitive).
User::objects()
    .where_(User::name.regex("^al.*"))
    .fetch(&pool).await?;

// Names starting with "al" — case-insensitive.
User::objects()
    .where_(User::name.iregex("^al.*"))
    .fetch(&pool).await?;

// Negated: exclude names starting with "admin" (case-sensitive).
User::objects()
    .where_(User::name.not_regex("^admin"))
    .fetch(&pool).await?;

// Lookup-suffix string form.
User::objects()
    .filter("name__iregex", "^bob")
    .fetch(&pool).await?;
Tri-dialektische Emission:
| Dialekt | Case-sensitiv | Case-insensitiv | Hinweise |
|---|---|---|---|
| PostgreSQL | <col> ~ ? / <col> !~ ? | <col> ~* ? / <col> !~* ? | Native POSIX-Operatoren |
| MySQL | `col` REGEXP CONCAT('(?-i)', ?) / NOT REGEXP | `col` REGEXP CONCAT('(?i)', ?) / NOT REGEXP | Inline-Flag (ICU/PCRE), unabhängig von der Kollation |
| SQLite | "col" REGEXP ? / "col" NOT REGEXP ? | "col" REGEXP ('(?i)' || ?) / NOT REGEXP | Braucht die regexp-User-Funktion auf der Verbindung geladen |
SQLite benötigt eine registrierte regexp-User-Funktion — sie ist nicht eingebaut. sqlx-sqlite 0.8 registriert standardmäßig keine. Zwei Wege, sie zu aktivieren:
- Einfach — aktiviere sqlx-sqlites
regexp-Cargo-Feature, dann opte die Verbindung ein:use sqlx::sqlite::SqliteConnectOptions; let opts = SqliteConnectOptions::new() .filename("app.db") .with_regexp(); // gated on sqlx-sqlite/regexp - Manuell — registriere einen Rust-Closure über
SqliteConnection::lock_handle()+ rohes FFI (sqlite3_create_function_v2).
Ohne eine solche emittiert die Abfrage valides REGEXP-SQL, das SQLite bei der Ausführung mit no such function: regexp ablehnt (parser-sauber — tests/regex_sqlite_live.rs nagelt das fest).
Der Muster-Dialekt unterscheidet sich zwischen Backends. PostgreSQL verwendet POSIX-Extended-Regex; MySQL verwendet ICU-basiertes Regex mit eigenem Geschmack; SQLite delegiert an das, was die User-Funktion implementiert (typischerweise Rusts regex-Crate). Muster, die auf dialektspezifische Syntax setzen (z. B. PGs \m / \M Wortgrenzen), sind nicht rundlauffähig — halte dich an die portable Teilmenge (^, $, ., *, +, ?, [...], (), |), wenn dasselbe Model von mehreren Backends abgefragt wird.
Nicht-String-Werte werden bei .compile() abgelehnt — das Übergeben von SqlValue::I64(42) an __regex liefert QueryError::InvalidLookupValue { suffix: "regex", expected: "SqlValue::String(<regex pattern>)", … } statt stillschweigend zu casten.
Berechnete Werte & Datenbankfunktionen
Lass die Datenbank Dinge berechnen, statt Zeilen in die App zu ziehen, sie zu mutieren und zurückzuschreiben. F("col") verweist auf eine Spalte per Name, und die funcs::*-Builder umschließen skalare SQL-Funktionen wie LOWER oder COALESCE. Zusammen schalten sie drei Muster frei, die reines wertbasiertes .set() / .where_() nicht ausdrücken kann:
Atomare Inkremente (kein Read-Modify-Write-Race)
Der klassische Zähler-Bug — eine Zeile holen, ein Feld hochzählen, speichern — verliert Updates, wenn zwei Requests gleichzeitig laufen. F("col") + 1 fasst den Roundtrip zu einem einzigen UPDATE zusammen, sodass die Datenbank die Zeilensperre für dich hält:
use rustango::core::F;
use rustango::sql::UpdaterPool as _;

Post::objects()
    .eq("id", post_id)
    .update()
    .set_expr("view_count", F("view_count") + 1_i64)
    .execute_pool(&pool).await?;
Tri-dialektisch: emittiert views = ("views" + $1) auf PG, views = (`views` + ?) auf MySQL, identisch auf SQLite. Die Arithmetik wird geklammert, damit verschachtelte Operationen eindeutig bleiben: F("a") + F("b") * 2.
Unterstützte Operatoren: + - * / % plus & | ^ << >> (bitweise; XOR auf SQLite emittiert ein klares OpNotSupportedInDialect, da SQLite kein XOR-Symbol hat).
Zwei Spalten in einem Filter vergleichen
Filtere eine Spalte gegen eine andere, nicht gegen ein Literal — z. B. Reservation start_date < end_date, um eine Zeile auf Plausibilität zu prüfen, oder Inventory available > reserved, um Zeilen mit Kapazität zu finden:
use rustango::core::Column as _;

// `start_date < end_date` for every selected row.
let valid = Reservation::objects()
    .where_(Reservation::start_date.lt_expr(F("end_date")))
    .fetch(&pool).await?;

// Combine with literal predicates.
let oversold = Inventory::objects()
    .where_(Inventory::available.lt_expr(F("reserved")))
    .where_(Inventory::active.eq(true))
    .fetch(&pool).await?;
Die *_expr-Familie — eq_expr, ne_expr, lt_expr, lte_expr, gt_expr, gte_expr — spiegelt die literalen eq, ne, …-Methoden, nimmt aber auf der rechten Seite jedes impl Into<Expr>: nackte Spaltenreferenzen (F("col")), Arithmetik (F("price") * 2) oder Funktionsergebnisse (nächster Abschnitt).
Skalare Funktionen — Text, Mathematik, NULL-Behandlung
rustango::core::funcs liefert Builder für die meistgenutzten SQL-Funktionen. 72 skalare Builder. Die meistgenutzten, gruppiert:
| Gruppe | Builder |
|---|---|
| Text | lower, upper, length, trim, ltrim, rtrim, concat, substr, replace |
| Mathematik | abs, ceil, floor, round (1-arg) / round_to (2-arg-Präzision) |
| NULL | coalesce, greatest, least, nullif |
use rustango::core::funcs::{lower, upper, concat, coalesce, trim, abs, round};
use rustango::core::F;
use rustango::sql::UpdaterPool as _;

// Normalize on write.
User::objects()
    .eq("id", id)
    .update()
    .set_expr("email", lower(trim(F("email"))))
    .execute_pool(&pool).await?;

// Build a derived column from two FKs + a literal.
User::objects()
    .update()
    .set_expr(
        "display_name",
        concat([F("first").into(), " ".into(), F("last").into()]),
    )
    .execute_pool(&pool).await?;

// First non-NULL fallback.
User::objects()
    .update()
    .set_expr(
        "label",
        coalesce([F("nickname").into(), F("username").into(), "anonymous".into()]),
    )
    .execute_pool(&pool).await?;

// Function on the WHERE rhs.
User::objects()
    .where_(User::email_norm.eq_expr(lower(F("email_norm"))))
    .fetch(&pool).await?;

// Functions compose freely — `abs(round(F("score") * 100))` is one Expr.
Player::objects()
    .update()
    .set_expr("score_int", abs(round(F("score") * 100_f64)))
    .execute_pool(&pool).await?;
Tri-dialektisches Verhalten
Die meisten Funktionen emittieren über PG / MySQL / SQLite identisches SQL. Die divergierenden Formen werden pro Dialekt transparent behandelt:
| Builder | PG | MySQL | SQLite |
|---|---|---|---|
concat([a, b]) | CONCAT(a, b) | CONCAT(a, b) | (a || b) |
substr(s, 1, 3) | SUBSTRING(s FROM 1 FOR 3) | SUBSTRING(s, 1, 3) | SUBSTR(s, 1, 3) |
greatest([a, b]) | GREATEST(a, b) | GREATEST(a, b) | MAX(a, b) skalar |
least([a, b]) | LEAST(a, b) | LEAST(a, b) | MIN(a, b) skalar |
Gemischte Argumente an eine Funktion übergeben
Funktionen, die eine Liste von Argumenten nehmen (wie concat), akzeptieren jedes iterierbare von Expr. Rust-Arrays müssen einen Typ enthalten, sodass ein Mix aus F (Spalte) und &str (Literal) allein nicht typprüfen wird — rufe .into() einmal pro Element auf, um jedes in ein Expr zu heben:
concat([F("first").into(), " ".into(), F("last").into()])
//          ^^^^^^ each element lifted to Expr
Oder baue ein Vec<Expr> und übergib es direkt — gleiche Form, gleiches Ergebnis.
Vorbehalte
lengthByte-vs-Zeichen: PG gibt Zeichen beiTEXT/VARCHARzurück, MySQL gibt Bytes zurück (verwende den zukünftigenCharLength-Builder des Frameworks oder umschließe manuell mitCHAR_LENGTH, wenn du dialektübergreifende Zeichenzählungen brauchst).round(x, n)auf PG: PGs 2-arg-Form erfordertnumeric, nichtdouble. Übergib entweder eine Integer-Spalte oder caste den Float zuerst; MySQL und SQLite akzeptieren beide Typen.greatest([single_arg])/least([single_arg])auf SQLite: nicht unterstützt — SQLitesMAX(x)mit einem Argument ist die Aggregat-, nicht die skalare Form. Der Writer gibtOpNotSupportedInDialectzurück. PG und MySQL akzeptieren die Ein-Argument-Form als No-op, diexzurückgibt. Umschließe mit mindestens einem Literal, um portabel zu bleiben.substrmit negativem Start: PG behandelt negativ als "starte ab Zeichenposition N" (klemmt effektiv auf 0); MySQL und SQLite behandeln negativ als "zähle vom Ende". Vermeide negative Starts in portablem Code.
Datums- & Zeitfunktionen
Die now()-, extract_*- und trunc_*-Builder arbeiten auf Daten und Zeitstempeln. Verwende sie für Kohortenabfragen, Zeitbucket-Aggregate und das Stempeln der aktuellen Zeit beim Schreiben — alles in der Datenbank, ohne Zeilen durch die App zu roundtrippen.
use rustango::core::funcs::{
    now, trunc_date, trunc_month,
    extract_year, extract_month, extract_weekday,
};
use rustango::core::F;

// 1. Stamp server-side current time on write.
Post::objects()
    .eq("id", id)
    .update()
    .set_expr("published_at", now())
    .execute_pool(&pool).await?;

// 2. Extract year / month / weekday into denormalized indexable
// columns so cohort + day-of-week queries are cheap.
Signup::objects()
    .update()
    .set_expr("bucket_year", extract_year(F("created_at")))
    .set_expr("bucket_month", extract_month(F("created_at")))
    .set_expr("weekday", extract_weekday(F("created_at")))
    .execute_pool(&pool).await?;

// 3. Filter on the stored bucket — typed integer comparison, uses
// the index, portable across all three dialects.
let friday_signups = Signup::objects()
    .where_(Signup::weekday.eq(5_i64))            // 5 = Friday (0=Sun)
    .fetch(&pool).await?;

// 4. For range filters where you'd be tempted to write
// `created_at >= trunc_year(now())` directly: don't. The function
// builders for `Trunc*` return text on MySQL/SQLite (see caveats
// below), so a column-vs-trunc comparison in WHERE only behaves
// well on PG. Compute the boundary in Rust instead and pass it as a
// typed literal — works the same on every backend and uses the
// index on `created_at`:
use chrono::{Datelike, TimeZone};
use rustango::sql::UpdaterPool as _;
let this_year = chrono::Utc::now().year();
let year_start = chrono::Utc.with_ymd_and_hms(this_year, 1, 1, 0, 0, 0).unwrap();

let recent = Order::objects()
    .where_(Order::created_at.gte(year_start))
    .fetch(&pool).await?;

// 5. `Trunc*` shines on the *write* side. `trunc_date` is the
// one trunc-family builder with identical SQL on every dialect
// (`DATE(x)`) — handy for grouping by day without the type-divergence
// caveat the year/month variants carry.
Order::objects()
    .update()
    .set_expr("day_bucket", trunc_date(F("created_at")))     // DATE column on every backend
    .set_expr("month_bucket", trunc_month(F("created_at")))  // see caveat
    .execute_pool(&pool).await?;
// `month_bucket` should be `TIMESTAMPTZ` on PG and `VARCHAR(10)` /
// `TEXT` on MySQL/SQLite — parse client-side when reading if you
// need a typed `chrono::NaiveDate`.
Emission pro Dialekt:
| Builder | PG | MySQL | SQLite |
|---|---|---|---|
now() | NOW() | NOW() | CURRENT_TIMESTAMP |
extract_year(x) | CAST(EXTRACT(YEAR FROM x) AS INTEGER) | YEAR(x) | CAST(strftime('%Y', x) AS INTEGER) |
extract_week(x) | EXTRACT(WEEK FROM x) — ISO 8601, Bereich 1–53 | WEEK(x, 3) — ISO 8601 | ISO 8601, ab dem Donnerstag der Woche |
extract_weekday(x) | CAST(EXTRACT(DOW FROM x) AS INTEGER) | (DAYOFWEEK(x) - 1) | CAST(strftime('%w', x) AS INTEGER) |
extract_quarter(x) | EXTRACT(QUARTER FROM x) | QUARTER(x) | nicht unterstützt — Fehler |
trunc_date(x) | DATE(x) | DATE(x) | DATE(x) |
trunc_year(x) | DATE_TRUNC('year', x) → Zeitstempel | DATE_FORMAT(x, '%Y-01-01') → String | strftime('%Y-01-01', x) → String |
trunc_month(x) | DATE_TRUNC('month', x) → Zeitstempel | DATE_FORMAT(x, '%Y-%m-01') → String | strftime('%Y-%m-01', x) → String |
trunc_day(x) | DATE_TRUNC('day', x) → Zeitstempel | DATE(x) → Datum | date(x) → Text |
Vorbehalte speziell für Datum/Zeit:
trunc_year/month-Rückgabetyp divergiert: Zeitstempel auf PG, Text auf MySQL/SQLite. Caste auf App-Seite beim Lesen, wenn du ein typisierteschrono::NaiveDatebrauchst — oder speichere den Bucket als schlichten Integer (extract_year+extract_month) und rekonstruiere im Code.extract_weekdayist auf 0 = Sonntag normalisiert über alle drei Dialekte. MySQLs nativesDAYOFWEEK()gibt 1=Sonntag zurück, also subtrahiert der Writer 1.extract_weekund__weekliefern die ISO-8601-Woche (Montagsbeginn, 1–53) auf allen drei Dialekten: 2023-01-01 ist Woche 52.extract_quarterauf SQLite wirft einen Fehler mitOpNotSupportedInDialect— SQLite hat kein natives Quartals-Token. Gate das Feature entweder hintercfg(not(sqlite))oder berechne per((extract_month - 1) / 3) + 1im App-Code.- Zeitzonen-Behandlung: PG
EXTRACToperiert in der Zeitzone der Spalte; MySQLYEAR()operiert in der Sitzungs-Zeitzone (SET time_zone = ...); SQLite hat keine echte TZ-Unterstützung — behandle alles als UTC. VerwendeTIMESTAMPTZauf PG,DATETIMEauf MySQL mit gesetzter Sitzungs-TZ, ISO-8601-Strings auf SQLite.
CASE-WHEN-Ausdrücke
Baue ein SQL CASE WHEN … THEN … ELSE … END mit den case() / .when() / value()-Buildern. Verwende es für benutzerdefinierte Sortierungen, abgeleitete Spalten in annotate, berechnete Defaults in update und (gepaart mit Sum) bedingte Aggregate.
use rustango::core::case::{case, value};
use rustango::core::{Column as _, F};
use rustango::core::funcs::lower;
use rustango::sql::UpdaterPool as _;

// Custom ordering — published posts first, drafts last.
Post::objects()
    .update()
    .set_expr(
        "priority",
        case()
            .when(Post::status.eq("published"), 0_i64)
            .when(Post::status.eq("review"), 1_i64)
            .when(Post::status.eq("draft"), 2_i64)
            .default(99_i64),
    )
    .execute_pool(&pool).await?;

let ordered = Post::objects()
    .order_by(&[("priority", false), ("id", false)])
    .fetch(&pool).await?;

// Computed default on update — drafts get a lowercased title for
// the label, everything else uses the title verbatim.
Post::objects()
    .update()
    .set_expr(
        "label",
        case()
            .when(Post::status.eq("draft"), lower(F("title")))
            .default(F("title")),
    )
    .execute_pool(&pool).await?;

// AND / OR composition in the WHEN predicate.
let viral = Post::status.eq("published").and(Post::views.gt(1_000_i64));
Post::objects()
    .update()
    .set_expr(
        "label",
        case()
            .when(viral, value("viral"))
            .when(Post::status.eq("published"), value("live"))
            .default(value("pending")),
    )
    .execute_pool(&pool).await?;
Builder-Form:
case()— startet einen Builder..when(condition, then)— hängt einen Zweig an.conditionist allesInto<WhereExpr>(typischerweiseColumn::eq(),.and(),.or());thenist allesInto<Expr>(Literal,F(), Funktionsaufruf, verschachteltescase())..default(expr)— setzt den optionalenELSE-Zweig. Ihn wegzulassen erzeugt einCASE, dasNULLfür nicht passende Zeilen zurückgibt (SQL-Standard)..build()oder.into()— finalisiert zu einemExprfürset_expr/eq_expr/annotate.value(literal)— Kurzform fürExpr::Literal(...). Optional — nackte Literale werden perInto<Expr>gecoerct, abervalue("…")liest sich explizit als "das ist ein String-Literal, keine Spaltenreferenz".
Tri-dialektische Emission:
CASE WHEN … THEN … [ELSE …] END ist SQL-92-Standard — über PG, MySQL und SQLite identisch emittiert. Kein Dialekt-Dispatch im Writer.
Vorbehalte:
- Leere Zweige:
case().build()ohne.when(...)-Aufrufe wird zur Emit-Zeit mitSqlError::EmptyCaseBranchesabgelehnt. SQL erfordert mindestens eineWHEN-Klausel. Eine leereWHEN-Bedingung (z. B.WhereExpr::And(vec![])) wird aus demselben Grund mitSqlError::EmptyCaseWhenConditionabgelehnt. - Typvereinheitlichung über Zweige: jeder Dialekt wählt einen gemeinsamen Typ aus den
THEN- undELSE-Werten. Das Mischen von Typen (THEN 1_i64+ELSE "string") kann einen Laufzeit-Cast-Fehler werfen oder überraschend coercen. Halte dich an einen Typ proCASE. - Performance: jede Zeile wertet
WHEN-Prädikate der Reihe nach aus, bis eines passt (First-Match-Wins, pro Zeile). Die Kosten wachsen mit der Anzahl der Zweige und den Kosten der Prädikate. Für viele feste String-Mappings kann ein Join gegen eine kleine Lookup-Tabelle günstiger und lesbarer sein.
Unterabfragen (EXISTS, IN, skalar)
Bette eine Abfrage in eine andere ein, mit den Buildern Exists, Subquery und OuterRef. Diese Builder decken die meisten "existiert eine verwandte Zeile?"- und "ist dieser Wert in dieser Menge?"-Muster ab:
| Builder | Form | Verwende es für |
|---|---|---|
exists(qs) | EXISTS (SELECT … FROM …) | "Autoren, die mindestens ein Buch haben" |
not_exists(qs) | NOT EXISTS (SELECT …) | "Autoren ohne Bücher" (Anti-Join) |
in_subquery(col, qs) | <col> IN (SELECT …) | "Posts in irgendeiner öffentlichen Kategorie" |
not_in_subquery(col, qs) | <col> NOT IN (SELECT …) | Umkehrung des obigen |
subquery(qs) | (SELECT …) als Skalar | Berechneter Default in set_expr |
outer_ref(col) | "<outer_table>"."<col>" | Verweise auf die äußere Zeile von innerhalb jedes der obigen |
use rustango::core::subquery::{exists, not_exists, in_subquery, outer_ref};
use rustango::core::{Column as _, WhereExpr};

// "Authors with no books" — the canonical anti-join. Build the inner
// queryset first so its compile() catches typos; embed via not_exists.
let no_books = Book::objects()
    .where_(Book::author_id.eq_expr(outer_ref("id")))
    .compile()?;
let orphans = Author::objects()
    .where_raw(not_exists(no_books))
    .fetch(&pool).await?;

// "Authors who have a published book of more than 100 pages" — the
// inner predicate combines a correlation (outer_ref) with literal
// filters in the same WHERE.
let inner = Book::objects()
    .where_(Book::author_id.eq_expr(outer_ref("id")))
    .where_(Book::status.eq("published"))
    .where_(Book::pages.gt(100_i64))
    .compile()?;
let long_writers = Author::objects()
    .where_raw(exists(inner))
    .fetch(&pool).await?;

// Compose EXISTS with an OR.
let inner = Book::objects()
    .where_(Book::author_id.eq_expr(outer_ref("id")))
    .compile()?;
let featured = Author::objects()
    .where_raw(WhereExpr::Or(vec![
        Author::name.eq("Carol").into(),
        exists(inner),
    ]))
    .fetch(&pool).await?;
Verschachtelte Korrelation funktioniert. Ein OuterRef innerhalb einer doppelt verschachtelten Unterabfrage löst zum unmittelbar umschließenden Scope auf — der Writer pflegt beim Absteigen einen Scope-Stack, sodass EXISTS (Book WHERE id = outer.id AND EXISTS (Comment WHERE book_id = outer.id)) das innere outer.id zu Book.id auflöst, nicht zum äußersten Author.id. Verwende outer_ref(...) zweimal, wenn du wirklich zwei Scopes nach oben reichen musst.
Fehler:
OuterRefOutsideSubquery—outer_ref("col")auf oberster Ebene zu emittieren (nicht innerhalb eines Unterabfrage-Wrappers) ist ein Programmierfehler. Der Writer wirft das laut mit dem Spaltennamen, sodass die Aufrufstelle leicht zu finden ist.
Vorbehalte:
IN (SELECT …)-Projektionsverengung: PG erfordert strikt, dass der innere SELECT genau eine Spalte für die<col> IN (…)-Form projiziert. Verenge das innere Queryset mitvalues_list_flat:in_subquery("id", Book::objects().values_list_flat("author_id").compile()?)projiziert auf jedem Backend nurauthor_id. Ein einfachesQuerySet::compile()projiziert jede Model-Spalte, übergib es also nur bei einem einspaltigen Model.- Skalares
subquery(...)erfordert ein Ein-Spalte-eine-Zeile-Inneres: das emittierte SQL istSET col = (SELECT …)— produziert das Innere mehr als eine Zeile, wirft die Datenbank zur Laufzeit einen Fehler. Beschränke per.limit(1)und entweder verenge die Projektion mitvalues_list_flatoder gestalte das Innere um eine Eindeutigkeits-Invariante. - Kompilierzeit-Validierung der Unterabfrage lebt auf dem inneren Queryset: Spalten-Tippfehler tauchen beim inneren
queryset.compile()?-Aufruf auf, nicht beimcompile()der äußeren Abfrage. Baue das Innere zuerst und propagiere?.
Wann man stattdessen auf rohes SQL zurückfällt
Die Tabelle oben ist eine Auswahl, nicht der ganze Satz. funcs hat außerdem cast, die Volltext-Familie (to_tsvector, plainto_tsquery, websearch_to_tsquery, ts_rank, ts_headline), JSON-Pfade (json_path, json_path_indexed, json_array_length) und Hashes (md5, sha1, sha256). Fensterfunktionen sind ein eigenes Modul, rustango::core::window, unten dokumentiert. Trigonometrische Funktionen sind die auffällige Lücke — dafür und für alles andere, was der Ausdrucksbaum nicht erreicht, siehe den Abschnitt Raw-SQL-Notausgang weiter unten.
Aggregationen
Zeilen zählen, summieren, mitteln und gruppieren. .count(), .sum(), .avg(), .min() und .max() geben eine einzelne Zahl zurück; .annotate(...) plus .values(...) baut GROUP-BY-Abfragen. Aggregatergebnisse kommen als Vec<HashMap<String, SqlValue>> zurück statt als typisierte Structs, da die Form dynamisch ist.
use rustango::sql::CounterPool as _;

// COUNT
let n = Post::objects()
    .where_(Post::status.eq("published"))
    .count(&pool).await?;

// SUM / AVG / MIN / MAX — string column name; each returns Option<U>
// (None when the filtered result set is empty).
let total_views = Post::objects().sum::<i64>("view_count", &pool).await?;
let avg_views = Post::objects().avg::<f64>("view_count", &pool).await?;
let max_views = Post::objects().max::<i64>("view_count", &pool).await?;

// Annotate + GROUP BY (auto-inferred grouping)
use rustango::core::aggregates::{count_all, sum};

// "Posts per author" — `.values()` lists the GROUP BY columns.
let by_author = Sale::objects()
    .values(&["author_id"])
    .annotate("n", count_all().into())
    .compile()?;
let rows = rustango::sql::fetch_aggregate_dict(&pool, &by_author).await?;
// rows: Vec<HashMap<String, SqlValue>> — { author_id: 1, n: 3 }, …
Wie GROUP BY inferiert wird
Du schreibst GROUP BY selten selbst — Rustango inferiert es aus der Form der Abfrage. Du rufst .group_by(...) nur auf, um diese Inferenz zu überschreiben. Die Tabelle zeigt, was jede Form erzeugt:
| Form | Builder | Resultierendes GROUP BY |
|---|---|---|
| 2 — values + Aggregat | .values(&["author_id"]).annotate("n", count_all().into()) | GROUP BY "author_id" |
| 3 — nacktes Aggregat | .annotate("n", count_all().into()) | GROUP BY jede nicht-aggregierende Skalarspalte des Models |
| Nur Fenster | .aggregate().annotate("rn", row_number()…) | (kein GROUP BY — Fensterfunktionen sind pro Zeile) |
| Explizite Überschreibung | .aggregate().group_by("month").annotate(...) | GROUP BY "month" — explizit gewinnt |
Der Klassifizierer AggregateExpr::is_aggregating() unterscheidet die zeilen-kollabierenden Varianten (Count / Sum / Avg / Max / Min / CountDistinct / StdDev* / Variance* / AnyValue / ArrayAgg / StringAgg / JsonbAgg / RelatedAggregate — plus rekursive Filtered / Coalesced-Wrapper) von Window, das pro Zeile ist. Nur die aggregierenden Varianten lösen die Form-3-Inferenz aus.
use rustango::core::aggregates::{count_all, sum};

// Shape 2 — "monthly revenue per author".
Sale::objects()
    .where_(Sale::status.eq("paid"))
    .values(&["author_id", "month"])
    .annotate("total", sum("amount").into())
    .compile()?;
// → SELECT "author_id", "month", SUM("amount")::bigint AS "total"
//   FROM "sale" WHERE "status" = $1
//   GROUP BY "author_id", "month"

// Shape 3 — a bare .annotate() with no .values(): rustango adds every
// non-aggregate scalar column of the model to the GROUP BY.
Post::objects()
    .annotate("n", count_all().into())
    .compile()?;
// → SELECT <every Post column>, COUNT(*) AS "n"
//   FROM "post" GROUP BY <every Post column>
Reine Projektion. .values(cols) allein (ohne Aggregat-Annotation) gibt QueryError::ValuesRequiresAggregate zurück — dieser Pfad ist für GROUP BY reserviert, und eine Fenster-Annotation erfüllt ihn ebenfalls nicht, da ein Fenster nicht aggregiert. Reine Projektion als Dicts ist ausgeliefert: verwende .values_dict(...), .values_list(...) oder .values_list_flat(...), oben unter Bestimmte Spalten auswählen beschrieben. Die Fehlermeldung selbst nennt sie.
Bedingte & statistische Aggregate
Zähle oder summiere nur die Zeilen, die eine Bedingung erfüllen, liefere einen Fallback für leere Ergebnisse und berechne Standardabweichung / Varianz. Verkette .filter(...) und .default(...) an jeden Aggregat-Builder.
use rustango::core::aggregates::{avg, count, count_all, stddev, sum};
use rustango::core::Column as _;

let rows = Post::objects()
    .aggregate()
    // COUNT(*) FILTER (WHERE is_active AND status = 'published')
    .annotate(
        "active_published",
        count_all()
            .filter(Post::is_active.eq(true).and(Post::status.eq("published")))
            .into(),
    )
    // COALESCE(SUM(price) FILTER (WHERE status = 'published'), 0)
    //   — returns 0 instead of NULL when the queryset is empty.
    .annotate(
        "revenue_or_zero",
        sum("price")
            .filter(Post::status.eq("published"))
            .default(0_i64)
            .into(),
    )
    .annotate("avg_pages", avg("pages").into())
    .annotate("page_stddev", stddev("pages").into())
    .compile()?;
let result = rustango::sql::fetch_aggregate_dict(&pool, &rows).await?;
Builder in rustango::core::aggregates:
| Builder | SQL |
|---|---|
count(col) | COUNT(col) |
count_all() | COUNT(*) |
count_distinct(col) | COUNT(DISTINCT col) |
sum(col) / avg(col) / max(col) / min(col) | das Übliche |
stddev(col) / stddev_pop(col) | STDDEV_SAMP / STDDEV_POP |
variance(col) / variance_pop(col) | VAR_SAMP / VAR_POP |
Jedes gibt einen AggregateBuilder mit zwei verkettbaren Modifikatoren zurück:
.filter(predicate)— umschließe mitFILTER (WHERE predicate). Das Prädikat ist jedesWhereExpr(typisiertes.eq()/.and()/ rohesWhereExpr::Or(...)), sodass es sich genauso komponiert wie ein normales WHERE..default(value)— umschließe mitCOALESCE(..., value), sodass ein leeres Queryset den Default stattNULLzurückgibt.
Beide Ketten als Coalesced außerhalb Filtered aufzurufen: COALESCE(SUM(col) FILTER (WHERE p), 0). Die Kettenreihenfolge spielt keine Rolle — .filter(p).default(0) und .default(0).filter(p) erzeugen dieselbe IR.
Tri-dialektische Emission:
| Feature | PG | MySQL | SQLite |
|---|---|---|---|
Count / Sum / Avg / Max / Min / CountDistinct | ✓ | ✓ | ✓ |
StdDev / StdDevPop / Variance / VariancePop | ✓ | ✓ (8.0+) | ✗ SqlError::AggregateNotSupported |
.filter(...) — natives FILTER (WHERE …) | ✓ | ✗ umgeschrieben | ✓ (3.30+) |
.filter(...) — CASE WHEN-Fallback | — | ✓ <agg>(CASE WHEN … THEN <arg> END) | — |
.default(...) — COALESCE | ✓ | ✓ | ✓ |
Der Writer wendet den Int/Float-Cast des Dialekts (::bigint, CAST(... AS SIGNED) etc.) um den gesamten FILTER-Ausdruck an — SUM(col)::bigint FILTER (...) ist ein PG-Parse-Fehler, sodass die emittierte Form (SUM(col) FILTER (...))::bigint ist. Gleiche Form für STDDEV_SAMP / VAR_SAMP (sie geben NUMERIC auf PG für bigint-Input zurück).
SQLite + StdDev/Variance: SQLite hat keine eingebauten statistischen Aggregate, sodass der Writer mit SqlError::AggregateNotSupported { aggregate, dialect: "sqlite" } ablehnt. Berechne die Varianzformel im App-Code, wenn portable Statistik benötigt wird.
Fensterfunktionen
Berechne laufende Summen, Rankings und Zeile-über-Zeile-Deltas, ohne Zeilen zu kollabieren — über Window(expression, partition_by=, order_by=, frame=). Vierzehn Funktionen (row_number, rank, dense_rank, lag, lead, first_value, last_value, ntile, sum_over, avg_over, min_over, max_over, count_over, count_column_over) plus ROWS/RANGE-Frames. Jedes Backend, das Rustango unterstützt (PG ≥ 9.0, MySQL ≥ 8.0, SQLite ≥ 3.25), liefert native OVER (…)-Syntax, sodass die Emission uniform ist.
use rustango::core::aggregates::max;
use rustango::core::window::{lag, rank, row_number};

// "Rank users by score within each tenant" — the canonical
// integration target.
let q = User::objects()
    .aggregate()
    .group_by("id")
    .group_by("tenant_id")
    .group_by("name")
    .group_by("score")
    .annotate("_a", max("id").into())  // satisfies GROUP BY on the projection
    .annotate(
        "tenant_rank",
        rank().partition_by("tenant_id").order_by(&[("score", true)]).into(),
    )
    .order_by(&[("tenant_id", false), ("score", true)])
    .compile()?;
let rows = rustango::sql::fetch_aggregate_dict(&pool, &q).await?;

// Day-over-day delta via LAG with a default for the first row.
let q = Event::objects()
    .aggregate()
    .group_by("id")
    .group_by("day")
    .group_by("count")
    .annotate("_a", max("id").into())
    .annotate(
        "prev_count",
        lag("count", 1, Some(SqlValue::I64(0)))
            .partition_by("user_id")
            .order_by(&[("day", false)])
            .into(),
    )
    .compile()?;

// Stable row index per group for "show me row N" pagination.
let q = Post::objects()
    .aggregate()
    .group_by("id")
    .group_by("status")
    .group_by("created_at")
    .annotate("_a", max("id").into())
    .annotate(
        "rn",
        row_number()
            .partition_by("status")
            .order_by(&[("created_at", true)])
            .into(),
    )
    .compile()?;
Builder in rustango::core::window:
| Builder | SQL | Argumente |
|---|---|---|
row_number() | ROW_NUMBER() | — |
rank() | RANK() | — |
dense_rank() | DENSE_RANK() | — |
ntile(buckets) | NTILE(buckets) | Bucket-Anzahl |
lag(col, offset, default) | LAG(col, offset, default?) | Spalte + Offset + optionaler Default |
lead(col, offset, default) | LEAD(col, offset, default?) | Spalte + Offset + optionaler Default |
first_value(col) | FIRST_VALUE(col) | Spalte |
last_value(col) | LAST_VALUE(col) | Spalte |
sum_over(col) | SUM(col) | Spalte |
avg_over(col) | AVG(col) | Spalte |
min_over(col) | MIN(col) | Spalte |
max_over(col) | MAX(col) | Spalte |
count_column_over(col) | COUNT(col) | Spalte |
count_over() | COUNT(*) | — |
Jedes gibt einen WindowBuilder mit drei verkettbaren Modifikatoren zurück:
.partition_by("col")— hängt einePARTITION BY-Spalte an. Rufe es mehrmals auf für Mehr-Spalten-Partitionierung..order_by(&[("col", desc)])— hängtORDER BY-Spalten an (desc = true→ DESC)..frame(WindowFrame { kind, start, end })— setzt die optionaleROWS/RANGE-Frame-Klausel.FrameBoundary::UnboundedPreceding/Preceding(n)/CurrentRow/Following(n)/UnboundedFollowing.
Der Builder senkt per Into<AggregateExpr> ab, sodass Fensterfunktionen mit annotate() komponieren. Into<Expr> ist ebenfalls implementiert (der IR-Level-Slot für Fensterausdrücke), aber jedes Backend, das Rustango unterstützt, beschränkt Fensterfunktionen auf die SELECT-Liste und die ORDER BY-Klausel einer Abfrage — sie können nicht in WHERE / HAVING / GROUP BY / UPDATE SET / JOIN ON / RETURNING erscheinen. Der Writer gatet die Emission nicht darauf, sodass set_expr("col", row_number()) zu SQL kompiliert, das die Datenbank bei der Ausführung ablehnt. Baue Fensterausdrücke über annotate(); greif zu einer Unterabfrage, wenn du ein Fensterergebnis in einen WHERE-Filter oder ein UPDATE einspeisen musst.
LAST_VALUE-Default-Frame-Falle:
Ein nacktes last_value(col).order_by(&[("x", false)]) emittiert LAST_VALUE("col") OVER (ORDER BY "x") und sieht aus, als sollte es das letzte col der Partition zurückgeben. Tut es nicht — SQLs Default-Fensterframe ist RANGE BETWEEN UNBOUNDED PRECEDING AND CURRENT ROW, sodass LAST_VALUE den Wert der aktuellen Zeile zurückgibt, nicht der letzten Zeile der Partition. Um das intuitive "letzte Zeile der Partition"-Verhalten zu erhalten, übergib einen expliziten unbegrenzten Frame:
use rustango::core::{FrameBoundary, FrameKind, WindowFrame};

last_value("score")
    .partition_by("tenant_id")
    .order_by(&[("created_at", true)])
    .frame(WindowFrame {
        kind: FrameKind::Rows,
        start: FrameBoundary::UnboundedPreceding,
        end: Some(FrameBoundary::UnboundedFollowing),
    })
first_value hat diese Falle nicht — der Start des Default-Frames stimmt mit dem Partitionsstart überein, sodass die intuitive Antwort herausfällt.
Annotate und GROUP BY:
Ein reines Fenster-annotate() auf .aggregate() erzeugt inzwischen gar kein GROUP BY mehr — Fenster sind pro Zeile, es muss also nichts gruppiert werden. Zeilenspalten neben einem Fenster zu projizieren läuft weiterhin über den Aggregat-Builder; deshalb listen die Beispiele unten jede Zeilenspalte in .group_by(...) und ergänzen annotate("_a", max("id").into()) als No-op, um die Zeilenidentität stabil zu halten. Diese Form funktioniert weiterhin. Beachte: .values(cols).annotate(window) funktioniert nicht — ein Fenster aggregiert nicht und liefert ValuesRequiresAggregate.
Frame-Klauseln:
use rustango::core::{FrameBoundary, FrameKind, WindowFrame};

// Running total over the last 7 rows:
let frame = WindowFrame {
    kind: FrameKind::Rows,
    start: FrameBoundary::Preceding(6),
    end: Some(FrameBoundary::CurrentRow),
};

// Centered 11-row window:
let frame = WindowFrame {
    kind: FrameKind::Rows,
    start: FrameBoundary::Preceding(5),
    end: Some(FrameBoundary::Following(5)),
};
Tri-dialektische Emission:
<fn>(args) OVER (PARTITION BY … ORDER BY … [frame]) ist SQL-Standard — identisch über PG, MySQL 8+ und SQLite 3.25+. Die eine Eigenart: LAG / LEAD / NTILE erfordern Integer-Offsets/-Buckets auf PG (das Binden als bigint-$N-Parameter verursacht function lag(bigint, bigint, bigint) does not exist). Der Writer inlint Integer-Literale für diese Slots direkt ins SQL; Default-Wert-Argumente werden normal gebunden.
Vorbehalte:
FILTER+Windownoch nicht unterstützt: das Kombinieren von.filter(...)mit einer Fensterfunktion wirftSqlError::NestedAggregateWrapper { wrapper: "Filtered(Window)" }— die zugrunde liegende Syntax variiert je nach Funktionsart (PG erlaubtagg_fn() FILTER (WHERE …) OVER (…)für Aggregat-Fensterfunktionen, aber nicht für Ranking-Funktionen), und dem Writer wurde der Dispatch noch nicht beigebracht. Für eine Nachfolge vorgemerkt, falls Nachfrage aufkommt.PercentRank/CumeDist/NthValuesind nicht in v1 — SQL kennt mehr Fensterfunktionen, als hier abgedeckt sind. v1 liefert die vierzehn oben genannten; die fehlenden drei können inkrementell mit derselben Builder-Form hinzugefügt werden.
Auf Aggregaten filtern (HAVING)
Ein .filter(...)-Aufruf nach .annotate(...) landet entweder in WHERE oder HAVING, je nachdem, ob der Name einem Aggregat-Alias entspricht. So fügt das Filtern auf einer echten Spalte ein WHERE hinzu, während das Filtern auf einer Annotation wie post_count ein HAVING hinzufügt:
use rustango::core::aggregates::count_all;
use rustango::core::Op;

// "Authors with > 10 published posts" — the canonical pattern.
// status='published' is on the model       → routes to WHERE.
// post_count > 10 references the annotation → routes to HAVING.
let q = Post::objects()
    .aggregate()
    .group_by("author_id")
    .annotate("post_count", count_all().into())
    .filter("status",     Op::Eq, "published")
    .filter("post_count", Op::Gt, 10_i64)
    .compile()?;
let rows = rustango::sql::fetch_aggregate_dict(&pool, &q).await?;
Emittiert, auf PG:
SELECT "author_id", COUNT(*) AS "post_count"
FROM "post"
WHERE "status" = $1
GROUP BY "author_id"
HAVING COUNT(*) > $2
Der Aggregatausdruck wird in HAVING gehoben, nicht der SELECT-Alias. PG verbietet Aliase in HAVING strikt (nur der Ausdruck löst auf); MySQL + SQLite sind nachsichtiger. Der Writer emittiert die gehobene Form uniform über alle drei, sodass dieselbe Abfrage überall funktioniert.
Die Kettenreihenfolge ist wichtig. Rufe .annotate(alias, ...) VOR dem entsprechenden .filter(alias, ...) auf. Ist die Reihenfolge umgekehrt, schlägt filter() eine leere Annotationsregistrierung nach und leitet auf WHERE — und der resolve_pending-Validator liefert UnknownField bei compile(), weil der Alias keine echte Model-Spalte ist.
Validator-Lücke (entspricht der bestehenden Aggregat-Haltung): alias-geroutete HAVING-Prädikate überspringen den Model-Schema-Spaltendurchlauf. Falsch geschriebene Aliase tauchen bei der Datenbank auf, nicht bei compile(). Gleiche Lücke wie Sum("typo_col") — vorbestehend und orthogonal.
Unterstützte Ops auf alias-geroutetem .filter(): die Binärvergleichs-Menge (Op::Eq / Ne / Lt / Lte / Gt / Gte) plus die SQL-92-Standard-Prädikate, die gegen einen Aggregat-LHS uniform über jedes Backend komponieren — Op::In / NotIn, Between, IsNull, Like / NotLike, ILike / NotILike. Jedes emittiert die vorhersehbare Form:
use rustango::core::{Op, SqlValue};

// HAVING COUNT(*) IN ($1, $2, $3)
Post::objects()
    .aggregate()
    .group_by("author_id")
    .annotate("post_count", count_all().into())
    .filter("post_count", Op::In, SqlValue::List(vec![5_i64.into(), 10_i64.into(), 20_i64.into()]))
    .compile()?;

// HAVING COUNT(*) BETWEEN $1 AND $2
.filter("post_count", Op::Between, SqlValue::List(vec![5_i64.into(), 10_i64.into()]))

// HAVING COUNT(*) IS NULL  /  IS NOT NULL  (bool: true = IS NULL)
.filter("post_count", Op::IsNull, SqlValue::Bool(false))

// HAVING MAX("name") LIKE $1  /  ILIKE $1 (PG) / LOWER(MAX("name")) LIKE LOWER(?) (MySQL/SQLite)
.filter("max_name", Op::ILike, "SMITH%")
Die verbleibenden Ops — die JSON-Op-Familie (JsonContains / JsonContainedBy / JsonHasKey / JsonHasAnyKey / JsonHasAllKeys) und die null-sichere Gleichheit (IsDistinctFrom / IsNotDistinctFrom) — brauchen weiterhin dialektspezifische Writer, die ein &str für den LHS nehmen, sodass sie bei compile() mit QueryError::HavingOpNotSupported { alias, op } ablehnen. Für die steig in die typisierte .having(<TypedExpr>)-Form mit einem vorgebauten Prädikat ein.
Param-Vektor-Aufblähung mit nicht-trivialen Aggregaten: wenn der Alias eine Filtered { Count, filter: pred }- oder Coalesced { Sum, default: 0 }-Annotation anvisiert, hebt der Writer den gesamten Aggregatausdruck in HAVING — inklusive seiner inneren Prädikate und Defaults. Ihre gebundenen Literale bekommen frische Parameter-Slots in HAVING, getrennt von der SELECT-Listen-Emission. Konkret:
SELECT … COUNT(*) FILTER (WHERE "status" = $1) AS "published_count" …
HAVING COUNT(*) FILTER (WHERE "status" = $2) > $3
              -- "published" bound twice (once at $1, once at $2)
Die SQL-Semantik ist unverändert (dieselben Zeilenzahlen kommen zurück), aber stmt.params.len() wächst pro .filter()-Aufruf, der einen nicht-trivialen Alias anvisiert. Für COUNT(*)-Aliase (keine inneren Literale) ist die Aufblähung null. Dokumentiere das, wenn deine Testsuite Parameterzählungen festnagelt.
Joins & Vorladen verwandter Zeilen
Zieh ein Foreign-Key-Ziel zusammen mit der Hauptzeile in einer einzigen Abfrage, sodass du nicht eine zusätzliche Abfrage pro Zeile abfeuerst (das N+1-Problem). .select_related("author") lädt die Relation vorab mit (Eager Loading). Ein ForeignKey<T>-Feld kommt dann bereits befüllt an, statt einen separaten Lookup zu brauchen.
let posts = Post::objects()
    .select_related("author")              // JOIN posts.author -> authors.id
    .fetch(&pool).await?;

for post in &posts {
    let author = post.author.value().unwrap();   // already loaded, no DB round-trip
    println!("{} by {}", post.title, author.name);
}
select_related löst FK-Felder zur Kompilierzeit des Querysets auf. Das ForeignKey<T>-Feld auf dem Elternteil geht von Unloaded(pk) zu Loaded { pk, value }.
Für Reverse-FKs (parent.children) verwende die makro-generierte _set-Methode:
let author_posts = author.post_set(&pool).await?;
Many-to-many- und Reverse-Relationen vorab laden
Für eine Liste von Eltern lädt fetch_with_prefetch_related eine Many-to-many- (m2m(name = "tags", ...)) oder Reverse-FK-Relation (reverse_has(name = "items", ...)) über ihren Namen. Es führt eine Abfrage für die Eltern und eine für die Relation aus, egal wie viele Eltern es sind.
rustango::sql::fetch_with_prefetch_related(Post::objects(), "tags", &pool) liefert Vec<(Post, Vec<Tag>)>. Um die verwandten Zeilen zu filtern oder zu sortieren, übergib ein Queryset an fetch_with_prefetch_related_filtered(Post::objects(), "tags", Tag::objects().order_by(&[("name", false)]), &pool); ein Limit darauf gilt für alle Eltern zusammen. crates/rustango/tests/prefetch_related_tri.rs führt beides auf PostgreSQL, MySQL und SQLite aus.
- Die Eltern-Keys gehen in eine
IN-Liste, die jenseits des Bind-Limits des Backends in Chargen geteilt wird (65.535 auf MySQL, 32.766 auf SQLite; PostgreSQL bindet ein Array). - Eine Many-to-many-Relation joint ihre Through-Tabelle, ein Tag, den viele Posts teilen, kommt also unter jedem Post einmal zurück. Integer-,
String- undUuid-Keys funktionieren alle. - Ein Reverse-FK schlüsselt auf die
self_pk_columnder Relation, Kinder, die auf eine Unique-Spalte zeigen (ForeignKey<Shop, String>miton = "code"), werden also richtig gruppiert. - Ein unbekannter Name ist
QueryError::UnknownField; das falsche Kindmodell anzufragen istExecError::PrefetchTargetMismatch.
Um statt über den Relationsnamen über ein FK-Feld vorab zu laden, funktioniert fetch_with_prefetch_pool(Author::objects(), "author", &pool) weiterhin genauso.
Benutzerdefinierte Joins
Wenn der Join nicht von einem Foreign Key getrieben wird — ein benutzerdefiniertes Prädikat, ein Non-Equi-Join, INNER statt LEFT, ein Self-Join oder ein Join auf einer Nicht-PK-Spalte — verwende .join(Join { … }). Sein on-Feld nimmt jedes WhereExpr, sodass and() / or() / Not / Funktionsaufrufe / Spalte-gegen-Spalte / Literalfilter alle frei komponieren.
use rustango::core::joins::aliased;
use rustango::core::{Join, JoinKind, Op, WhereExpr};

// "Posts that have at least one APPROVED comment" — INNER JOIN with
// an extra predicate inside the ON. Posts with no approved comment
// drop out; LEFT JOIN would keep them.
Post::objects()
    .join(Join {
        target: Comment::SCHEMA,
        alias: "c",
        kind: JoinKind::Inner,
        on: WhereExpr::And(vec![
            // Column-on-column condition — both sides aliased.
            WhereExpr::ExprCompare {
                lhs: aliased("c", "post_id"),
                op: Op::Eq,
                rhs: aliased("post", "id"),
            },
            // Bare Filter — unqualified columns inside `on` resolve
            // to the joined alias ("c"), so this becomes
            // `"c"."is_approved" = $N`.
            Comment::is_approved.eq(true).into(),
        ]),
        project: vec![],
    })
    .fetch(&pool).await?;
Spaltenqualifizierungsregeln innerhalb on:
- Nackte
Filter/ColumnFilter-Spalten +F()-Spaltenreferenzen lösen zum gejointen Alias auf (<alias>, den du übergeben hast). Das ist die natürliche Lesart, weil der Großteil eines ON-Prädikats über die gejointe Tabelle geht. aliased(alias, col)emittiert"<alias>"."<col>"explizit — verwende das für Querverweise zurück auf die äußere Tabelle (aliased("<outer_table>", "<col>")) oder auf einen zuvor gejointen Alias.WhereExpr::ExprCompare { lhs, op, rhs }ist die richtige Form für Spalte-gegen-Spalte-Vergleiche über Tabellen, da beide Seiten jedesExprnehmen.
⚠️ GEFÄHRLICHES MUSTER — typisierte Filter vom ÄUSSEREN Model innerhalb
on.Post::status.eq("draft").into()erzeugt einWhereExpr::Predicate(Filter { column: "status", ... })und verwirft dasPost-Model-Tag an derInto<WhereExpr>-Grenze. Die Auto-Qualifizierungsregel oben leitet diesen Filter dann fälschlich zum gejointen Alias, nicht zuPost. Du bekommst"<joined_alias>"."status" = $N— falsche Tabelle — und der Compiler kann es nicht fangen. Verwendejoins::col_filterfür Prädikate gegen jede Spalte, deren Tabelle nicht der Default-Alias des Joins ist:use rustango::core::joins::{aliased, col_filter}; use rustango::core::Op; // SAFE: explicit alias on the LHS. col_filter("post", "status", Op::Eq, "draft")Reserviere nackte typisierte Filter (
Comment::is_approved.eq(true).into()) nur für Spalten auf dem GEJOINTEN Model — niemals für Spalten des äußeren Models.
JoinKind-Tri-Dialekt-Unterstützung:
| Art | PG | MySQL | SQLite |
|---|---|---|---|
Inner | ✓ | ✓ | ✓ |
Left (Standard) | ✓ | ✓ | ✓ |
Right | ✓ | ✓ | ✗ SqlError::JoinKindNotSupported |
Full | ✓ | ✗ | ✗ |
Right ist leicht zu umgehen — tausche die Operanden und verwende Left. Full auf MySQL wird üblicherweise mit (LEFT JOIN) UNION (RIGHT JOIN) emuliert, wenn du es wirklich brauchst.
Andere Fehler zur Emit-Zeit:
- Leeres
on-Prädikat (WhereExpr::And(vec![])oder keineExprCompares) wird mitSqlError::EmptyJoinOnConditionabgelehnt. SQL erfordert mindestens ein boolesches Prädikat innerhalbON; die Auto-true-Kurzform vom Top-Level-WHERE gilt hier nicht.
project ist derzeit tote Daten bei Ad-hoc-Joins.
Das Join.project-Feld weist den Writer an, <alias>"."<col>" AS "<alias>__<col>"-Spalten in der SELECT-Liste zu emittieren. Heute dekodiert nur select_related diese tatsächlich (über den Voll-Zeilen-Decoder des FK-Ziels); Ad-hoc-Joins emittieren die Spalten, aber der Vec<MainModel>-Decoder ignoriert sie, sodass das Befüllen von project bei einem Ad-hoc-Join nur Bytes an die Leitung anfügt. Lass es als vec![], bis Projektionsverengung + Tupel-Decoding landen.
Wann man zu Ad-hoc-Joins greift:
| Bedarf | Werkzeug |
|---|---|
| Verwandte Zeilen zusammen mit der Hauptzeile ziehen | select_related |
| Many-to-many- oder Reverse-FK-Zeilen für eine Liste von Eltern laden | fetch_with_prefetch_related |
| Hauptzeilen nach einem Prädikat der verwandten Tabelle filtern | exists(...) / not_exists(...) |
| Per INNER statt LEFT filtern oder mit zusätzlichen ON-Prädikaten | .join(...) |
Self-Join (z. B. employee.manager_id = manager.id) | .join(...) |
| Anti-Join (Zeilen in A mit KEINEM Treffer in B) | not_exists(...) |
select_related bleibt das richtige Werkzeug, wenn der Join "folge diesem FK und projiziere alle seine Spalten" ist. Ad-hoc-Joins sind der Notausstieg, wenn du brauchst: einen Nicht-FK-Join-Schlüssel, INNER statt LEFT, ein zusätzliches Prädikat innerhalb des ON oder einen Self-Join.
Nur einige Felder speichern
Schreib nur die Felder, die du geändert hast, statt jeder Spalte. Ein normales Speichern überschreibt jede Nicht-PK-Spalte; save_partial(&[...], &pool) überschreibt nur die, die du benennst.
let mut post = Post::objects().fetch(&pool).await?.pop().unwrap();
post.title = "new title".into();
post.save_partial(&["title"], &pool).await?;  // SET "title" = $1
                                                  // — leaves body, status, views untouched
Zwei Motivationen:
- Performance. Breite Zeilen mit
TEXT/JSON/bytea-Spalten zahlen dafür, jedes Feld bei jedemsave()neu zu binden und neu zu schreiben, selbst wenn nur eines mutierte.save_partialhält dieSET-Klausel auf genau das, was sich geändert hat. - Nebenläufigkeitssicherheit. Wenn zwei Schreiber nach einem gemeinsamen Read auseinanderlaufen, überschreibt der Verlierer stillschweigend die Edits des Gewinners auf Feldern, die er nicht angefasst hat. Nur das Feld zu benennen, das du tatsächlich geändert hast, bewahrt die Arbeit des anderen Schreibers überall sonst.
// Writer A — flips title.
a.title = "from-A".into();
a.save_partial(&["title"], &pool).await?;

// Writer B — started from the same read, flips status.
// B's local `title` is stale, but it's not in the list, so A's
// write survives.
b.status = "from-B".into();
b.save_partial(&["status"], &pool).await?;
Feldnamen sind Struct-Felder auf Rust-Seite, keine SQL-Spalten — ["author_id"] (nicht ["author"] für ein FK-typisiertes Feld). Unbekannte Feldnamen geben ExecError::Query(QueryError::UnknownField) zurück. Eine leere Liste ist eine No-op (gibt Ok(0) (betroffene Zeilen) zurück und loggt ein tracing::warn!) — es gibt schlicht nichts zu schreiben. Auditierte Models (#[rustango(audit(...))]) verengen den Audit-Log-Snapshot auf dieselbe Spaltenmenge — das Log spiegelt genau das wider, was geschrieben wurde.
Auto-PK-Hinweis. save_partial ist nur UPDATE; es auf einem Auto::Unset-PK aufzurufen ist ein Benutzerfehler (verwende dafür insert / save). Anders als save, das automatisch Unset → insert dispatcht, nimmt diese Methode an, dass du bereits eingefügt hast.
Kompilierzeit-geprüfte Feldliste
Die string-geschlüsselte Form oben passt für dynamische Feldlisten (Admin-Formulare, API-Payloads). Wenn die Liste in deinem Code fest ist, fängt save_partial_typed((Post::title, ...), &pool) falsch geschriebene oder umbenannte Felder zur Kompilierzeit statt zur Laufzeit:
post.save_partial_typed((Post::title, Post::slug), &pool).await?;
//                       ──────────  ──────────
//                       title_col   slug_col   ← distinct ZSTs
Jedes Post::<field> ist sein eigener Zero-Sized Type — ein homogener Slice (&[Post::title, Post::slug]) typprüft in Rust nicht, sodass die API stattdessen ein Tupel nimmt. Ein-Feld-Aufrufe verwenden das Nachlaufkomma-Idiom: (Post::title,). Tupel werden von Stelligkeit 1 bis 12 unterstützt — darüber hinaus wechsle zu save_partial(&[&str], _).
Modellübergreifende Tupel sind ein Kompilierfehler — (Post::title, Author::name) scheitert an der TypedFieldList<Post>-Trait-Schranke, weil Author::names Column::Model = Author ist. Das ist der Kernvorteil gegenüber der string-geschlüsselten Form: Rename-Refactorings auf einem Spaltennamen tauchen an der typisierten Aufrufstelle auf, nicht zur Laufzeit.
Senkt intern zu save_partial ab — gleiche Audit-Verengung, gleiche Auto::Unset-Beschränkung, gleiche Leere-Liste-No-op-Semantik.
Massenoperationen
bulk_insert(rows, &pool)undupsert(&pool)laufen auf jedem Backend;bulk_insert_on/upsert_onnehmen jedenSqlExecutor. Jenseits der Bind-Grenze schreibt ein Bulk-Insert in Blöcken innerhalb einer Transaktion. MySQL hat keinRETURNING, daher lässtbulk_insertdieAuto-Felder dort leer.
Fallstrick — Massenoperationen überspringen Per-Zeile-Hooks.
bulk_insert, Queryset.update().execute_pool()und Mengen-Deletes (delete_where,destroy) laufen als mengenbasiertes SQL: sie feuern keine Signale, routen nicht durch Soft-Delete und führen keine Per-Zeile-Validierung aus. Verwende sie für Geschwindigkeit; wechsle zu Per-Zeile-save()/delete(), wenn du diese Seiteneffekte brauchst.
Eine Tabelle leeren. Model::truncate(&pool) führt auf jedem Backend DELETE FROM aus und gibt die gelöschten Zeilen zurück. Das on_delete jedes FK gilt: Solange eine restrict-Zeile auf die Tabelle zeigt, schlägt es mit ExecError::TruncateReferenced fehl und ändert nichts. Model::truncate_cascade(&pool) leert zusätzlich jede Tabelle, die auf sie verweist, transitiv und unabhängig von ihrem on_delete: TRUNCATE … CASCADE auf PostgreSQL, ein DELETE pro Tabelle mit abgeschalteten (MySQL) bzw. aufgeschobenen (SQLite) FK-Prüfungen. Keines von beiden setzt IDs zurück. Auf MySQL und SQLite kann eine Tabelle, die mit restrict auf sich selbst verweist, ein einfaches truncate ablehnen; nutze dann truncate_cascade. Die Kaskade von PostgreSQL erreicht auch verweisende Tabellen in anderen Schemas, etwa Schema-Mandanten, die auf eine gemeinsame Tabelle zeigen; MySQL und SQLite bleiben in der aktuellen Datenbank.
Füge viele Zeilen in einem Statement ein, aktualisiere oder lösche sie, statt eine Anweisung pro Zeile abzusetzen. Der as _-Import bringt die Methoden eines Traits in Scope, ohne den Trait direkt zu benennen.
// Bulk INSERT — rows FIRST (a `&mut [Self]`), executor/pool second.
let mut rows = [p1, p2, p3];
Post::bulk_insert_on(&mut rows, &pool).await?;

// Bulk UPDATE — applies the same set to every matched row. `.set`
// takes a string column name.
Post::objects()
    .where_(Post::status.eq("draft"))
    .where_(Post::created_at.lt(thirty_days_ago))
    .update()
    .set("status", "archived")
    .execute_on(&pool).await?;

// Bulk DELETE
Post::objects()
    .where_(Post::deleted_at.is_not_null())
    .delete_on(&pool).await?;
Einfügen oder aktualisieren (Upsert)
Füge eine Zeile ein oder aktualisiere sie, wenn eine Zeile mit demselben Schlüssel bereits existiert — ein Upsert. Es emittiert das native ON CONFLICT … DO UPDATE der Datenbank.
Das Einzelinstanz-.upsert_on(executor) kollidiert auf dem ersten unique_together des Models, sonst auf dem Primärschlüssel: mit einem Auto::Unset-PK weist der Server einen neuen Schlüssel zu (äquivalent zu insert); mit einem Auto::Set-PK wird die Zeile eingefügt, wenn abwesend, oder alle Nicht-PK-Spalten werden überschrieben, wenn vorhanden.
// Upsert on the PK — INSERT, or UPDATE every non-PK column if the
// PK already exists.
post.upsert_on(&pool).await?;
Um auf einem beliebigen Unique-Schlüssel zu upserten, verwende den Bulk-Helper — er nimmt die Zeilen, die Konfliktziel-Spalten, die bei Konflikt zu aktualisierenden Spalten und den Pool ZULETZT:
// ON CONFLICT (external_id) DO UPDATE SET title = EXCLUDED.title
Post::bulk_upsert_pool(
    &[post],
    &["external_id"],          // conflict target (unique key)
    &["title"],                // columns to overwrite on conflict
    &pool,
).await?;
Transaktionen
Mische keine
&pool-Aufrufe in einer Transaktion. Jeder Aufruf zwischentransaction_poolundcommitmuss die Transaktion (&mut tx) anvisieren. Ein verirrtes&pool/fetch()/save(&pool)checkt eine zweite Verbindung aus und kann den Pool unter Last deadlocken. Fädle dietxdurch, oder verwenderustango::sql::atomic.
Führe mehrere Schreibvorgänge als eine Einheit aus, die entweder alle gelingen oder alle zurückrollen. Öffne eine mit rustango::sql::transaction_pool(&pool): das läuft auf jedem Backend. Lies mit fetch_on(&mut tx) und schreibe mit den _tx-Methoden (save_tx, insert_tx, delete_tx), damit die Arbeit in der offenen Transaktion landet und nicht auf einer frischen Pool-Verbindung.
let mut tx = rustango::sql::transaction_pool(&pool).await?;

let mut a = Account::objects()
    .where_(Account::id.eq(1))
    .fetch_on(&mut tx).await?
    .pop().unwrap();
let mut b = Account::objects()
    .where_(Account::id.eq(2))
    .fetch_on(&mut tx).await?
    .pop().unwrap();

a.balance -= 100;
b.balance += 100;
a.save_tx(&mut tx).await?;
b.save_tx(&mut tx).await?;

tx.commit().await?;
Verwirf die tx, ohne commit() aufzurufen (z. B. bei einem frühen ?-Return), und die Transaktion rollt zurück. Für einen Nach-Commit-Hook ist der Scope rustango::sql::atomic(&pool, |tx| Box::pin(async move { … })), der bei Ok automatisch committet und bei Err zurückrollt — der Hook selbst ist rustango::sql::on_commit(|| { … }) und wird innerhalb dieser Closure aufgerufen. atomic leert die Queue, nachdem der Commit durch ist; ein on_commit außerhalb eines atomic-Scopes paniert, statt den Callback zu verwerfen. In der Closure ist tx ein AtomicTx: sperre ihn pro Statement, insert_tx(&mut *tx.lock().await?, &q). Ein verschachteltes atomic(&pool, …) auf demselben Pool läuft als Savepoint auf derselben Verbindung, und seine Hooks warten auf den äußersten Commit. Verschachtelung gilt pro Pool-Objekt: reiche den Pool des Requests weiter. Zwei verschachtelte Blöcke gleichzeitig (join!) oder ein über den Aufruf gehaltener TxGuard liefern ExecError::NestedAtomic; ein fehlgeschlagener Savepoint rollt alles mit ExecError::AtomicAborted zurück. Ein mit tokio::spawn gestarteter Task erbt den Block nicht.
Der Leitfaden Transaktionen behandelt atomic vollständig: was einem Block beitritt, Fehler je Backend, Isolationsstufen und Einstellungen (atomic_with), Wettläufe bei get_or_create_tx, die _on-Formen, DDL und Abbruch.
Many-to-many
Verknüpfe viele Zeilen mit vielen anderen über eine Verknüpfungstabelle — eine Many-to-many-Relation. Deklariere die Relation auf dem Model, verwende dann den generierten Accessor, um die verknüpften IDs hinzuzufügen, zu entfernen, zu setzen oder aufzulisten.
#[rustango(
    table = "posts",
    m2m(name = "tags", to = "tags", through = "post_tags",
        src = "post_id", dst = "tag_id"),
)]
pub struct Post { ... }
Verwende den auto-generierten Accessor:
let tag_ids: Vec<i64> = post.tags_m2m().all(&pool).await?;
post.tags_m2m().add(42, &pool).await?;
post.tags_m2m().remove(42, &pool).await?;
post.tags_m2m().set(&[1, 2, 3], &pool).await?;        // replace all
post.tags_m2m().clear(&pool).await?;
let has = post.tags_m2m().contains(42, &pool).await?;
all liefert i64-IDs; für String- oder Uuid-Schlüssel verwende all::<K>(&pool).
Die Verknüpfungstabelle (post_tags) wird von make_migrations automatisch erstellt mit zusammengesetztem PK + zwei FKs ON DELETE CASCADE. Derzeit hat die Verknüpfungstabelle nur die zwei FK-Spalten — für zusätzliche Spalten (added_by, order, created_at) definierst du ein separates Model und traversierst manuell, bis "custom through model" landet.
JSON / JSONB
Speichere und frage ein JSON-Dokument in einer Spalte ab. Deklariere das Feld als serde_json::Value (den generischen JSON-Typ), frage es dann mit json_contains oder einem Pfadfilter ab.
#[derive(Model)]
pub struct Event {
    #[rustango(primary_key)]
    pub id: Auto<i64>,
    #[rustango(default = r#"'{}'::jsonb"#)]
    pub data: serde_json::Value,
}
JSON-Inhalte abfragen:
use rustango::core::{Expr, Op, SqlValue, WhereExpr};
use rustango::core::funcs::json_path;
use rustango::core::F;

let with_email = Event::objects()
    .where_(Event::data.json_contains(serde_json::json!({"email_set": true})))
    .fetch(&pool).await?;

// Path extract — `json_path(F("data"), &["type"], true)` builds the
// `data ->> 'type'` text-extract LHS; compare it via `where_raw`.
let typed = Event::objects()
    .where_raw(WhereExpr::ExprCompare {
        lhs: json_path(F("data"), &["type"], true),
        op: Op::Eq,
        rhs: Expr::Literal(SqlValue::String("user.created".into())),
    })
    .fetch(&pool).await?;
Lies/schreibe Rust-Typen über serde_json::from_value / to_value.
Backends unterscheiden sich an zwei Stellen:
json_containsliefert auf PostgreSQL und MySQL dieselben Zeilen, wenn der Wert an jedem Key die Form der Spalte hat ({"tags": ["a"]}gegen{"tags": ["a", "b"]}). MySQL trifft zusätzlich einen Skalar innerhalb eines Arrays ({"tags": "a"}); PostgreSQL nicht. SQLite hat keine Containment-Prüfung.Event::data.contains(..)/icontains(..)und Admin-search_fieldsvergleichen den gespeicherten JSON-Text. Das stimmt nur innerhalb eines Keys oder String-Werts überein (icontains("alice")): SQLite speichert{"a":1}, PostgreSQL und MySQL geben{"a": 1}aus, die Keys nach Länge, dann byteweise sortiert; SQLite behält den Text, den rustango geschrieben hat.
Soft Delete
Markiere eine Zeile als gelöscht, indem du einen Zeitstempel setzt, statt sie zu entfernen — ein Soft Delete. Markiere die Zeitstempel-Spalte mit dem #[rustango(soft_delete)]-Attribut (eine Derive-Annotation, die dem Makro sagt, wie das Feld zu behandeln ist):
#[derive(Model)]
pub struct Post {
    #[rustango(primary_key)]
    pub id: Auto<i64>,
    pub title: String,
    #[rustango(soft_delete)]
    pub deleted_at: Option<DateTime<Utc>>,
}
Verwendung:
post.soft_delete(&pool).await?;        // sets deleted_at = NOW()
post.restore(&pool).await?;            // sets deleted_at = NULL
post.force_delete(&pool).await?;       // real DELETE

// Default queries DO include soft-deleted rows. Filter explicitly:
let live = Post::objects().where_(Post::deleted_at.is_null()).fetch(&pool).await?;
Diese nehmen den &Pool und laufen auf allen drei Backends; soft_delete_on / restore_on sind die Executor-Formen, auf allen Backends (für eine Transaktion). Der "Löschen"-Button des Admins soft-löscht jedes Model, das die Spalte hat. Standardabfragen enthalten weiterhin soft-gelöschte Zeilen, aber du musst den Filter nicht mehr selbst schreiben: .active() schließt sie aus, .only_trashed() liefert nur sie, .with_trashed() ist ein Marker, der die Absicht ausdrückt und nichts ändert — ein früheres .active() hebt es nicht auf. Um sie standardmäßig auszuschließen, deklariere einen Global Scope — #[rustango(global_scope(name = "live", apply = live_only))], wobei live_only() den Filter deleted_at IS NULL liefert — und schalte ihn pro Query mit .without_global_scope("live") ab.
Audit-Trail
Zeichne auf, wer welche Felder wann geändert hat, automatisch bei jedem Speichern und Löschen — ein Änderungsprotokoll pro Zeile. Annotiere das Model mit den zu verfolgenden Feldern:
#[derive(Model)]
#[rustango(audit(track = "title, body, status"))]
pub struct Post { ... }
Jedes Speichern/Löschen schreibt eine Zeile in rustango_audit_log mit einem before / after JSONB-Diff für die aufgelisteten Felder. Setze die Quelle pro Request:
use rustango::audit::{with_source, AuditSource};

with_source(
    AuditSource::User { id: user_id.to_string() },
    async {
        post.save(&pool).await
    },
).await?;
Das Per-Zeile-Verlaufspanel des Admins liest aus dieser Tabelle; der modellübergreifende Feed ist unter <admin prefix>/__audit (Builder::audit_url ändert das; der Tenant-Admin nutzt RouteConfig::audit_url, Standard /audit).
Auditierte Zeilen, die ein FK on_delete = "cascade" entfernt, bekommen einen delete-Eintrag, gelesen vor dem Löschen in dessen Transaktion. Zeilen, die set_null / set_default ändern, bekommen einen update-Eintrag, und Model::truncate / truncate_cascade schreiben einen Sammeleintrag pro auditierter Tabelle, die sie ändern. Das läuft auf Pool- und Transaktionspfaden (delete, PoolTx, PoolConn), 500 gelöschte Zeilen auf einmal: Die kaskadierten Zeilen jedes Blocks werden mit FOR UPDATE gelesen und mit ihren Einträgen im Speicher gehalten, bis der Block gelöscht ist. Auf einem rohen sqlx-Executor (delete_on(&mut pg_conn)) wird ein solches Löschen mit ExecError::AuditUnsupported abgelehnt. Ein DEFERRABLE INITIALLY DEFERRED-FK kaskadiert erst beim Commit, seine Zeilen bekommen also keine Einträge.
Bereinigung:
rustango::audit::cleanup_older_than_pool(&pool, 90).await?;  // delete > 90 days
rustango::audit::cleanup_keep_last_n_pool(&pool, 50).await?; // keep most recent 50/row

// CLI
manage audit-cleanup --days 90
manage audit-cleanup --keep-last 50 --tenant acme
Die _pool-Helfer nehmen &Pool und laufen auf allen drei Backends. Das audit-cleanup-Verb braucht das tenancy-Feature. Es kürzt das Log der Registry und das jedes aktiven Tenants; --tenant <slug> oder --registry grenzt es ein, und ein N von 0 oder weniger braucht --yes.
Raw-SQL-Notausstieg
Steig auf handgeschriebenes SQL um, wenn der Query-Builder nicht ausdrücken kann, was du brauchst. Die sqlx-Makros führen eine Abfrage aus und dekodieren das Ergebnis in ein Tupel, ein typisiertes Model oder nichts:
use rustango::sql::sqlx;

// sqlx runs on one driver's pool. Take it with `as_sqlite()` (or
// `as_postgres()` / `as_mysql()`) and write that backend's SQL.
let db = pool.as_sqlite().ok_or("not a SQLite pool")?;

// Raw query → typed rows
let rows = sqlx::query_as::<_, (i64, String)>("SELECT id, title FROM posts WHERE views > ? ORDER BY views DESC")
    .bind(1000)
    .fetch_all(db)
    .await?;

// Raw with model decoding
let posts: Vec<Post> = sqlx::query_as::<_, Post>("SELECT * FROM posts WHERE complicated_condition")
    .fetch_all(db)
    .await?;

// Raw without rows (DDL / DML)
sqlx::query("VACUUM").execute(db).await?;
Für programmatisches rohes SQL innerhalb der Rustango-Query-Schicht (tri-dialektisch; nimmt das SQL, ein Vec<SqlValue> von Binds, dann den Pool ZULETZT, und gibt Vec<T> zurück):
use rustango::sql::raw_query_pool;

let rows = raw_query_pool::<(i64,)>(
    "SELECT COUNT(*) FROM posts WHERE complicated",
    vec![],
    &pool,
).await?;
let count = rows.first().map(|r| r.0).unwrap_or(0);
Lazy-FK-Laden
Ein Foreign Key hält anfangs nur die verwandte ID (Unloaded), und du holst die volle verwandte Zeile erst, wenn du danach fragst (Lazy Loading). match auf den ForeignKey, um beide Zustände zu behandeln, oder rufe .get_pool(&pool) auf, um ihn bei Bedarf zu laden. Für einen ganzen Batch verwende select_related (oben), um sie in einer Abfrage vorzuladen und den Per-Zeile-Fetch zu überspringen.
let mut post = Post::objects().find_or_fail(1, &pool).await?;

// FK starts Unloaded — just the PK. `Loaded` is a struct variant
// `{ pk, value }`; `value` is a `Box<Author>`.
match &post.author {
    ForeignKey::Unloaded(pk) => println!("author id = {pk}"),
    ForeignKey::Loaded { pk, value } => println!("author = {}", value.name),
}

// Force-load
let author = post.author.get_pool(&pool).await?;     // fetches if Unloaded
get_pool nimmt den Multi-Backend-&Pool, und get_on(executor) nimmt eine Verbindung oder Transaktion.
Verwende select_related("author") auf dem Queryset, um einen Batch vorzuladen.
Vier Wege zu filtern
Es gibt vier Wege, einen Filter auszudrücken; wähle nach Kontext. Typisierte Spalten werden zur Kompilierzeit geprüft und sind am besten für App-Code; die field__lookup-String-Form ist die passende Syntax für Admin und generisches CRUD; filter_op ist dafür, wenn du bereits ein Op hältst; der HTTP-Query-String treibt die öffentliche API.
// 1. HTTP query string (set via ViewSet filter_fields)
//    GET /api/posts?author_id=42&status__ne=archived

// 2. String lookup (the same `field__lookup` grammar your
//    URL parser uses, but inside Rust). Suffix decides the operator
//    and value-shape; bare key is exact-eq. Field name is validated
//    at `.compile()`.
Post::objects()
    .filter("status", "published")                 // exact-eq
    .filter("title__icontains", "rust")            // ILIKE %rust%
    .filter("views__gt", 100_i64);

// 3. Explicit operator (legacy 3-arg shape — when you want to pass
//    an Op directly without parsing a suffix)
Post::objects().filter_op("author_id", Op::Eq, SqlValue::I64(42));

// 4. Typed columns (compile-time field check; preferred in app code)
Post::objects().where_(Post::author_id.eq(42));
Konvention: typisiert im App-Code, String-Form in Admin- / generischem CRUD-Code, filter_op nur, wenn du bereits ein Op berechnet hast (z. B. aus einem Request-Parser), HTTP-Query für die öffentliche API-Oberfläche.
Unterstützte Lookup-Suffixe
| Suffix | SQL-Operator | Wertform | Hinweise |
|---|---|---|---|
(keins) / __exact | = | Skalar | nackter Schlüssel ist exact-eq |
__ne | <> | Skalar | |
__gt / __gte / __lt / __lte | > >= < <= | Skalar | |
__contains | LIKE | String | umschließt den Wert als %v%; überall case-sensitiv (MySQL COLLATE utf8mb4_bin, SQLite GLOB) |
__icontains | ILIKE | String | umschließt den Wert als %v%; MySQL emuliert über LOWER() |
__startswith | LIKE | String | umschließt als v% |
__istartswith | ILIKE | String | umschließt als v% |
__endswith | LIKE | String | umschließt als %v |
__iendswith | ILIKE | String | umschließt als %v |
__iexact | ILIKE | String | kein Wildcard-Umschließen — exakter case-insensitiver Treffer |
__in | IN (…) | SqlValue::List | lehnt Nicht-Listen-Werte ab |
__isnull | IS NULL / IS NOT NULL | bool | true → IS NULL, false → IS NOT NULL |
__between / __range | BETWEEN … AND … | 2-elementige SqlValue::List | an beiden Enden inklusiv |
__regex / __iregex | PG ~ / ~*, MySQL/SQLite REGEXP | String | Case-Flag inline als (?i) / (?-i) auf MySQL/SQLite; SQLite braucht eine regexp-User-Funktion |
LIKE-Metazeichen werden escaped.
__contains/__startswith/__endswith(und ihrei-Varianten) behandeln den Wert als wörtlichen Teilstring — ein%oder_darin passt auf sich selbst, nicht als Platzhalter. Das Framework escaped sie und gibtESCAPE '!'aus, auf allen drei Dialekten wirksam. Für ein rohes Muster mit eigenen%/_nutze__like/__ilike, die den Wert wörtlich binden.
Fehler tauchen bei .compile() auf, nicht zur .filter()-Aufrufzeit — Wertform-Diskrepanzen (z. B. __in mit einem Skalar, __isnull mit einem Nicht-Bool, __between mit falscher Stelligkeit) und unbekannte Suffixe (status__nope) geben QueryError::UnknownLookup / QueryError::InvalidLookupValue von .compile() zurück, sodass die fluente Kette typsauber bleibt. Relationsübergreifende Schlüssel (author__name__icontains) funktionieren auf dem SELECT-Pfad: compile() fügt die JOINs der FK-Kette für dich hinzu. Update-, Delete- und Aggregat-Pfade unterstützen sie nicht und geben einen Fehler zurück.
Jeder Filteraufruf wird per AND mit allen vorhergehenden verknüpft; mische String-Form, filter_op und where_ frei auf demselben Queryset.
Mandantengebundene Abfragen
In einer Multi-Tenant-App führe jede Abfrage gegen die Verbindung des aktuellen Mandanten aus statt gegen den geteilten Pool. Hol dir eine Per-Request-Verbindung und übergib sie an fetch_on (das jeden Datenbank-Executor akzeptiert) statt an fetch (das immer &pool verwendet).
use rustango::extractors::Tenant;

async fn handler(mut t: Tenant) -> Result<...> {
    let conn = t.conn().await?; // &mut PgConnection for this tenant
    let posts = Post::objects().fetch_on(&mut *conn).await?;
    Ok(...)
}
Schema-Mode-Tenants teilen sich den Registry-Pool, verlassen sich aber auf ein
SET search_path pro Checkout, sodass ein &PgPool stillschweigend das falsche
Schema träfe.
Im Modus „eine Datenbank pro Mandant“ (SQLite, MySQL oder Postgres, mit einem
DatabaseTenantContext) nimm für das ORM TenantScope (oder Tenant<DB> auf
SQLite und MySQL). Sein t.pool() ist der eigene Pool des Mandanten, also funktioniert jede
Pool-Methode, auch Schreibzugriffe, und bis zur ersten Abfrage wird keine
Verbindung gehalten. t.conn() des DatabaseTenant-Extraktors nimmt nur die
_on-Lesezugriffe.
Zum Beispiel post.insert(t.pool()) und Post::objects().count(t.pool());
das Beispiel sqlite_tenant_demo macht genau das.
Eine Verbindung pro Request
Jedes fetch(&pool) leiht sich seine eigene Verbindung. Um die Abfragen eines
Handlers auf einer auszuführen, nimm sie mit let mut conn = pool.acquire().await?;
(ein PoolConn) und übergib &mut conn an die _on-Methoden, etwa
Post::objects().fetch_on(&mut conn). Das funktioniert auf allen drei Backends.
conn.begin() öffnet ein PoolTx auf derselben Verbindung.
Die _on-Methoden sind fetch_on, first_on, count_on, exists_on,
fetch_paginated_on, in_bulk_on, explain_on, delete_on auf einem Queryset,
execute_on auf update(), ForeignKey::get_on, annotate_count_children_on,
fetch_aggregate_on sowie fetch_on auf values(), values_list(),
values_list_flat() (plus first_on) und aggregate(). Sie nehmen jeden
SqlExecutor: &mut PoolConn, &mut PoolTx, &Pool oder auf Postgres jeden
sqlx-Executor (&PgPool, &mut PgConnection, t.conn()).
Eine Verbindung geht mit jedem Sitzungszustand, den du auf ihr gesetzt hast
(SET …, MySQL-@vars, SQLite-PRAGMA), zurück in den Pool; der nächste
Ausleiher erbt ihn, und auf einem Registry-Pool kann das der Request eines anderen
Tenants sein. Rufe nach einer solchen Änderung conn.close_on_drop() auf, damit
die Verbindung geschlossen statt wiederverwendet wird.
Solange du ein PoolConn hältst, übergib es an jede Abfrage: Eine &Pool-Methode
im selben Handler leiht sich eine zweite Verbindung. Mit max_connections solchen
Requests gleichzeitig hält jeder eine und wartet auf eine weitere, und alle laufen
in den Timeout. Gib die Verbindung frei, bevor du Code aufrufst, der &Pool nimmt.
Signale
Führe einen Callback aus, wenn etwas passiert — Signale. Es gibt zwei unabhängige Registrierungen: eine für Model-Schreibvorgänge, eine für HTTP-Requests.
Model-Lebenszyklus
Feure einen Hook vor oder nach dem Speichern oder Löschen eines Models: pre_save, post_save, pre_delete, post_delete. Registriere einen mit connect_post_save::<Post, _, _>(...).
Speichern sendet sie nicht: Kein ORM-Schreibzugriff feuert diese Signale, also rufe send_post_save(&post, PostSaveContext { created }) (und die anderen) nach dem Schreiben selbst auf.
use rustango::signals::{connect_post_save, PostSaveContext};

connect_post_save::<Post, _, _>(|post, ctx| async move {
    if ctx.created {
        tracing::info!("new post #{}", post.id.get().copied().unwrap_or(0));
    }
});
T: Clone + 'static ist erforderlich (der Dispatcher übergibt jedem Empfänger einen Arc<T>-Klon). Empfänger laufen sequenziell in Registrierungsreihenfolge. Trenne über die ReceiverId, die connect_* zurückgibt. Die vier Signalarten + ihre Kontextformen sind inline in rustango::signals dokumentiert.
Request-Lebenszyklus
Feure einen Hook um jeden HTTP-Request: request_started, request_finished, got_request_exception. Füge die RequestSignalsLayer-Middleware zu deinem Router hinzu, verbinde dann Callbacks. Nützlich für Tracing, Audit, Request-Zeit-Metriken und Fehlerberichterstattung.
use axum::Router;
use rustango::signals::request::{
    connect_request_started, connect_request_finished, RequestSignalsLayer,
};

connect_request_started(|ctx| Box::pin(async move {
    tracing::info!(method = %ctx.method, path = %ctx.path, "started");
}));
connect_request_finished(|ctx| Box::pin(async move {
    metrics::histogram!("http_request_ms").record(ctx.elapsed_ms);
}));

let app: Router = Router::new()
    .route("/", get(home))
    .layer(RequestSignalsLayer::new());  // outermost — sees request first / response last
| Signal | Kontextfelder |
|---|---|
request_started | method, path, query |
request_finished | method, path, status, elapsed_ms |
got_request_exception | method, path, error |
Empfänger laufen sequenziell in Registrierungsreihenfolge; umschließe einen Körper in tokio::spawn für parallelen Fanout oder Panic-Isolation. Die Request- und Model-Registrierungen sind unabhängig — das Verbinden / Trennen / Leeren der einen berührt die andere nicht.
Performance-Tipps
Eine schnelle Checkliste, um Abfragen schnell zu halten, während die Daten wachsen:
- Verwende immer Indizes für
WHERE- undORDER BY-Spalten. Deklariere über#[rustango(index)], damit sie in den Migrationen sind. select_relatedfür FK-Anzeige in Listen — eliminiert N+1 in Admin-/Listenansichten..limit()/fetch_paginated_onstatt alles zu laden — lade niemals ganze Tabellen.- Cursor-Paginierung für riesige Tabellen — überspringt
COUNT(*)pro Seite. bulk_insert_onoderbulk_upsert_poolfür Batches — ein einziger Roundtrip statt N.upsert_onfür idempotente Importe —ON CONFLICTist schneller als SELECT-dann-INSERT.transaction_pool/atomicfür zusammenhängende Schreibvorgänge — reduziert Commit-Overhead und wahrt Konsistenz.- Cache heiße Reads mit
cache::get_or_set— invalidiere imconnect_post_save<T>(...)-Signalhandler.
Siehe auch
- Models — ein Model deklarieren: Feldtypen, Primärschlüssel, jedes Attribut (der Begleiter zu diesem Query-Leitfaden).
- Serializer — Model-Zeilen in JSON formen.
- ViewSets — ein Model in eine JSON-CRUD-API verwandeln.
- Der Admin — eine auto-generierte UI über denselben Models.
manage-CLI —makemigrations/migratefür Schemaänderungen.