 Rustango
Trabajos en segundo plano
Cierto trabajo no debería suceder durante una petición — enviar un correo de bienvenida, redimensionar una subida, sincronizar una API de terceros. Hacerlo en línea hace esperar al usuario y acopla la respuesta a una llamada externa poco fiable. Un trabajo en segundo plano mueve ese trabajo a una cola: el handler retorna de inmediato, y un pool de workers ejecuta el trabajo momentos después, con reintentos automáticos y una ruta dead-letter para los fallos — una cola de tareas, íntegramente en Rust.
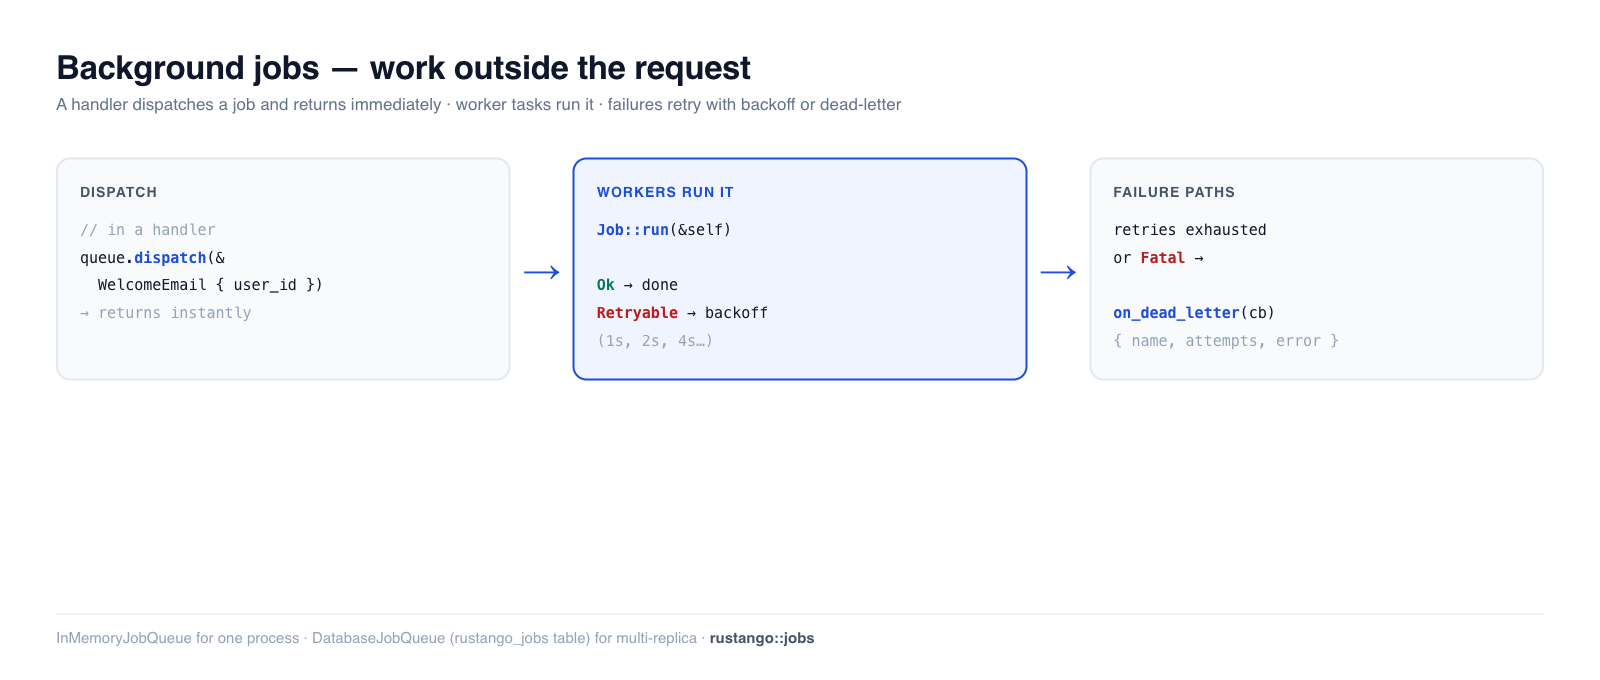
¿Un término nuevo aquí? cola, worker, reintento/backoff, dead-letter — ver el glosario.
Fuente:
rustango::jobs(Job,JobQueue,InMemoryJobQueue,JobError,JobDeadLetter) yrustango::jobs::DatabaseJobQueue(la cola respaldada por tabla, alias depg::PgJobQueue) — tras la featurejobs;DatabaseJobQueueymake:workernecesitan ademásjobs-postgres(ambas activas por defecto).Versión ejecutable: los fragmentos in-memory, de reintento y de dead-letter están copiados de
jobs_doc.rs(cargo test -p rustango --test jobs_doc); la cola persistente se prueba con dogfooding sobre SQLite mediantejobs_sqlite_live.rs(cargo test -p rustango --features sqlite,jobs-postgres --test jobs_sqlite_live).
Tabla de contenidos
- Paso 1 — Definir un trabajo
- Paso 2 — Iniciar una cola
- Paso 3 — Despachar desde un handler
- Paso 4 — Cablearlo en tu aplicación — el ejemplo completo
- Ejecutar los workers (CLI + producción)
- Reintentos y backoff
- El contexto del trabajo: id, intento, parada
- El handler dead-letter
- La cola persistente (producción)
- Trabajos con multi-tenancy
- Barridos programados con multi-tenancy
- Referencia
- Véase también
Paso 1 — Definir un trabajo
Un trabajo es una struct serializable que implementa Job. El payload es lo que
se encola (serializado a JSON); run() es el trabajo. NAME enruta un payload
encolado de vuelta a su handler, así que debe ser único.
Genera un esqueleto con la CLI — cargo run -- make:job WelcomeEmail escribe
src/welcome_email.rs; añade pub mod welcome_email; a src/lib.rs — o
escríbelo a mano:
// src/welcome_email.rs
use rustango::jobs::{Job, JobError};
use serde::{Deserialize, Serialize};

#[derive(Serialize, Deserialize)]
pub struct WelcomeEmail {
    pub to: String,
}

#[async_trait::async_trait]   // the scaffolded Cargo.toml has `async-trait`
impl Job for WelcomeEmail {
    const NAME: &'static str = "welcome_email";

    async fn run(&self) -> Result<(), JobError> {
        tracing::info!(to = %self.to, "welcome email job ran");
        Ok(())
    }
}
run() recibe solo el payload: ni pool de base de datos ni mailer. Así que pon en
el payload lo que el trabajo necesita, como la dirección.
El Paso 4 le da al trabajo un mailer para
que pueda enviar de verdad.
run() retorna:
Ok(())— hecho.Err(JobError::Retryable(msg))— transitorio; el worker reintenta con backoff.Err(JobError::Fatal(msg))— permanente; omite reintentos, dead-letter inmediato.
Sobrescribe const MAX_ATTEMPTS: u32 = 3; en la impl para cambiar el tope de
intentos totales — no de reintentos. El valor por defecto de 5 es una
ejecución inicial más cuatro reintentos; MAX_ATTEMPTS = 3 da dos reintentos.
0 cuenta como 1: el trabajo se ejecuta una vez.
Un handler que necesita estado que el payload no puede llevar, como un mailer,
se registra con queue.register_with(move |job: WelcomeEmail| async move { … }).
Esa closure se ejecuta en lugar de Job::run y puede guardar valores que muevas a
ella. Ambas colas incluidas lo admiten. El Paso 4 muestra uno completo.
Paso 2 — Iniciar una cola
Para un único proceso (y para dev y tests), InMemoryJobQueue ejecuta los
trabajos en tareas worker de tokio — sin base de datos. Registra cada tipo de
trabajo, luego start() los workers (los trabajos no se recogen hasta que lo
hagas):
use rustango::jobs::{InMemoryJobQueue, JobQueue};
use std::sync::Arc;

let queue = Arc::new(InMemoryJobQueue::with_workers(4));   // 4 worker tasks
queue.register::<WelcomeEmail>().await;                    // before start/dispatch
queue.start().await;

// ... app runs ...

queue.shutdown().await;   // on shutdown: drain in-flight jobs, then stop
shutdown() da a los trabajos en curso un periodo de gracia (shutdown_grace,
5 s por defecto), y luego los aborta y los vuelve a encolar. Los trabajos en cola
y los reintentos aparcados siguen en cola, y un nuevo start() los recoge.
Los trabajos son at-least-once. Un trabajo en curso ve la parada con
JobCtx::stopping, y un trabajo
abortado vuelve a ejecutarse desde el principio (la cola en BD
libera su fila aunque el trabajo acabara de terminar). El aborto gasta un intento.
Haz que cada trabajo sea idempotente.
Mantén el Arc<InMemoryJobQueue> en el estado de tu aplicación para que los
handlers puedan alcanzarlo.
In-memory significa in-memory. Los trabajos encolados o en curso se pierden al reiniciar. Para todo lo que no puedas permitirte perder, usa la cola persistente.
Paso 3 — Despachar desde un handler
Una vez la cola está en marcha, despachar es una sola llamada — encola y retorna de inmediato, así que la petición no espera al trabajo:
queue.dispatch(&WelcomeEmail { to: "[email protected]".into() }).await?;
Un worker lo recoge y ejecuta run() momentos después. Verificado de extremo a
extremo: los tres trabajos despachados se ejecutan todos en los workers.
for to in ["[email protected]", "[email protected]", "[email protected]"] {
    queue.dispatch(&WelcomeEmail { to: to.into() }).await.unwrap();
}
// → all three WelcomeEmail::run() calls execute on the worker pool
Paso 4 — Cablearlo en tu aplicación
Juntando los pasos 1–3 para la aplicación de Primeros pasos: dale al trabajo un mailer, regístralo una sola vez en el arranque, inicia los workers, entrega la cola a una ruta y drena al apagar.
Primero el archivo del trabajo. Conserva el trabajo WelcomeEmail del Paso 1 y
añade dos cosas: una función register y una ruta /signup.
// src/welcome_email.rs
use std::sync::Arc;

use axum::{http::StatusCode, routing::post, Extension, Json, Router};
use rustango::email::{BoxedMailer, Email};
use rustango::jobs::{InMemoryJobQueue, Job, JobError, JobQueue};
use serde::{Deserialize, Serialize};

#[derive(Serialize, Deserialize)]
pub struct WelcomeEmail {
    pub to: String,
}

#[async_trait::async_trait]
impl Job for WelcomeEmail {
    const NAME: &'static str = "welcome_email";

    // Not called here: `register` below gives the queue a handler instead.
    async fn run(&self) -> Result<(), JobError> {
        tracing::info!(to = %self.to, "welcome email job ran");
        Ok(())
    }
}

/// Register the job with a handler that holds the mailer. Call it once at
/// boot, before `start()`.
pub async fn register<Q: JobQueue>(queue: &Q, mailer: BoxedMailer) {
    queue
        .register_with(move |job: WelcomeEmail| {
            // The closure runs once per job, so each run takes its own copy.
            let mailer = mailer.clone();
            async move {
                Email::new()
                    .to(job.to)
                    .subject("Welcome")
                    .body("Thanks for signing up.")
                    .send(&*mailer)
                    .await
                    .map_err(|e| {
                        if e.is_retryable() {
                            JobError::Retryable(e.to_string()) // mail server down
                        } else {
                            JobError::Fatal(e.to_string()) // bad address: no retry
                        }
                    })
            }
        })
        .await;
}

#[derive(Deserialize)]
pub struct Signup {
    pub email: String,
}

async fn signup(
    Extension(queue): Extension<Arc<InMemoryJobQueue>>,
    Json(form): Json<Signup>,
) -> StatusCode {
    // ... create the user here ...
    // `dispatch` returns at once; a worker sends the email.
    match queue.dispatch(&WelcomeEmail { to: form.email }).await {
        Ok(()) => StatusCode::CREATED,
        Err(e) => {
            tracing::error!(error = %e, "could not queue the welcome email");
            StatusCode::INTERNAL_SERVER_ERROR
        }
    }
}

pub fn router(queue: Arc<InMemoryJobQueue>) -> Router {
    Router::new()
        .route("/signup", post(signup))
        .layer(Extension(queue))
}
mailer es un Arc, así que &*mailer pasa el mailer que lleva dentro.
Luego src/main.rs. Es el archivo generado de Primeros pasos, con la cola
añadida. El scaffolder pone el cuerpo en run(); las líneas van ahí. Las líneas
marcadas con NEW son las nuevas — conserva las líneas del admin y de los ajustes:
// src/main.rs: keep the scaffolded main(), which calls run()
use std::sync::Arc;

use myblog::urls;
use rustango::jobs::{InMemoryJobQueue, JobQueue}; // NEW

async fn run() -> Result<(), Box<dyn std::error::Error>> {
    let _ = dotenvy::dotenv();
    let loaded = rustango::config::Settings::load_from_env();
    let settings = loaded.as_ref().cloned().unwrap_or_default();
    let admin_settings = settings.clone();

    // NEW 1. The mailer, from the [mail] settings (see the email guide).
    let mailer = rustango::email::from_settings(&settings.mail)?;

    // NEW 2. Build the queue and register every job type BEFORE start().
    let queue = Arc::new(InMemoryJobQueue::with_workers(4));
    myblog::welcome_email::register(&*queue, mailer).await;
    queue
        .on_dead_letter(|dl| async move {
            tracing::error!(job = dl.name, attempts = dl.attempts, error = %dl.error,
                            "job dead-lettered");
        })
        .await;

    // NEW 3. Start the workers — tokio tasks that run inside THIS process.
    queue.start().await;
    let draining = Arc::clone(&queue);

    rustango::manage::Cli::new()
        // NEW 4. Mount the /signup route, which holds the queue.
        .api(urls::api().merge(myblog::welcome_email::router(queue)))
        .try_nest_with(urls::admin_prefix(&settings), move |pool| {
            urls::admin_router(pool, &admin_settings)
        })
        .with_health()
        .with_loaded_settings(loaded)
        // NEW 5. Drain the queue after the server stops (SIGINT and SIGTERM).
        .on_shutdown(move || async move { draining.shutdown().await })
        .run()
        .await
}
Pruébalo con cargo run y, en otra terminal:
curl -X POST http://localhost:8080/signup \
     -H "content-type: application/json" \
     -d '{"email":"[email protected]"}'
La petición responde 201 al momento. Con el backend de correo por defecto (la
consola), el correo aparece en la terminal del servidor un instante después.
Para enviar un Email que construyes en el handler no necesitas tu propio tipo de
trabajo: rustango::email_jobs::register_email_job y dispatch_email lo hacen en
dos llamadas. Mira
Envíalo fuera de la petición.
Pon el drenaje en
on_shutdown, no después derun(). Las versiones anteriores de este ejemplo llamaban aqueue.shutdown()en la línea posterior arun(), y esa línea no podía ejecutarse nunca: nada manejaba SIGTERM, así que la parada del orquestador mataba el proceso de inmediato. Ahorarun()retorna con la señal — peroon_shutdownsigue siendo el lugar correcto, porque también se ejecuta en la ruta de tenancy y se ordena bien respecto al drenaje del servidor.
Almacena el tipo de cola concreto. El trait
JobQueueno es object-safe (susregister/dispatchson genéricos), así que no puedes mantenerArc<dyn JobQueue>en el estado — conserva elArc<InMemoryJobQueue>concreto (oArc<DatabaseJobQueue>).
Un trabajo que lee la base de datos
En main.rs un trabajo no puede guardar el pool de base de datos del servidor.
Cli abre ese pool cuando arranca el servidor, y eso ocurre después de construir
tu cola. Tienes dos opciones:
- Pon los datos en el payload, como hace
WelcomeEmailcon la dirección. El handler sí puede leer la base de datos: una ruta montada connest_withrecibe el pool, como en Primeros pasos, Paso 12b. - Ejecuta el trabajo en un proceso worker.
Abre su propio pool, y
register_withpuede guardar el pool junto al mailer.
Ejecutar los workers (CLI + producción)
start() lanza los workers como tareas de tokio dentro del proceso actual.
Así que cuando arrancas tu aplicación con la CLI — cargo run (que ejecuta el
servidor) — los workers corren justo a su lado. Para la mayoría de las
aplicaciones eso es todo lo que necesitas: un proceso sirve peticiones y
drena la cola; no hay un comando worker aparte.
cargo run                 # starts the server AND the in-process workers
cargo run -- make:job WelcomeEmail   # scaffold a new job type
Un proceso worker dedicado (producción)
A escala, a menudo quieres los workers separados del nivel web — para que un
pico de tráfico no pueda dejar sin recursos a los trabajos, y para escalar cada
uno de forma independiente. Con la cola
persistente cada proceso extrae de la misma
tabla rustango_jobs, así que simplemente ejecuta un segundo binario, sin
servidor, que construye la cola, la inicia y bloquea hasta una señal.
cargo run -- make:worker Worker escribe un esqueleto. Aquí el worker abre su
propio pool, así que su closure de register_with puede guardar el pool y el
mailer. El trabajo lee el modelo Post de Primeros pasos:
// src/bin/worker.rs — run with `cargo run --bin worker`
use std::sync::Arc;

use myblog::blog::models::Post;
use myblog::welcome_email::WelcomeEmail;
use rustango::email::Email;
use rustango::jobs::{DatabaseJobQueue, JobError, JobQueue};
use rustango::sql::{FetcherPool, Pool};

#[rustango::main]
async fn main() -> Result<(), Box<dyn std::error::Error>> {
    // A worker never runs main.rs, so it loads `.env` and the settings itself.
    let _ = dotenvy::dotenv();
    let settings = rustango::config::Settings::load_from_env()?;
    let mailer = rustango::email::from_settings(&settings.mail)?;
    let pool = Pool::connect_from_env().await?; // DATABASE_URL
    DatabaseJobQueue::ensure_table_pool(&pool).await?;

    let queue = Arc::new(DatabaseJobQueue::with_workers_pool(pool.clone(), 8));
    // Register the SAME job types the web process dispatches.
    queue
        .register_with(move |job: WelcomeEmail| {
            let pool = pool.clone();
            let mailer = mailer.clone();
            async move {
                let posts = Post::objects()
                    .fetch(&pool)
                    .await
                    .map_err(|e| JobError::Retryable(e.to_string()))?;
                Email::new()
                    .to(job.to)
                    .subject("Welcome")
                    .body(format!("There are {} posts waiting for you.", posts.len()))
                    .send(&*mailer)
                    .await
                    .map_err(|e| JobError::Retryable(e.to_string()))
            }
        })
        .await;
    queue.start().await;

    // Blocks until Ctrl-C (SIGINT) *or* SIGTERM. `tokio::signal::ctrl_c()`
    // alone is SIGINT-only on Unix, so a worker waiting on it is killed
    // outright by `docker stop` / a pod eviction and drains nothing.
    rustango::shutdown::shutdown_signal().await;
    queue.shutdown().await;                     // drain in-flight, then exit
    Ok(())
}
Despliégalo como su propio contenedor/servicio y escálalo a N réplicas —
todas extraen de la tabla compartida de forma segura. El proceso web entonces
solo necesita dispatch, pero debe register cada tipo de job que despacha (sin start()), o construir su cola con .allow_unregistered_dispatch(); un dispatch no registrado se rechaza. Empareja el worker
con un barrido periódico
reclaim_stuck_jobs_pool para recuperar
trabajos de un worker que se ha caído.
Dos colas distintas sobre una tabla (por ejemplo, un mailer y un generador de
informes con sus propios handlers) se quitan los trabajos entre sí. Da a cada una
su nombre con .queue_name("mailer") en el lado que despacha y en el que
trabaja: una cola con nombre solo ejecuta sus trabajos, y una sin nombre solo los
trabajos sin nombre. Los workers anteriores a queue_name lo ignoran y ejecutan
también los trabajos con nombre: detenlos antes de despachar en una cola con
nombre.
Reintentos y backoff
Un trabajo que retorna Retryable se reencola con backoff exponencial (1s,
2s, 4s, 8s, …, con tope en 1024s) hasta agotar MAX_ATTEMPTS intentos totales.
Úsalo para fallos transitorios — un timeout, una API con límite de tasa, un
deadlock:
#[async_trait::async_trait]
impl Job for FlakyImport {
    const NAME: &'static str = "flaky_import";
    async fn run(&self) -> Result<(), JobError> {
        match call_external_api().await {
            Ok(_)  => Ok(()),
            Err(e) => Err(JobError::Retryable(e.to_string())),   // try again later
        }
    }
}
El test que lo respalda despacha un trabajo que falla una vez y luego tiene éxito, y afirma que se ejecutó más de una vez y finalmente tuvo éxito — el reintento realmente ocurre.
Para cambiar la espera de todos los trabajos de un tipo, sobrescribe
fn retry_backoff(failed_attempt: u32) -> Duration en el impl (failed_attempt vale
0 tras la primera ejecución). Para fijar el límite o la espera a partir del payload,
sobrescribe fn max_attempts(&self) -> u32 o
fn retry_delay(&self, failed_attempt: u32) -> Duration; por defecto devuelven
MAX_ATTEMPTS y retry_backoff. El límite se lee al despachar.
jobs::exponential_backoff(base, failed_attempt) es la curva por defecto con tu
propia base: base, doblada por cada fallo, con tope en base · 1024.
El contexto del trabajo: id, intento, parada
Ambas colas llaman a Job::run_with(&self, ctx: &JobCtx). Por defecto llama a
run(), así que los trabajos que solo implementan run funcionan sin cambios.
Sobrescríbelo para leer:
ctx.id()— el id del trabajo, el mismo en cada reintento. Único solo en su cola.ctx.idempotency_key(scope)— el id bajo tu ámbito, para un sistema externo.ctx.attempt()— 1 en la primera ejecución, 2 en el primer reintento.ctx.stopping()/ctx.is_stopping()— la cola se está deteniendo; termina dentro deshutdown_graceo la ejecución se aborta y vuelve a la cola.
Usa idempotency_key como la clave que ve un sistema externo, para que un cobro
reintentado no se cobre dos veces. El id de la cola en BD es el id de la fila más
su momento de encolado, así que una tabla recreada no lo repite. Los tenants con
su propia tabla de trabajos empiezan igualmente en la fila 1; pasa un ámbito que
distinga las tablas, como el slug del tenant:
use rustango::jobs::{Job, JobCtx, JobError};

#[async_trait::async_trait]
impl Job for ChargeCard {
    const NAME: &'static str = "charge_card";

    async fn run(&self) -> Result<(), JobError> {
        Err(JobError::Fatal("ChargeCard runs through run_with".into()))
    }

    async fn run_with(&self, ctx: &JobCtx) -> Result<(), JobError> {
        let key = ctx.idempotency_key(&self.tenant);   // la misma clave en cada reintento
        stripe_charge(self.order_id, self.cents, &key)
            .await
            .map_err(|e| JobError::Retryable(e.to_string()))
    }
}
Un handler pasado a register_with recibe solo el payload, no el contexto.
El handler dead-letter
Cuando un trabajo agota sus reintentos — o retorna Fatal de inmediato — se
entrega al callback dead-letter en lugar de desvanecerse. Registra uno (antes
de start) para registrar, alertar o persistir el fallo:
queue
    .on_dead_letter(|dl| async move {
        // dl: JobDeadLetter { name, payload, attempts, error }
        tracing::error!(job = dl.name, attempts = dl.attempts, error = %dl.error,
                        "job dead-lettered");
    })
    .await;
Un error Fatal omite los reintentos y aterriza aquí en el primer intento:
async fn run(&self) -> Result<(), JobError> {
    Err(JobError::Fatal("unprocessable payload".into()))   // → dead-letter now
}
El test confirma que el callback se dispara exactamente una vez para un trabajo
Fatal, con el name y el error del trabajo intactos.
La cola persistente (producción)
InMemoryJobQueue es de un solo proceso y olvida al reiniciar. Para despliegues
reales — múltiples workers, múltiples réplicas, trabajos que deben sobrevivir a
una caída — usa DatabaseJobQueue (el mismo tipo que PgJobQueue). Los
trabajos viven en una tabla rustango_jobs; los workers reservan una fila dentro
de una transacción (FOR UPDATE SKIP LOCKED en PostgreSQL y MySQL, un solo
UPDATE … RETURNING en SQLite), así que es seguro entre procesos.
Es tri-dialecto (PostgreSQL, MySQL, SQLite). Las definiciones Job del paso
1 no cambian.
use rustango::jobs::DatabaseJobQueue;   // = rustango::jobs::pg::PgJobQueue
use rustango::jobs::JobQueue;
use std::sync::Arc;
use std::time::Duration;

// 1. Create the jobs table once at boot (idempotent, tri-dialect).
DatabaseJobQueue::ensure_table_pool(&pool).await?;

// 2. Build the queue over your pool + N workers, and start it.
let queue = Arc::new(
    DatabaseJobQueue::with_workers_pool(pool.clone(), 4)
        .poll_interval(Duration::from_millis(50)),
);
queue.register::<WelcomeEmail>().await;
queue.start().await;

// 3. Dispatch exactly as before — now it's durable.
queue.dispatch(&WelcomeEmail { to: "[email protected]".into() }).await?;
Despachar dentro de una transacción. Dentro de un bloque atomic sobre el
propio pool de la cola, dispatch se une al bloque: el trabajo se revierte con
él, y ningún worker despierta antes del commit. No mantengas el TxGuard del
bloque durante la llamada.
Recuperar workers caídos. Si un worker muere a mitad de un trabajo, la fila queda bloqueada. Ejecuta un barrido periódico para liberar los bloqueos más antiguos que un umbral, de modo que otro worker retome el trabajo:
// e.g. from a scheduled task every few minutes:
let reclaimed = DatabaseJobQueue::reclaim_stuck_jobs_pool(&pool, Duration::from_secs(300)).await?;
O deja que lo haga la cola: .reclaim_stuck_after(Duration::from_secs(300)) en el
builder barre el pool de la cola al hacer start y luego cada
min(umbral, 60s). Está apagado por defecto, y el umbral se eleva al menos a tres
heartbeats.
Un trabajo en curso renueva su bloqueo cada heartbeat_interval (10 s por
defecto), así que mantén el umbral muy por encima. Cada recogida gasta un intento,
así que un trabajo que tumba a su worker va a dead-letter cuando se agotan las
MAX_ATTEMPTS ejecuciones. Un trabajo que hace panic es un fallo Retryable; el
worker sigue funcionando.
Tanto el flujo dispatch-and-run como reclaim_stuck_jobs_pool se prueban con
dogfooding contra SQLite en jobs_sqlite_live.rs.
Trabajos con multi-tenancy
Un worker no es un request. Nada resolvió un tenant para él — ningún host,
ninguna cabecera, ningún middleware se ejecutó — así que un trabajo no lleva
contexto de tenant: run(&self) solo recibe el payload deserializado. El
aislamiento viene del pool sobre el que se construyó la cola, y de ahí sale
la regla:
Una cola por pool de tenant. Un id de tenant en el payload es enrutado, no aislamiento.
Esa única decisión es la que hace seguro cada modo:
| Modo | Dónde vive rustango_jobs | Por qué un worker permanece acotado |
|---|---|---|
database | dentro de la propia base de datos / archivo SQLite del tenant | las filas de otro tenant no están en la tabla que consulta el worker — las lecturas entre tenants no son expresables |
schema (PG) | en el esquema del tenant | scoped_pool_dyn devuelve un pool con search_path incorporado en sus connect options, no un SET por request — así cada checkout queda acotado durante toda la vida del pool, incluido un worker que viva días |
Construye las colas en el arranque, una por tenant activo:
use rustango::core::Column as _;
use rustango::jobs::{DatabaseJobQueue, JobQueue};
use rustango::sql::FetcherPool as _;
use rustango::tenancy::{Org, TenantPools};
use std::sync::Arc;
use std::time::Duration;
let pools = Arc::new(TenantPools::new(registry));
let registry_pool = pools.registry_pool();
// The registry holds the tenant list; each `Org` names its own
// database (or PG schema).
let orgs: Vec<Org> = Org::objects()
.where_(Org::active.eq(true))
.fetch(®istry_pool)
.await?;
let mut queues = Vec::new();
for org in orgs {
let pool = pools.scoped_pool_dyn(&org).await?; // scoped for its lifetime
DatabaseJobQueue::ensure_table_pool(&pool).await?;
let queue = Arc::new(
DatabaseJobQueue::with_workers_pool(pool, 2)
.poll_interval(Duration::from_secs(1)),
);
queue.register::<WelcomeEmail>().await;
queue.start().await;
queues.push((org.slug, queue));
}
El despacho va entonces a la cola de ese tenant — en un handler de request, a
la que está indexada por el Org que el resolver ya produjo.
Qué no hacer. Una sola cola sobre el pool del registry con un campo
org_id en el payload pone los trabajos de todos los tenants en una tabla
compartida, y deja a cada run() la tarea de acordarse de reacotar. Un solo
reacotado olvidado es una escritura entre tenants. Si necesitas una cola
compartida por razones operativas, resuelve el pool del tenant como lo
primero que hace run() y no vuelvas a tocar el pool del registry después.
Límites conocidos. El framework no hace el fan-out por ti: no hay
supervisor de workers por tenant, ni Job::run(&ctx) con el tenant adjunto, ni
un barrido reclaim_stuck_jobs_pool consciente del tenant — iteras sobre los
tenants tú mismo, como arriba (.reclaim_stuck_after(..) en la cola de cada
tenant barre el pool de ese tenant). Los tenants provisionados después del arranque
no obtienen workers hasta que el proceso se reinicia. Es una carencia conocida.
Contexto ambiental: solo fuente de auditoría y zona horaria.
InMemoryJobQueue los captura en dispatch y el scheduler en every(), y
ambos los reinstalan alrededor de la ejecución. PgJobQueue los guarda en
rustango_jobs.context; ensure_table_pool añade la columna a una tabla
antigua. Sin la columna, los trabajos corren como AuditSource::System.
Ninguna cola lleva sesión ni tenant.
Una fuente del admin del tenant nombra a un usuario de ese tenant, así que solo
se registra en escrituras por el pool que tenancy::with_tenant (o
for_each_tenant) entrega para ese tenant. Las demás escrituras, también las
hechas por otro pool dentro, registran system:
rustango::tenancy::with_tenant(&pools, &org, |pool| async move {
    note.insert(&pool).await
})
.await??;
Barridos programados con multi-tenancy
El mismo problema de «un worker no es un request» golpea al trabajo basado en
el tiempo, y los propios helpers de barrido del framework son donde muerde:
MediaManager::purge_orphans, audit::cleanup_older_than_pool y
prunable::prune_all toman un solo pool, y cada tabla que tocan es por
tenant. Un pool significa un tenant — y un pool del registry en modo esquema
significa solo public, mientras las filas de cada tenant se acumulan y el
barrido igual informa éxito.
Haz el fan-out con for_each_tenant, que resuelve el pool propio de cada
tenant activo y sigue adelante cuando uno falla:
use rustango::tenancy::for_each_tenant;

let opts = &opts;
let sweep = for_each_tenant(&pools, move |_org, pool| async move {
    rustango::prunable::prune_all(&pool, opts).await
})
.await?;

tracing::info!(ok = sweep.succeeded(), failed = sweep.failed(), "nightly prune");
for (slug, err) in sweep.errors() {
    tracing::warn!(%slug, %err, "tenant prune failed");
}
Un tenant roto — credencial rotada, base de datos inalcanzable — queda
registrado en el informe en lugar de abortar la ejecución, de modo que no puede
dejar sin barrer a los tenants que van después. Las orgs inactivas se omiten.
purge_orphans es el único barrido que sale de la base de datos (borra objetos
de almacenamiento), así que tiene purge_orphans_dry_run: la misma consulta,
sin borrar nada — vale la pena mirarlo antes de cablear el barrido real.
Si proteges el barrido para que solo una réplica lo ejecute, acota el lock por tenant:
use rustango::cache::CacheScope;

let tenant = TenantSlug::of(&org).expect("a registry org");
let lock = CacheScope::for_tenant(cache.clone(), &tenant).locks();
// Tick every minute; this runs once per UTC day across replicas.
lock.once_per_period("nightly_prune", day, || prune(&org)).await;
Sin acotar, todos los tenants compiten por un único lock:nightly_prune: el
primero gana y el resto se omite durante toda la TTL, en silencio — un acquire
rechazado es el resultado esperado, así que no se registra nada. Es una carencia conocida.
Referencia
Backends
| Backend | Usar para | ¿Sobrevive al reinicio? |
|---|---|---|
InMemoryJobQueue | un solo proceso, dev, tests | no |
DatabaseJobQueue (PgJobQueue) | producción; multi-worker / multi-réplica | sí (tabla rustango_jobs) |
JobError
| Variante | Efecto |
|---|---|
Retryable(String) | reencolar con backoff exponencial, hasta MAX_ATTEMPTS |
Fatal(String) | omitir reintentos → dead-letter de inmediato |
Queue(String) | error interno de la cola (serialización/registro) |
Métodos de JobQueue: register::<T>() · dispatch(&payload) · start() ·
register_with::<T, _, _>(handler) · shutdown() · pending_count() (trabajos
esperando a ser recogidos). Job::run_with recibe un JobCtx (id, attempt,
stopping). Ambas colas tienen on_dead_letter y
shutdown_grace. DatabaseJobQueue añade ensure_table_pool,
with_workers_pool, new_pool, poll_interval, heartbeat_interval,
queue_name, reclaim_stuck_after y reclaim_stuck_jobs_pool.
jobs::inmemory_from_settings(&settings.jobs) construye una InMemoryJobQueue
con [jobs] concurrency workers (4 por defecto).
Véase también
- Planificador — para trabajo recurrente basado en el tiempo
a intervalo fijo (
Scheduler::every+Duration; no hay expresiones cron), en contraste con los trabajos bajo demanda. - Correo — la carga de trabajo canónica del «hazlo en un trabajo».
- Caché — la otra manera de mantener rápidos los handlers de peticiones.
- Signals — hooks fire-and-forget que a menudo despachan un trabajo.
- Comandos de tenancy — el provisionamiento de los tenants sobre los que una cola por tenant hace fan-out.