 Rustango
Livre de recettes de l'ORM
Modèles d'utilisation de l'ORM Rustango au-delà des bases. Si vous avez déjà travaillé avec un ORM, les formes présentées ici vous sembleront familières. La plupart des exemples supposent que vous disposez déjà d'un modèle Post issu de Getting Started.
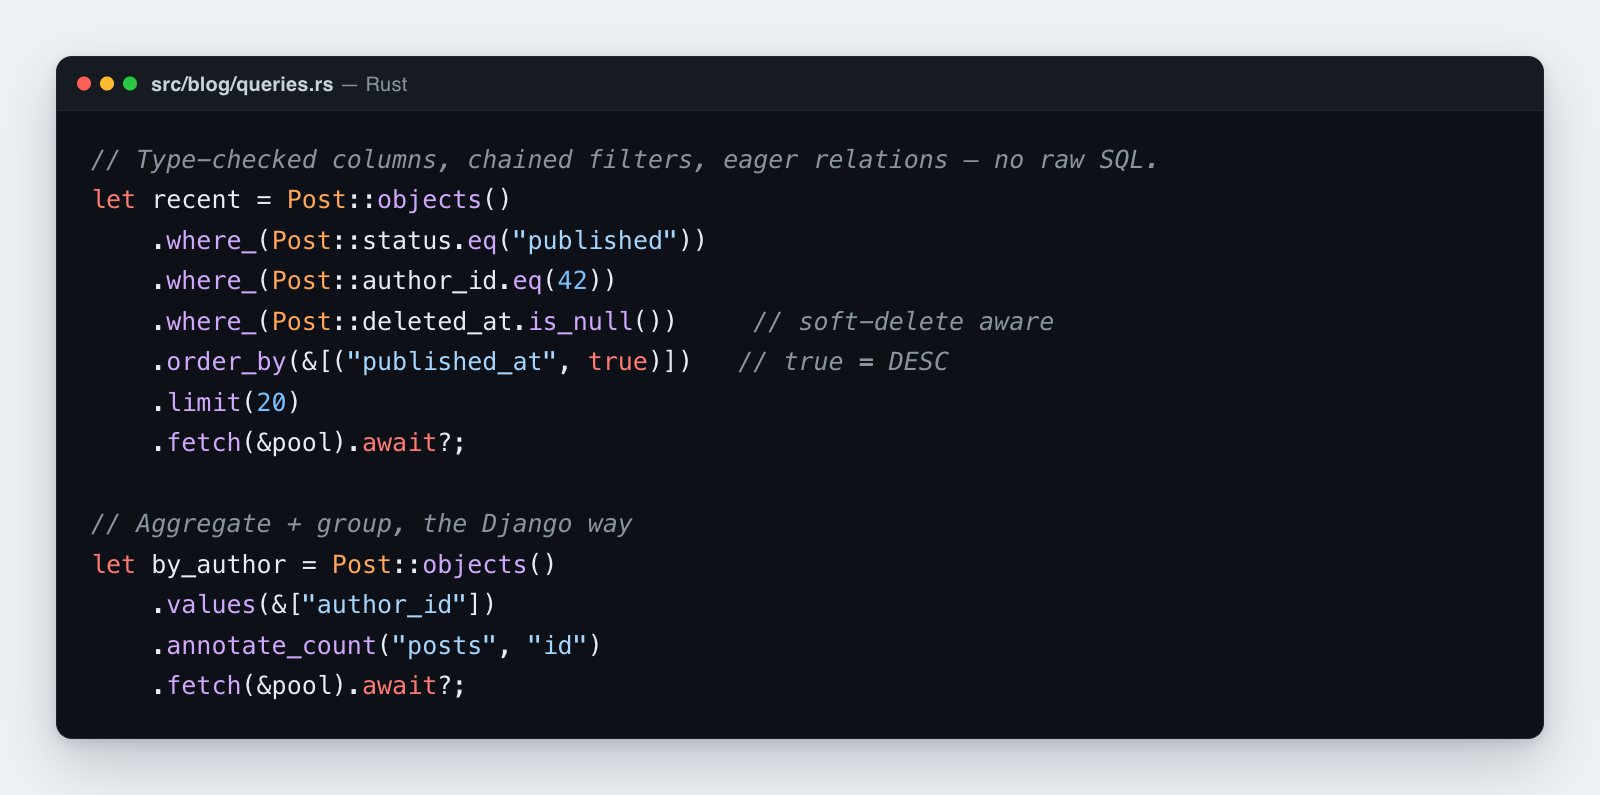
Source :
rustango::sql(QuerySet, la macroQ!/ le builderquery::Q) et l'API de requêtes#[derive(Model)]— toujours compilée ; choisissez une fonctionnalité de backend (postgres/mysql/sqlite).Version exécutable : les modèles présentés ici s'exécutent dans l'exemple testé
orm_cookbook.Un terme vous est inconnu ? Le glossaire définit model, queryset, pool et migration en langage simple.
Quelques termes Rust reviennent tout au long du document. &pool est une référence partagée vers un pool de connexions — ici un rustango::sql::Pool, l'énumération multi-backends que prennent fetch, count et les writers (save, insert, delete). Les méthodes _on prennent n'importe quel SqlExecutor : ce &pool, une connexion tenue ou une transaction ouverte. sql::Pool n'a pas de begin() ; ses points d'entrée de transaction sont transaction_pool et atomic. .await lance un appel asynchrone et attend le résultat. Option<T> est une valeur qui peut être présente (Some) ou absente (None) — le null de Rust. Result représente un succès ou une erreur ; le ? en fin d'appel provoque un retour anticipé en cas d'erreur. Auto<i64> est une clé primaire à incrémentation automatique qui est soit Set (chargée depuis la base) soit Unset (pas encore insérée).
Ajouts récents
Les versions récentes ont ajouté un lot de fonctionnalités qui ne sont pas encore intégrées à toutes les sections ci-dessous. Repères rapides :
- Macro
Q!+ builder d'exécutionquery::Q— filtres sûrs à la compilation.User::objects().where_(Q!(User.email__icontains = "alice"))échoue à la compilation si un nom de champ comporte une faute de frappe. Variante composable à l'exécution pour les puces de filtre de l'admin :let q = rustango::query::Q::eq("active", true) & rustango::query::Q::gt("age", 18i64);. .distinct_on(&["author_id"])— natif sur PG ; repli portable via fonction de fenêtrage sur MySQL / SQLite. Modèles « le plus récent par groupe ».bulk_upsert_pool(rows, unique_fields, update_fields, &pool)— insère de nombreuses lignes en une instruction, ou les met à jour en cas de conflit.ON CONFLICT/ON DUPLICATE KEY UPDATEtri-dialecte. Si une clé se répète, la dernière ligne gagne.explain_pool()— EXPLAIN tri-dialecte. PGEXPLAIN (FORMAT JSON, ANALYZE, BUFFERS)/ MySQLEXPLAIN ANALYZE/ SQLiteEXPLAIN QUERY PLAN.- Bibliothèque de fonctions SQL —
Cast,LPad,RPad,MD5,SHA1,SHA256,Position,Repeat,Reverse,Sign,Mod,Power,Sqrt. Émission par dialecte avec des erreurs claires là où SQLite ne dispose pas de la fonction. - Types de champ —
rust_decimal::Decimal(natif sur PG/MySQL, via un shim Decode sur SQLite),chrono::NaiveTime,Vec<u8>(FieldType::Binary) sont désormais acceptés par#[derive(Model)](v0.42). ModelForm::prepare_save()/PreparedSave(v0.42) — valider sans écrire tout de suite. Validez maintenant, modifiez l'ensemble d'écriture préparé, puis validez quand vous êtes prêt.#[rustango(unique_when(columns = "...", condition = "..."))]— contraintes d'unicité partielles. « E-mail unique par ligne non supprimée » / « Slug unique par tenant ».manage makemigrations --merge(v0.42) — nœud de fusion pour les chaînes de branches divergentes. Voirdocs/manage.md.
Le CHANGELOG contient l'index complet des tickets pour chaque version.
Table des matières
- Requêtes
- Valeurs calculées et fonctions de base de données
- Agrégations
- Jointures et préchargement des lignes liées
- Opérations en masse
- Insertion ou mise à jour (upsert)
- Transactions
- Plusieurs-à-plusieurs
- JSON / JSONB
- Suppression logique
- Journal d'audit
- Échappatoire vers le SQL brut
- Chargement paresseux des clés étrangères
- Quatre façons de filtrer
- Requêtes limitées au tenant
- Signaux
- Conseils de performance
Requêtes
use rustango::prelude::*; importe d'un coup les traits d'extension de l'ORM (FetcherPool, CounterPool, ExistsPool, UpdaterPool, FetcherTx), Column, Model et Auto. Sans eux, .count(&pool) ou .fetch(&pool) échoue avec "QuerySet is not an iterator". Les exemples ci-dessous importent chaque trait par son nom.
Lit des lignes depuis la base de données. Post::objects() démarre une requête ; vous chaînez les filtres et le tri, puis appelez .fetch(&pool).await? pour l'exécuter et récupérer un Vec<Post>. .where_(...) ajoute une condition jointe par AND.
use rustango::core::Column as _;
use rustango::core::{Op, SqlValue, WhereExpr};   // for filter_op / where_raw below
use rustango::sql::FetcherPool as _;

// Simplest — fetch all
let posts = Post::objects().fetch(&pool).await?;

// Single equality filter
let drafts = Post::objects()
    .where_(Post::status.eq("draft"))
    .fetch(&pool).await?;

// Chained filters (AND)
let recent_drafts = Post::objects()
    .where_(Post::status.eq("draft"))
    .where_(Post::author_id.eq(42))
    .where_(Post::deleted_at.is_null())
    .order_by(&[("created_at", true)])        // true = DESC
    .limit(20)
    .fetch(&pool).await?;

// String-keyed filter (validated at compile of the queryset)
let by_id = Post::objects()
    .filter_op("id", Op::Eq, SqlValue::I64(42))
    .fetch(&pool).await?;

// OR / nested
let qs = Post::objects().where_raw(WhereExpr::Or(vec![
    Post::status.eq("draft").into(),
    Post::status.eq("review").into(),
]));

// XOR. Matches rows where an odd number
// of operands evaluate to true (binary case = "exactly one is true").
let either_but_not_both = Post::objects()
    .where_(Post::status.eq("draft").xor(Post::author_id.eq(42)))
    .fetch(&pool).await?;
// Tri-dialect emission: native logical XOR exists on MySQL but not PG
// or SQLite, so the writer emits a portable CASE-WHEN-1/0 tally
// `% 2 = 1`; a NULL operand counts as false.
Filtres de comparaison
Les méthodes de filtrage du quotidien, une par opérateur SQL. Ce sont les lookups de champ (__gt, __in, __icontains, etc.) sous forme typée.
Post::objects().where_(Post::view_count.gt(100)).fetch(&pool).await?;
Post::objects().where_(Post::view_count.gte(100)).fetch(&pool).await?;
Post::objects().where_(Post::view_count.lt(100)).fetch(&pool).await?;
Post::objects().where_(Post::view_count.lte(100)).fetch(&pool).await?;
Post::objects().where_(Post::status.ne("archived")).fetch(&pool).await?;
Post::objects().where_(Post::id.is_in([1, 2, 3])).fetch(&pool).await?;
Post::objects().where_(Post::status.not_in(["draft", "deleted"])).fetch(&pool).await?;
Post::objects().where_(Post::title.like("%draft%")).fetch(&pool).await?;          // case-sensitive contains
Post::objects().where_(Post::title.ilike("%draft%")).fetch(&pool).await?;         // case-insensitive contains
Post::objects().where_(Post::title.ilike("Hello%")).fetch(&pool).await?;          // case-insensitive starts-with
Post::objects().where_(Post::deleted_at.is_null()).fetch(&pool).await?;
Post::objects().where_(Post::published_at.between(start, end)).fetch(&pool).await?;
Tri des résultats
Trie les lignes selon une ou plusieurs colonnes, selon une expression, ou avec un contrôle explicite de l'emplacement des NULL. Au-delà du .order_by(&[("col", desc)]) de base, vous disposez de trois dimensions supplémentaires :
use rustango::core::funcs::lower;
use rustango::core::{F, NullsOrder};

// 1. Plain field + ASC/DESC (back-compat — implicit NULLS handling
//    differs between dialects; see the dialect note below).
Post::objects()
    .order_by(&[("published_at", true), ("id", false)])
    .fetch(&pool).await?;

// 2. Explicit NULLS FIRST/LAST control — portable across PG, MySQL,
//    and SQLite. MySQL has no native `NULLS …` keyword; the writer
//    emulates with an `<col> IS NULL` pre-sort term so the on-wire
//    ordering matches PG/SQLite.
Post::objects()
    .order_by_with_nulls(&[("score", true, NullsOrder::Last)])
    .fetch(&pool).await?;

// 3. Arbitrary Expr in the ORDER BY position — case-insensitive
//    title sort via `LOWER(title)`, computed sort keys via
//    `case() / when() / value()`, arithmetic via `F("a") + F("b")`.
Post::objects()
    .order_by_expr(lower(F("title")), false)
    .order_by_expr_with_nulls(F("score") + 1_i64, true, NullsOrder::Last)
    .fetch(&pool).await?;
Gestion des NULL par dialecte (aucun NullsOrder explicite défini) :
| Dialecte | Défaut ASC | Défaut DESC |
|---|---|---|
| PostgreSQL | NULLS LAST | NULLS FIRST |
| SQLite | NULLS LAST | NULLS FIRST |
| MySQL | NULL en premier (sémantique de plus petite valeur) | NULL en dernier |
Utilisez .order_by_with_nulls(...) / .order_by_expr_with_nulls(...) pour fixer le placement ; sinon, le défaut natif de la base de données s'applique. Sur MySQL, le writer émet <col> IS NULL <asc|desc> avant le tri réel pour l'émuler ; le SQL émis comporte deux clauses ORDER BY par colonne fixée, mais la sémantique correspond à PG/SQLite.
Composition de la chaîne. .order_by(...), .order_by_with_nulls(...) et .order_by_expr(...) s'accumulent en une seule liste unifiée dans l'ordre d'enregistrement. .replace_order_by(&[...]) efface tous les appels de tri précédents. .flip_order_by() inverse chaque direction ET échange NullsOrder::First ↔ NullsOrder::Last afin que la sémantique « NULL du même côté » survive à une inversion (pour les First / Last explicites ; le comportement par défaut du dialecte sous Default continue de suivre la direction).
Tri aléatoire
Renvoie les lignes dans un ordre aléatoire. Utilisez .order_random(). Cela émet ORDER BY RANDOM() sur PG et SQLite, ORDER BY RAND() sur MySQL. Pratique pour la rotation de bannières, l'échantillonnage ou l'affectation à des groupes de test A/B sans charger les lignes dans l'application pour les mélanger.
// Three random posts.
Post::objects()
    .order_random()
    .limit(3)
    .fetch(&pool).await?;

// Random tie-breaker after a primary sort: posts ordered by score
// descending, with ties shuffled.
Post::objects()
    .order_by(&[("score", true)])
    .order_random()
    .fetch(&pool).await?;
La variante IR ne porte aucune direction ni clause NULLS : le tri aléatoire est par définition non ordonné, et la clé aléatoire est calculée par ligne (non-NULL).
Mise en garde de performance. ORDER BY RANDOM() force un balayage complet de la table + un tri en mémoire selon une clé aléatoire par ligne. Le planificateur de requêtes ne peut pas utiliser d'index. Pour des tables bien plus grandes que la mémoire, préférez le modèle compatible avec les index :
// Coin-flip offset; range-scans the PK index.
let max_id: i64 = Post::objects().max::<i64>("id", &pool).await?.unwrap_or(0);
let offset = rand::random::<u32>() as i64 % max_id.max(1);
Post::objects()
    .where_(Post::id.gte(offset))
    .order_by(&[("id", false)])
    .limit(1)
    .fetch(&pool).await?;
Le compromis : l'adjacence dans les lignes du résultat reflète l'adjacence des clés primaires, ce n'est donc pas « uniformément aléatoire » au sens strict — mais c'est exempt du coût du balayage complet de la table.
Pagination
Récupère une page de résultats à la fois. .limit(size).offset(...) est la forme simple par numéro de page ; la forme par curseur (« tout ce qui suit le dernier id que j'ai vu ») passe mieux à l'échelle sur les grandes tables.
// Page-number — page 2 of 50-row pages = LIMIT 50 OFFSET 50.
let page = Post::objects().limit(50).offset(50).fetch(&pool).await?;

// Cursor (manual — no auto-next-token from QuerySet)
let next = Post::objects()
    .where_(Post::id.gt(last_id))
    .order_by(&[("id", false)])
    .limit(50)
    .fetch(&pool).await?;
Pour la pagination par curseur côté HTTP, utilisez plutôt ViewSet::cursor_pagination("id").
Récupération de lignes dans une map
Recherche de nombreuses lignes selon une liste de valeurs et les récupère sous forme de HashMap indexée par cette colonne. Utilisez .in_bulk(...) pour « récupérer ces N lignes en un seul aller-retour, indexées par id ». Un HashMap<K, V> est le dictionnaire / la table de hachage de Rust.
use std::collections::HashMap;
use rustango::sql::Auto;

// Default shape: keyed by the Auto<i64> PK.
let books: HashMap<i64, Book> = Book::objects()
    .in_bulk(Book::id, [1_i64, 2, 3], |b| match b.id {
        Auto::Set(v) => v,
        Auto::Unset  => unreachable!("fetched row has Auto::Set PK"),
    }, &pool)
    .await?;
assert_eq!(books[&1].title, "The Rust Programming Language");

// `field_name=` equivalent — key by any unique column.
let by_isbn: HashMap<String, Book> = Book::objects()
    .in_bulk(Book::isbn, ["isbn-1".to_string()], |b| b.isbn.clone(), &pool)
    .await?;
Se compose avec les filtres .where_() précédents — la liste IN se joint par AND au WHERE existant. Une liste ids vide court-circuite avec une map vide (aucun SQL n'est émis). La closure gère explicitement le déballage de Auto<T> / ForeignKey<T, K>, donnant aux appelants le contrôle sur la matérialisation de la clé.
Variante limitée au tenant : in_bulk_on(column, ids, extract, &executor) prend n'importe quel SqlExecutor — à combiner avec tenant.conn().await? pour les tenants en mode schéma.
Verrouillage de lignes pour mise à jour
Verrouille les lignes que vous sélectionnez pour qu'aucune autre transaction ne puisse les modifier jusqu'à votre commit — la manière standard de réclamer du travail ou d'éviter les mises à jour perdues. Appelez .select_for_update() ; cela ajoute SELECT … FOR UPDATE (ou une variante) et le verrou dure pendant la transaction englobante.
// Canonical "claim next available row" pattern. Worker A grabs the
// lowest-priority pending job; concurrent worker B with SKIP LOCKED
// skips A's row and grabs the next instead — no blocking.
let mut tx = rustango::sql::write_transaction(&pool).await?;
let claim: Vec<Job> = Job::objects()
    .where_(Job::status.eq("pending"))
    .order_by(&[("priority", false)])
    .limit(1)
    .select_for_update()
    .skip_locked()
    .fetch_on(&mut tx).await?;
// ... mark claim[0] as in-progress, do work ...
tx.commit().await?;
Méthodes du builder — à chaîner pour les activer :
.select_for_update()— un simpleFOR UPDATE..skip_locked()— ajouteSKIP LOCKED; les lignes détenues par une autre transaction sont silencieusement filtrées au lieu de bloquer..nowait()— ajouteNOWAIT; fait remonter immédiatement une erreur du pilote si une ligne correspondante est verrouillée. Mutuellement exclusif avecskip_locked(le writer choisit le plus permissifSKIP LOCKEDsi les deux sont définis)..no_key()— émet plutôtFOR NO KEY UPDATE(PG 9.3+). Verrou plus faible qui ne bloque pas les écrivains ne touchant que des colonnes non clés..of(&["table_or_alias", …])— restreint le verrou à des tables spécifiques lorsque la requête effectue des JOIN.
Appeler .skip_locked() / .nowait() / .no_key() / .of(…) sans un .select_for_update() préalable active implicitement le verrou, pour garder l'appel aussi court que possible.
Comportement tri-dialecte :
| Dialecte | Comportement |
|---|---|
| PostgreSQL | Prise en charge complète — chaque option émet sa syntaxe native. |
| MySQL 8.0.1+ | Prend tout en charge sauf NO KEY — cette option retombe sur un simple FOR UPDATE (le verrou plus strict). |
| SQLite | Aucune syntaxe de verrou au niveau ligne ; le writer n'émet aucune clause. Ouvrez la transaction avec rustango::sql::write_transaction(&pool) : elle prend le verrou d'écriture de la base dès le BEGIN, donc un second worker attend puis voit la ligne réclamée. Une transaction transaction_pool ne verrouille rien avant d'écrire, et le second écrivain échoue avec SQLITE_BUSY. Un bloc atomic fait de même : son bloc SQLite le plus externe démarre par BEGIN IMMEDIATE. |
Doit s'exécuter à l'intérieur d'une transaction. FOR UPDATE hors transaction est une opération sans effet sur PostgreSQL (la transaction implicite à instruction unique libère le verrou immédiatement) et une erreur sur MySQL. Ouvrez-la avec rustango::sql::write_transaction(&pool) et lisez avec .fetch_on(&mut tx) ; cela fonctionne sur chaque backend.
Combinaison de requêtes (union, intersection, différence)
Fusionne deux requêtes ou plus portant sur le même modèle avec les opérateurs d'ensemble SQL : .union(), .intersection() et .difference().
// Posts that are EITHER drafts OR currently in review.
let inbox: Vec<Post> = Post::objects()
    .where_(Post::status.eq("draft"))
    .union(Post::objects().where_(Post::status.eq("review")))
    .order_by(&[("created_at", true)])
    .limit(50)
    .fetch(&pool).await?;
Méthodes du builder :
| Méthode | SQL | Sémantique |
|---|---|---|
.union(other) | UNION | Combine + déduplique |
.union_all(other) | UNION ALL | Combine, conserve les doublons (moins coûteux, pas de passe DISTINCT) |
.intersection(other) | INTERSECT | Lignes présentes dans LES DEUX querysets |
.difference(other) | EXCEPT | Lignes du premier queryset mais PAS des autres |
Chaque méthode prend un QuerySet<T> — les deux branches doivent cibler le même modèle T, de sorte que la forme des colonnes correspond par construction (vérifiée à la compilation par les génériques de Rust). Les appels s'accumulent ; mélanger les opérateurs dans une même chaîne est autorisé (a.union(b).intersection(c) s'évalue de gauche à droite sur chaque backend, comme (a ∪ b) ∩ c).
Les modificateurs externes s'appliquent au résultat fusionné :
// Outer .order_by() / .limit() / .offset() / .select_for_update()
// set AFTER the union apply to the combined resultset, NOT per-branch.
let page: Vec<Post> = qs_a
    .union(qs_b)
    .union(qs_c)
    .order_by(&[("id", false)])    // sorts the merged rows
    .limit(20)                     // caps the merged count
    .offset(40)                    // skips into the merged result
    .fetch(&pool).await?;

// Per-branch ORDER BY / LIMIT stay INSIDE the branch's parens:
let mixed = qs_a
    .union(qs_b.order_by(&[("id", true)]).limit(5))   // branch picks its top 5
    .fetch(&pool).await?;
Tri-dialecte : PostgreSQL + SQLite prennent en charge les quatre opérateurs sur toutes les versions que Rustango supporte. MySQL 8.0+ prend en charge UNION/UNION ALL ; INTERSECT/EXCEPT sont arrivés dans MySQL 8.0.31. Les versions plus anciennes de MySQL font remonter l'erreur de syntaxe du pilote au moment du fetch — il n'y a pas de garde côté client.
Chemin d'erreur sur le builder typé : .union(other_qs) (ainsi que .intersection() / .difference()) compile la branche de manière anticipée et panique si la branche échoue à la compilation (colonne mal orthographiée, etc.). Pour une composition faillible où l'appelant veut un Result, compilez d'abord la branche et passez-la via .with_compound(SetOp::Union, branch) — un seul point d'entrée générique couvre tous les opérateurs. La panique est délibérée : une mauvaise branche est une erreur du programmeur, pas une condition de données à l'exécution.
Traitement en flux de grands ensembles de résultats
Traite une table volumineuse sans la charger entièrement en mémoire. Appelez .iterator(chunk_size) ; cela récupère chunk_size lignes à la fois (via LIMIT N OFFSET M) et ne met jamais en tampon l'ensemble complet des résultats. À utiliser pour les exports d'un million de lignes, les pipelines ETL et les traitements par lots.
// 1. Whole-chunk loop — process N rows at a time.
let mut iter = Post::objects()
    .where_(Post::published.eq(true))
    .order_by(&[("id", false)])
    .iterator(2_000)?;
while let Some(chunk) = iter.next_chunk(&pool).await? {
    for post in chunk { /* … */ }
}

// 2. Row-by-row loop — buffer one chunk internally, yield one row.
let mut iter = Post::objects().order_by(&[("id", false)]).iterator(2_000)?;
while let Some(post) = iter.next_row(&pool).await? {
    /* … */
}
Définissez un order_by. Un OFFSET sur une requête sans tri stable renvoie des lignes imprévisibles d'un chunk à l'autre — typiquement .order_by(&[("pk", false)]) afin que chaque chunk s'enchaîne proprement. La méthode n'impose pas de tri (certaines requêtes veulent légitimement ne pas trier, p. ex. une vidange en une seule passe), mais une itération non triée est un piège.
Compromis face aux curseurs côté serveur. Il s'agit d'un simple découpage LIMIT/OFFSET. Sur une colonne de tri indexée par btree, PostgreSQL balaie les N premières lignes avant de renvoyer la (N+1)ᵉ — donc la pagination profonde représente un travail total en O(n²). Pour une vidange de 10 M de lignes, cela compte ; pour 100 k lignes, généralement non. Le découpeur l'emporte sur la portabilité (fonctionne sur tous les backends sans surcoût de transaction) et la simplicité (aucune gestion du cycle de vie d'un curseur). Pour des lectures véritablement en flux sur PG, passez à sqlx brut sur une connexion tenue (pool.acquire(), puis sqlx::query(...).fetch(...) sur la branche Postgres de conn.conn()) — le protocole étendu diffuse depuis le serveur sans re-recherche par offset.
Mélanger next_chunk et next_row sur le même itérateur est sûr. Le tampon interne VecDeque se vide dans l'ordre des lignes avant toute nouvelle récupération en base, donc un next_chunk après une vidange partielle par next_row renvoie d'abord les lignes restantes en tampon, puis continue avec de nouveaux chunks.
.rows_seen() (compteur cumulé) et .is_exhausted() (indicateur post-vidange) sont tous deux disponibles pour le suivi de progression et les vérifications de terminaison.
Risque d'écriture concurrente. Chaque chunk est une requête distincte, donc les lignes insérées/supprimées entre les chunks peuvent être omises ou dupliquées (le problème classique de « fenêtrage » de la pagination par OFFSET). Pour les tables en lecture seule / en ajout uniquement — le cas d'usage typique d'export — ce n'est pas un souci. Pour les tables écrites en concurrence, exécutez la boucle dans un bloc atomic sur le même pool : chaque chunk s'exécute alors sur la transaction du bloc et pagine par clé primaire (voir plus bas). Avec un handle transaction_pool, que ChunkedIter ne prend pas, écrivez plutôt le SELECT découpé à la main contre la transaction :
let mut tx = rustango::sql::transaction_pool(&pool).await?;
rustango::sql::raw_execute_tx(&mut tx, "SET TRANSACTION ISOLATION LEVEL REPEATABLE READ", vec![])
    .await?;

// Hand-loop LIMIT/OFFSET chunks against the tx with `.fetch_on(&mut tx)`,
// so every chunk reads from the same snapshot.
let chunk_size = 2_000_i64;
let mut offset = 0_i64;
loop {
    let rows: Vec<Post> = Post::objects()
        .order_by(&[("id", false)])
        .limit(chunk_size)
        .offset(offset)
        .fetch_on(&mut tx)
        .await?;
    if rows.is_empty() { break; }
    for post in &rows { /* … */ }
    if (rows.len() as i64) < chunk_size { break; }
    offset += rows.len() as i64;
}
tx.commit().await?;
Dans un bloc atomic. Avec le pool du bloc, chaque chunk s'exécute sur la transaction du bloc : il voit les écritures du bloc, garde les verrous de ligne de .select_for_update() jusqu'au commit, et pagine par clé primaire (WHERE pk > last) au lieu d'OFFSET, si bien que les lignes que la boucle fait sortir du filtre ne sont pas sautées. Le queryset doit être trié par la clé primaire (dans un sens ou l'autre) ou pas du tout, sélectionner la clé primaire, et ne pas être une opération ensembliste ; sinon next_chunk renvoie ExecError::InAtomic. Voir Transactions.
Hors d'un bloc, select_for_update() ne se propage pas d'un chunk à l'autre. Les verrous de ligne sont libérés à la fin de la transaction implicite de chaque chunk. Pour une vidange verrouillée sur un handle transaction_pool, vous avez deux chemins, chacun avec un compromis :
.fetch_on(&mut tx)sur tout le résultat — un seul aller-retour, unVec<T>complet en mémoire. Convient quand le résultat tient.- LIMIT/OFFSET écrit à la main à l'intérieur de la transaction — même forme que l'extrait d'isolation par instantané ci-dessus ; les chunks restent en flux mais vous sortez de l'API
ChunkedIter.
chunk_size doit être > 0. Les valeurs nulles ou négatives paniquent. Choisissez une valeur adaptée à votre budget de taille de ligne (2000 est un bon point de départ pour des lignes étroites, à baisser pour des colonnes TEXT/JSONB larges).
Sélection de colonnes spécifiques
Récupère seulement quelques colonnes au lieu de structs Post complètes, via .values(...) et .values_list(...). À utiliser lorsque vous n'avez besoin que de quelques colonnes d'une table large, ou lorsque le résultat alimente du code dynamique (templates, export CSV, JSON). Vous récupérez des maps, des tuples ou une liste plate typée au lieu d'instances de modèle.
use rustango::core::SqlValue;
use std::collections::HashMap;

// 1. Column-keyed map per row.
let rows: Vec<HashMap<String, SqlValue>> = Post::objects()
    .where_(Post::published.eq(true))
    .order_by(&[("id", false)])
    .values_dict(&["id", "title"])
    .fetch(&pool).await?;

// 2. Ordered tuple per row.
//    Cell ordering matches the column-list argument.
let rows: Vec<Vec<SqlValue>> = Post::objects()
    .values_list(&["title", "id"])  // title first, id second
    .fetch(&pool).await?;

// 3. Single-column typed scalar.
//    Returns Vec<U> directly via sqlx's typed scalar path.
let ids: Vec<i64> = Post::objects()
    .where_(Post::published.eq(true))
    .values_list_flat("id")
    .fetch::<i64>(&pool).await?;
Trois builders, une seule IR. Les trois définissent SelectQuery::projection sur la liste de colonnes validée — le SQL est identique pour les trois formes terminales ; seul le décodage des lignes diffère :
| Builder | Forme SQL | Renvoie |
|---|---|---|
.values_dict(&[cols]) | SELECT col1, col2 FROM … | Vec<HashMap<String, SqlValue>> |
.values_list(&[cols]) | SELECT col1, col2 FROM … | Vec<Vec<SqlValue>> (ordonné par cols) |
.values_list_flat(col) | SELECT col FROM … | Vec<U> (typé, via fetch::<U>(...)) |
Fonctionne avec le reste de la chaîne de requête. .where_(), .filter(), .order_by(), .limit(), .offset(), et les opérateurs d'ensemble (.union() / .intersection() / .difference()) — toute méthode appelée AVANT .values_* est propagée. Les builders de valeurs sont terminaux (rien ne se chaîne après eux), donc définissez d'abord la forme de la requête, puis fetchez. Une opération d'ensemble triée par une colonne hors de la projection compare aussi cette colonne, puis la retire des lignes.
Validation au moment de .compile() / .fetch() :
- Liste de colonnes vide (
.values_dict(&[])) → [QueryError::EmptyValuesProjection]. - Nom de colonne mal orthographié (
.values_dict(&["nope"])) → [QueryError::UnknownField].
Tri-dialecte : émission de projection identique sur PG / MySQL / SQLite (seul le guillemetage des identifiants diffère). Pour .values_list_flat::<U>(...), U doit implémenter Decode + Type de sqlx sur chaque backend ciblé par le binaire — les choix courants (i64, i32, String, bool, f64) fonctionnent universellement.
Pourquoi ne pas modifier le .values() existant pour faire une projection pure ? QuerySet::values(cols) promeut déjà vers [AggregateBuilder] pour le chemin d'inférence automatique du GROUP BY. Le renommer casserait environ 20 sites d'appel existants. Les nouvelles méthodes de chaîne .values_dict() / .values_list() / .values_list_flat() coexistent, laissant le chemin d'agrégation intact. L'erreur préexistante QueryError::ValuesRequiresAggregate se déclenche toujours pour .values(cols).compile() sans .annotate(...) ultérieur — son message oriente désormais les appelants vers les nouvelles méthodes de projection pure.
Inclusion ou exclusion de colonnes
Même idée que la section précédente, mais sous forme d'une paire inclusion/exclusion : .only("id", "name") conserve uniquement les colonnes nommées, .defer("big_field") conserve tout sauf elles. À utiliser sur les tables larges où de grandes colonnes TEXT / BLOB / JSONB rendent les vues en liste coûteuses à lire :
// .only(...) — fetch only the named columns.
let rows: Vec<HashMap<String, SqlValue>> = Post::objects()
    .where_(Post::published.eq(true))
    .only(&["id", "title"])
    .fetch(&pool).await?;

// .defer(...) — fetch everything except the named columns.
// Useful for "list view: skip body / metadata / large JSON".
let rows: Vec<HashMap<String, SqlValue>> = Post::objects()
    .defer(&["body", "raw_html"])
    .fetch(&pool).await?;
Sémantique : .only(&[cols]) est un synonyme de .values_dict(cols) — même IR, même forme de retour, point d'entrée distinct par souci de lisibilité. .defer(&[cols]) calcule le complément par rapport au schéma du modèle (toutes les colonnes scalaires du modèle SAUF celles listées) et emprunte le même chemin.
Mise en garde — le retour n'est pas un Model. Il n'existe pas d'instances de modèle partiellement hydratées qui chargeraient les champs manquants à l'accès à l'attribut ; la forme de retour est Vec<HashMap<String, SqlValue>> (ou Vec<Vec<SqlValue>> si vous remplacez par .values_list(...)). Le décodage typé de ligne partielle est en file d'attente pour un futur incrément.
Sécurité face aux fautes de frappe : .defer(&["nope_col"]) fait remonter QueryError::UnknownField au moment de .compile() — la faute ne se transforme pas silencieusement en « projeter toutes les colonnes ». .only(&[]) fait remonter QueryError::EmptyValuesProjection ; .defer(&[]) est une opération sans effet sémantique (projette chaque colonne).
Correspondance avec des expressions régulières
Fait correspondre une colonne à un motif regex, via les lookups __regex / __iregex. .regex() est sensible à la casse, .iregex() insensible à la casse, et .not_regex() / .not_iregex() sont les formes négatives.
use rustango::core::Column as _;

// Names starting with "al" (case-sensitive).
User::objects()
    .where_(User::name.regex("^al.*"))
    .fetch(&pool).await?;

// Names starting with "al" — case-insensitive.
User::objects()
    .where_(User::name.iregex("^al.*"))
    .fetch(&pool).await?;

// Negated: exclude names starting with "admin" (case-sensitive).
User::objects()
    .where_(User::name.not_regex("^admin"))
    .fetch(&pool).await?;

// Lookup-suffix string form.
User::objects()
    .filter("name__iregex", "^bob")
    .fetch(&pool).await?;
Émission tri-dialecte :
| Dialecte | Sensible à la casse | Insensible à la casse | Notes |
|---|---|---|---|
| PostgreSQL | <col> ~ ? / <col> !~ ? | <col> ~* ? / <col> !~* ? | Opérateurs POSIX natifs |
| MySQL | `col` REGEXP CONCAT('(?-i)', ?) / NOT REGEXP | `col` REGEXP CONCAT('(?i)', ?) / NOT REGEXP | Drapeau inline (ICU/PCRE), quelle que soit la collation |
| SQLite | "col" REGEXP ? / "col" NOT REGEXP ? | "col" REGEXP ('(?i)' || ?) / NOT REGEXP | Nécessite le chargement de la fonction utilisateur regexp sur la connexion |
SQLite requiert une fonction utilisateur regexp enregistrée — elle n'est pas intégrée. sqlx-sqlite 0.8 n'en enregistre pas par défaut. Deux façons de l'activer :
- Facile — activez la fonctionnalité cargo
regexpde sqlx-sqlite, puis activez-la sur la connexion :use sqlx::sqlite::SqliteConnectOptions; let opts = SqliteConnectOptions::new() .filename("app.db") .with_regexp(); // gated on sqlx-sqlite/regexp - Manuel — enregistrez une closure Rust via
SqliteConnection::lock_handle()+ FFI brute (sqlite3_create_function_v2).
Sans elle, la requête émet un SQL REGEXP valide que SQLite rejette à l'exécution avec no such function: regexp (l'analyse est propre — tests/regex_sqlite_live.rs verrouille ce comportement).
Le dialecte des motifs diffère selon les backends. PostgreSQL utilise la regex étendue POSIX ; MySQL utilise une regex basée sur ICU avec sa propre saveur ; SQLite délègue à ce que la fonction utilisateur implémente (généralement la crate regex de Rust). Les motifs qui s'appuient sur une syntaxe spécifique au dialecte (p. ex. les frontières de mot \m / \M de PG) ne sont pas portables — tenez-vous-en au sous-ensemble portable (^, $, ., *, +, ?, [...], (), |) si le même modèle est interrogé depuis plusieurs backends.
Les valeurs non-chaîne sont rejetées à .compile() — passer SqlValue::I64(42) à __regex fait remonter QueryError::InvalidLookupValue { suffix: "regex", expected: "SqlValue::String(<regex pattern>)", … } plutôt qu'un cast silencieux.
Valeurs calculées et fonctions de base de données
Laissez la base de données calculer des choses au lieu de charger les lignes dans l'application, les modifier, puis les réécrire. F("col") désigne une colonne par son nom, et les builders funcs::* encapsulent des fonctions SQL scalaires comme LOWER ou COALESCE. Ensemble, ils débloquent trois modèles que les .set() / .where_() basés sur des valeurs ne peuvent pas exprimer :
Incréments atomiques (sans course lecture-modification-écriture)
Le bug classique du compteur — récupérer une ligne, incrémenter un champ, sauvegarder — perd des mises à jour quand deux requêtes s'exécutent en même temps. F("col") + 1 réduit l'aller-retour en un seul UPDATE, de sorte que la base de données tient le verrou de ligne pour vous :
use rustango::core::F;
use rustango::sql::UpdaterPool as _;

Post::objects()
    .eq("id", post_id)
    .update()
    .set_expr("view_count", F("view_count") + 1_i64)
    .execute_pool(&pool).await?;
Tri-dialecte : émet views = ("views" + $1) sur PG, views = (`views` + ?) sur MySQL, identique sur SQLite. L'arithmétique est parenthésée afin que les opérations imbriquées restent non ambiguës : F("a") + F("b") * 2.
Opérateurs pris en charge : + - * / % plus & | ^ << >> (au niveau bit ; le XOR sur SQLite émet un OpNotSupportedInDialect clair puisque SQLite n'a pas de symbole XOR).
Comparaison de deux colonnes dans un filtre
Filtre une colonne par rapport à une autre, et non par rapport à une valeur littérale — p. ex. Reservation start_date < end_date pour valider une ligne, ou Inventory available > reserved pour trouver les lignes ayant de la capacité :
use rustango::core::Column as _;

// `start_date < end_date` for every selected row.
let valid = Reservation::objects()
    .where_(Reservation::start_date.lt_expr(F("end_date")))
    .fetch(&pool).await?;

// Combine with literal predicates.
let oversold = Inventory::objects()
    .where_(Inventory::available.lt_expr(F("reserved")))
    .where_(Inventory::active.eq(true))
    .fetch(&pool).await?;
La famille *_expr — eq_expr, ne_expr, lt_expr, lte_expr, gt_expr, gte_expr — reflète les méthodes littérales eq, ne, … mais accepte tout impl Into<Expr> du côté droit : références de colonne nues (F("col")), arithmétique (F("price") * 2) ou résultats de fonction (section suivante).
Fonctions scalaires — texte, maths, gestion des NULL
rustango::core::funcs fournit des builders pour les fonctions SQL les plus utilisées. 72 builders scalaires. Les plus utilisés, par groupe :
| Groupe | Builders |
|---|---|
| Texte | lower, upper, length, trim, ltrim, rtrim, concat, substr, replace |
| Maths | abs, ceil, floor, round (1 arg) / round_to (précision à 2 args) |
| NULL | coalesce, greatest, least, nullif |
use rustango::core::funcs::{lower, upper, concat, coalesce, trim, abs, round};
use rustango::core::F;
use rustango::sql::UpdaterPool as _;

// Normalize on write.
User::objects()
    .eq("id", id)
    .update()
    .set_expr("email", lower(trim(F("email"))))
    .execute_pool(&pool).await?;

// Build a derived column from two FKs + a literal.
User::objects()
    .update()
    .set_expr(
        "display_name",
        concat([F("first").into(), " ".into(), F("last").into()]),
    )
    .execute_pool(&pool).await?;

// First non-NULL fallback.
User::objects()
    .update()
    .set_expr(
        "label",
        coalesce([F("nickname").into(), F("username").into(), "anonymous".into()]),
    )
    .execute_pool(&pool).await?;

// Function on the WHERE rhs.
User::objects()
    .where_(User::email_norm.eq_expr(lower(F("email_norm"))))
    .fetch(&pool).await?;

// Functions compose freely — `abs(round(F("score") * 100))` is one Expr.
Player::objects()
    .update()
    .set_expr("score_int", abs(round(F("score") * 100_f64)))
    .execute_pool(&pool).await?;
Comportement tri-dialecte
La plupart des fonctions émettent un SQL identique sur PG / MySQL / SQLite. Les formes divergentes sont gérées par dialecte de manière transparente :
| Builder | PG | MySQL | SQLite |
|---|---|---|---|
concat([a, b]) | CONCAT(a, b) | CONCAT(a, b) | (a || b) |
substr(s, 1, 3) | SUBSTRING(s FROM 1 FOR 3) | SUBSTRING(s, 1, 3) | SUBSTR(s, 1, 3) |
greatest([a, b]) | GREATEST(a, b) | GREATEST(a, b) | MAX(a, b) scalaire |
least([a, b]) | LEAST(a, b) | LEAST(a, b) | MIN(a, b) scalaire |
Passage d'arguments mixtes à une fonction
Les fonctions qui prennent une liste d'arguments (comme concat) acceptent n'importe quel itérable d'Expr. Les tableaux Rust doivent contenir un seul type, donc un mélange de F (colonne) et de &str (littéral) ne passe pas la vérification de type tel quel — appelez .into() une fois par élément pour élever chacun en Expr :
concat([F("first").into(), " ".into(), F("last").into()])
//          ^^^^^^ each element lifted to Expr
Ou construisez un Vec<Expr> et passez-le directement — même forme, même résultat.
Mises en garde
lengthoctets contre caractères : PG renvoie des caractères surTEXT/VARCHAR, MySQL renvoie des octets (utilisez le futur builderCharLengthdu framework ou encapsulez manuellement dansCHAR_LENGTHsi vous avez besoin d'un comptage de caractères multi-dialecte).round(x, n)sur PG : la forme à 2 arguments de PG requiert unnumeric, pas undouble. Passez soit une colonne entière, soit castez d'abord le flottant ; MySQL et SQLite acceptent l'un ou l'autre type.greatest([single_arg])/least([single_arg])sur SQLite : non pris en charge — leMAX(x)de SQLite avec un seul argument est la forme agrégat, pas la forme scalaire. Le writer renvoieOpNotSupportedInDialect. PG et MySQL acceptent la forme à argument unique comme une opération sans effet renvoyantx. Encapsulez avec au moins un littéral pour rester portable.substravec un début négatif : PG traite le négatif comme « commencer à la position N » (le ramène en pratique à 0) ; MySQL et SQLite traitent le négatif comme « compter depuis la fin ». Évitez les débuts négatifs dans du code portable.
Fonctions de date et d'heure
Les builders now(), extract_* et trunc_* travaillent sur des dates et des horodatages. Utilisez-les pour les requêtes de cohorte, les agrégats par intervalle de temps et l'estampillage de l'heure courante à l'écriture — le tout dans la base de données, sans faire transiter les lignes par l'application.
use rustango::core::funcs::{
    now, trunc_date, trunc_month,
    extract_year, extract_month, extract_weekday,
};
use rustango::core::F;

// 1. Stamp server-side current time on write.
Post::objects()
    .eq("id", id)
    .update()
    .set_expr("published_at", now())
    .execute_pool(&pool).await?;

// 2. Extract year / month / weekday into denormalized indexable
// columns so cohort + day-of-week queries are cheap.
Signup::objects()
    .update()
    .set_expr("bucket_year", extract_year(F("created_at")))
    .set_expr("bucket_month", extract_month(F("created_at")))
    .set_expr("weekday", extract_weekday(F("created_at")))
    .execute_pool(&pool).await?;

// 3. Filter on the stored bucket — typed integer comparison, uses
// the index, portable across all three dialects.
let friday_signups = Signup::objects()
    .where_(Signup::weekday.eq(5_i64))            // 5 = Friday (0=Sun)
    .fetch(&pool).await?;

// 4. For range filters where you'd be tempted to write
// `created_at >= trunc_year(now())` directly: don't. The function
// builders for `Trunc*` return text on MySQL/SQLite (see caveats
// below), so a column-vs-trunc comparison in WHERE only behaves
// well on PG. Compute the boundary in Rust instead and pass it as a
// typed literal — works the same on every backend and uses the
// index on `created_at`:
use chrono::{Datelike, TimeZone};
use rustango::sql::UpdaterPool as _;
let this_year = chrono::Utc::now().year();
let year_start = chrono::Utc.with_ymd_and_hms(this_year, 1, 1, 0, 0, 0).unwrap();

let recent = Order::objects()
    .where_(Order::created_at.gte(year_start))
    .fetch(&pool).await?;

// 5. `Trunc*` shines on the *write* side. `trunc_date` is the
// one trunc-family builder with identical SQL on every dialect
// (`DATE(x)`) — handy for grouping by day without the type-divergence
// caveat the year/month variants carry.
Order::objects()
    .update()
    .set_expr("day_bucket", trunc_date(F("created_at")))     // DATE column on every backend
    .set_expr("month_bucket", trunc_month(F("created_at")))  // see caveat
    .execute_pool(&pool).await?;
// `month_bucket` should be `TIMESTAMPTZ` on PG and `VARCHAR(10)` /
// `TEXT` on MySQL/SQLite — parse client-side when reading if you
// need a typed `chrono::NaiveDate`.
Émission par dialecte :
| Builder | PG | MySQL | SQLite |
|---|---|---|---|
now() | NOW() | NOW() | CURRENT_TIMESTAMP |
extract_year(x) | CAST(EXTRACT(YEAR FROM x) AS INTEGER) | YEAR(x) | CAST(strftime('%Y', x) AS INTEGER) |
extract_week(x) | EXTRACT(WEEK FROM x) — ISO 8601, plage 1–53 | WEEK(x, 3) — ISO 8601 | ISO 8601, à partir du jeudi de la semaine |
extract_weekday(x) | CAST(EXTRACT(DOW FROM x) AS INTEGER) | (DAYOFWEEK(x) - 1) | CAST(strftime('%w', x) AS INTEGER) |
extract_quarter(x) | EXTRACT(QUARTER FROM x) | QUARTER(x) | non pris en charge — erreur |
trunc_date(x) | DATE(x) | DATE(x) | DATE(x) |
trunc_year(x) | DATE_TRUNC('year', x) → timestamp | DATE_FORMAT(x, '%Y-01-01') → chaîne | strftime('%Y-01-01', x) → chaîne |
trunc_month(x) | DATE_TRUNC('month', x) → timestamp | DATE_FORMAT(x, '%Y-%m-01') → chaîne | strftime('%Y-%m-01', x) → chaîne |
trunc_day(x) | DATE_TRUNC('day', x) → timestamp | DATE(x) → date | date(x) → text |
Mises en garde propres aux dates/heures :
- Le type de retour de
trunc_year/monthdiverge : timestamp sur PG, texte sur MySQL/SQLite. Castez côté application à la lecture si vous avez besoin d'unchrono::NaiveDatetypé — ou stockez l'intervalle sous forme d'entier simple (extract_year+extract_month) et reconstruisez-le dans le code. extract_weekdayest normalisé à 0 = dimanche sur les trois dialectes. LeDAYOFWEEK()natif de MySQL renvoie 1 = dimanche, donc le writer soustrait 1.extract_weeket__weekdonnent la semaine ISO 8601 (début lundi, 1–53) sur les trois dialectes : le 2023-01-01 est en semaine 52.extract_quartersur SQLite génère une erreur avecOpNotSupportedInDialect— SQLite n'a pas de jeton de trimestre natif. Soit vous protégez la fonctionnalité derrièrecfg(not(sqlite)), soit vous calculez via((extract_month - 1) / 3) + 1dans le code applicatif.- Gestion des fuseaux horaires : le
EXTRACTde PG opère dans le fuseau horaire de la colonne ; leYEAR()de MySQL opère dans le fuseau horaire de la session (SET time_zone = ...) ; SQLite n'a pas de vraie prise en charge des fuseaux — traitez tout comme de l'UTC. UtilisezTIMESTAMPTZsur PG,DATETIMEsur MySQL avec le fuseau de session défini, des chaînes ISO-8601 sur SQLite.
Expressions CASE WHEN
Construit un CASE WHEN … THEN … ELSE … END SQL avec les builders case() / .when() / value(). À utiliser pour les tris personnalisés, les colonnes dérivées dans annotate, les valeurs par défaut calculées dans update, et (associé à Sum) les agrégats conditionnels.
use rustango::core::case::{case, value};
use rustango::core::{Column as _, F};
use rustango::core::funcs::lower;
use rustango::sql::UpdaterPool as _;

// Custom ordering — published posts first, drafts last.
Post::objects()
    .update()
    .set_expr(
        "priority",
        case()
            .when(Post::status.eq("published"), 0_i64)
            .when(Post::status.eq("review"), 1_i64)
            .when(Post::status.eq("draft"), 2_i64)
            .default(99_i64),
    )
    .execute_pool(&pool).await?;

let ordered = Post::objects()
    .order_by(&[("priority", false), ("id", false)])
    .fetch(&pool).await?;

// Computed default on update — drafts get a lowercased title for
// the label, everything else uses the title verbatim.
Post::objects()
    .update()
    .set_expr(
        "label",
        case()
            .when(Post::status.eq("draft"), lower(F("title")))
            .default(F("title")),
    )
    .execute_pool(&pool).await?;

// AND / OR composition in the WHEN predicate.
let viral = Post::status.eq("published").and(Post::views.gt(1_000_i64));
Post::objects()
    .update()
    .set_expr(
        "label",
        case()
            .when(viral, value("viral"))
            .when(Post::status.eq("published"), value("live"))
            .default(value("pending")),
    )
    .execute_pool(&pool).await?;
Forme du builder :
case()— démarre un builder..when(condition, then)— ajoute une branche.conditionest tout ce qui implémenteInto<WhereExpr>(typiquementColumn::eq(),.and(),.or()) ;thenest tout ce qui implémenteInto<Expr>(littéral,F(), appel de fonction,case()imbriqué)..default(expr)— définit la brancheELSEoptionnelle. L'omettre produit unCASEqui renvoieNULLpour les lignes non correspondantes (standard SQL)..build()ou.into()— finalise en unExprpourset_expr/eq_expr/annotate.value(literal)— forme abrégée pourExpr::Literal(...). Optionnel — les littéraux nus sont convertis viaInto<Expr>, maisvalue("…")se lit explicitement comme « ceci est un littéral de chaîne, pas une référence de colonne ».
Émission tri-dialecte :
CASE WHEN … THEN … [ELSE …] END est standard SQL-92 — émis à l'identique sur PG, MySQL et SQLite. Aucune répartition par dialecte dans le writer.
Mises en garde :
- Branches vides :
case().build()sans aucun appel.when(...)est rejeté au moment de l'émission avecSqlError::EmptyCaseBranches. SQL requiert au moins une clauseWHEN. Une conditionWHENvide (p. ex.WhereExpr::And(vec![])) est rejetée avecSqlError::EmptyCaseWhenConditionpour la même raison. - Unification de type entre les branches : chaque dialecte choisit un type commun parmi les valeurs
THENetELSE. Mélanger les types (THEN 1_i64+ELSE "string") peut lever une erreur de cast à l'exécution ou convertir de manière surprenante. Tenez-vous-en à un seul type parCASE. - Performance : chaque ligne évalue les prédicats
WHENdans l'ordre jusqu'à ce qu'un corresponde (premier trouvé gagne, par ligne). Le coût croît avec le nombre de branches et le coût des prédicats. Pour de nombreux mappages chaîne-fixe, une jointure sur une petite table de correspondance peut être moins coûteuse et plus lisible.
Sous-requêtes (EXISTS, IN, scalaire)
Imbrique une requête dans une autre. Ces builders couvrent la plupart des modèles « une ligne liée existe-t-elle ? » et « cette valeur est-elle dans cet ensemble ? » :
| Builder | Forme | À utiliser pour |
|---|---|---|
exists(qs) | EXISTS (SELECT … FROM …) | « Auteurs ayant au moins un livre » |
not_exists(qs) | NOT EXISTS (SELECT …) | « Auteurs sans livre » (anti-jointure) |
in_subquery(col, qs) | <col> IN (SELECT …) | « Posts dans n'importe quelle catégorie publique » |
not_in_subquery(col, qs) | <col> NOT IN (SELECT …) | Inverse du précédent |
subquery(qs) | (SELECT …) en tant que scalaire | Valeur par défaut calculée dans set_expr |
outer_ref(col) | "<outer_table>"."<col>" | Référencer la ligne externe depuis l'intérieur de l'un des précédents |
use rustango::core::subquery::{exists, not_exists, in_subquery, outer_ref};
use rustango::core::{Column as _, WhereExpr};

// "Authors with no books" — the canonical anti-join. Build the inner
// queryset first so its compile() catches typos; embed via not_exists.
let no_books = Book::objects()
    .where_(Book::author_id.eq_expr(outer_ref("id")))
    .compile()?;
let orphans = Author::objects()
    .where_raw(not_exists(no_books))
    .fetch(&pool).await?;

// "Authors who have a published book of more than 100 pages" — the
// inner predicate combines a correlation (outer_ref) with literal
// filters in the same WHERE.
let inner = Book::objects()
    .where_(Book::author_id.eq_expr(outer_ref("id")))
    .where_(Book::status.eq("published"))
    .where_(Book::pages.gt(100_i64))
    .compile()?;
let long_writers = Author::objects()
    .where_raw(exists(inner))
    .fetch(&pool).await?;

// Compose EXISTS with an OR.
let inner = Book::objects()
    .where_(Book::author_id.eq_expr(outer_ref("id")))
    .compile()?;
let featured = Author::objects()
    .where_raw(WhereExpr::Or(vec![
        Author::name.eq("Carol").into(),
        exists(inner),
    ]))
    .fetch(&pool).await?;
La corrélation imbriquée fonctionne. Un OuterRef à l'intérieur d'une sous-requête doublement imbriquée se résout vers la portée englobante immédiate — le writer maintient une pile de portées à mesure qu'il descend, de sorte que EXISTS (Book WHERE id = outer.id AND EXISTS (Comment WHERE book_id = outer.id)) résout le outer.id interne vers Book.id, pas vers le Author.id le plus externe. Utilisez outer_ref(...) deux fois si vous avez réellement besoin d'atteindre deux portées plus haut.
Erreurs :
OuterRefOutsideSubquery— émettreouter_ref("col")au niveau supérieur (pas à l'intérieur d'une enveloppe de sous-requête) est une erreur de programmation. Le writer la lève bruyamment avec le nom de la colonne afin que le site d'appel soit facile à trouver.
Mises en garde :
- Rétrécissement de projection de
IN (SELECT …): PG requiert strictement que le SELECT interne ne projette qu'une seule colonne pour la forme<col> IN (…). Rétrécissez le queryset interne avecvalues_list_flat:in_subquery("id", Book::objects().values_list_flat("author_id").compile()?)ne projette queauthor_idsur chaque backend. UnQuerySet::compile()simple projette chaque colonne du modèle, ne le passez donc que pour un modèle à une seule colonne. - Le
subquery(...)scalaire requiert un interne une-colonne-une-ligne : le SQL émis estSET col = (SELECT …)— si l'interne produit plus d'une ligne, la base de données génère une erreur à l'exécution. Contraignez via.limit(1)et soit rétrécissez la projection avecvalues_list_flat, soit concevez l'interne autour d'un invariant d'unicité. - La validation à la compilation des sous-requêtes réside sur le queryset interne : les fautes de frappe de colonne remontent à l'appel
queryset.compile()?interne, pas aucompile()de la requête externe. Construisez l'interne en premier et propagez?.
Quand passer plutôt au SQL brut
Le tableau ci-dessus est une sélection, pas l'ensemble complet. funcs propose aussi cast, la famille plein texte (to_tsvector, plainto_tsquery, websearch_to_tsquery, ts_rank, ts_headline), les chemins JSON (json_path, json_path_indexed, json_array_length) et les hachages (md5, sha1, sha256). Les fonctions de fenêtrage forment un module distinct, rustango::core::window, documenté plus bas. Les fonctions trigonométriques sont le manque notable — pour celles-ci, et pour tout ce que l'arbre d'expressions n'atteint pas, voyez la section trappe de secours SQL brut plus bas.
Agrégations
Compte, somme, moyenne et regroupe des lignes. .count(), .sum(), .avg(), .min() et .max() renvoient un seul nombre ; .annotate(...) plus .values(...) construit des requêtes GROUP BY. Les résultats d'agrégation reviennent sous forme de Vec<HashMap<String, SqlValue>> plutôt que de structs typées, car la forme est dynamique.
use rustango::sql::CounterPool as _;

// COUNT
let n = Post::objects()
    .where_(Post::status.eq("published"))
    .count(&pool).await?;

// SUM / AVG / MIN / MAX — string column name; each returns Option<U>
// (None when the filtered result set is empty).
let total_views = Post::objects().sum::<i64>("view_count", &pool).await?;
let avg_views = Post::objects().avg::<f64>("view_count", &pool).await?;
let max_views = Post::objects().max::<i64>("view_count", &pool).await?;

// Annotate + GROUP BY (auto-inferred grouping)
use rustango::core::aggregates::{count_all, sum};

// "Posts per author" — `.values()` lists the GROUP BY columns.
let by_author = Sale::objects()
    .values(&["author_id"])
    .annotate("n", count_all().into())
    .compile()?;
let rows = rustango::sql::fetch_aggregate_dict(&pool, &by_author).await?;
// rows: Vec<HashMap<String, SqlValue>> — { author_id: 1, n: 3 }, …
Comment le GROUP BY est inféré
Vous écrivez rarement GROUP BY vous-même — Rustango l'infère à partir de la forme de la requête. Vous n'appelez .group_by(...) que pour surcharger cette inférence. Le tableau montre ce que produit chaque forme :
| Forme | Builder | GROUP BY résultant |
|---|---|---|
| 2 — values + agrégat | .values(&["author_id"]).annotate("n", count_all().into()) | GROUP BY "author_id" |
| 3 — agrégat nu | .annotate("n", count_all().into()) | GROUP BY sur chaque colonne scalaire non agrégée du modèle |
| Fenêtrage seul | .aggregate().annotate("rn", row_number()…) | (aucun GROUP BY — les fonctions de fenêtrage sont par ligne) |
| Surcharge explicite | .aggregate().group_by("month").annotate(...) | GROUP BY "month" — l'explicite gagne |
Le classificateur AggregateExpr::is_aggregating() distingue les variantes qui réduisent les lignes (Count / Sum / Avg / Max / Min / CountDistinct / StdDev* / Variance* / AnyValue / ArrayAgg / StringAgg / JsonbAgg / RelatedAggregate — plus les enveloppes récursives Filtered / Coalesced) de Window, qui est par ligne. Seules les variantes agrégeantes déclenchent l'inférence de la Forme 3.
use rustango::core::aggregates::{count_all, sum};

// Shape 2 — "monthly revenue per author".
Sale::objects()
    .where_(Sale::status.eq("paid"))
    .values(&["author_id", "month"])
    .annotate("total", sum("amount").into())
    .compile()?;
// → SELECT "author_id", "month", SUM("amount")::bigint AS "total"
//   FROM "sale" WHERE "status" = $1
//   GROUP BY "author_id", "month"

// Shape 3 — a bare .annotate() with no .values(): rustango adds every
// non-aggregate scalar column of the model to the GROUP BY.
Post::objects()
    .annotate("n", count_all().into())
    .compile()?;
// → SELECT <every Post column>, COUNT(*) AS "n"
//   FROM "post" GROUP BY <every Post column>
Projection pure. .values(cols) seul (sans annotation d'agrégat) renvoie QueryError::ValuesRequiresAggregate — ce chemin est réservé au GROUP BY, et une annotation de fenêtre ne le satisfait pas davantage, puisqu'une fenêtre n'agrège pas. La projection pure en dictionnaires est livrée : utilisez .values_dict(...), .values_list(...) ou .values_list_flat(...), décrits plus haut sous Sélectionner des colonnes précises. Le message d'erreur les nomme lui-même.
Agrégats conditionnels et statistiques
Compte ou somme uniquement les lignes qui satisfont une condition, fournit une valeur de repli pour les résultats vides, et calcule l'écart-type / la variance. Chaînez .filter(...) et .default(...) sur n'importe quel builder d'agrégat.
use rustango::core::aggregates::{avg, count, count_all, stddev, sum};
use rustango::core::Column as _;

let rows = Post::objects()
    .aggregate()
    // COUNT(*) FILTER (WHERE is_active AND status = 'published')
    .annotate(
        "active_published",
        count_all()
            .filter(Post::is_active.eq(true).and(Post::status.eq("published")))
            .into(),
    )
    // COALESCE(SUM(price) FILTER (WHERE status = 'published'), 0)
    //   — returns 0 instead of NULL when the queryset is empty.
    .annotate(
        "revenue_or_zero",
        sum("price")
            .filter(Post::status.eq("published"))
            .default(0_i64)
            .into(),
    )
    .annotate("avg_pages", avg("pages").into())
    .annotate("page_stddev", stddev("pages").into())
    .compile()?;
let result = rustango::sql::fetch_aggregate_dict(&pool, &rows).await?;
Builders dans rustango::core::aggregates :
| Builder | SQL |
|---|---|
count(col) | COUNT(col) |
count_all() | COUNT(*) |
count_distinct(col) | COUNT(DISTINCT col) |
sum(col) / avg(col) / max(col) / min(col) | l'habituel |
stddev(col) / stddev_pop(col) | STDDEV_SAMP / STDDEV_POP |
variance(col) / variance_pop(col) | VAR_SAMP / VAR_POP |
Chacun renvoie un AggregateBuilder avec deux modificateurs chaînables :
.filter(predicate)— encapsule dansFILTER (WHERE predicate). Le prédicat est n'importe quelWhereExpr(.eq()/.and()typé /WhereExpr::Or(...)brut), il se compose donc de la même manière qu'un WHERE normal..default(value)— encapsule dansCOALESCE(..., value)afin qu'un queryset vide renvoie la valeur par défaut au lieu deNULL.
Appeler les deux chaînes comme Coalesced à l'extérieur de Filtered : COALESCE(SUM(col) FILTER (WHERE p), 0). L'ordre de la chaîne n'a pas d'importance — .filter(p).default(0) et .default(0).filter(p) produisent la même IR.
Émission tri-dialecte :
| Fonctionnalité | PG | MySQL | SQLite |
|---|---|---|---|
Count / Sum / Avg / Max / Min / CountDistinct | ✓ | ✓ | ✓ |
StdDev / StdDevPop / Variance / VariancePop | ✓ | ✓ (8.0+) | ✗ SqlError::AggregateNotSupported |
.filter(...) — FILTER (WHERE …) natif | ✓ | ✗ réécrit | ✓ (3.30+) |
.filter(...) — repli CASE WHEN | — | ✓ <agg>(CASE WHEN … THEN <arg> END) | — |
.default(...) — COALESCE | ✓ | ✓ | ✓ |
Le writer applique le cast entier/flottant du dialecte (::bigint, CAST(... AS SIGNED), etc.) autour de toute l'expression FILTER — SUM(col)::bigint FILTER (...) est une erreur d'analyse sur PG, donc la forme émise est (SUM(col) FILTER (...))::bigint. Même forme pour STDDEV_SAMP / VAR_SAMP (ils renvoient un NUMERIC sur PG pour une entrée bigint).
SQLite + StdDev/Variance : SQLite n'a pas d'agrégats statistiques intégrés, donc le writer rejette avec SqlError::AggregateNotSupported { aggregate, dialect: "sqlite" }. Calculez la formule de variance dans le code applicatif si vous avez besoin de statistiques portables.
Fonctions de fenêtrage
Calcule des totaux cumulés, des classements et des différences d'une ligne à l'autre sans réduire les lignes. Quatorze fonctions (row_number, rank, dense_rank, lag, lead, first_value, last_value, ntile, sum_over, avg_over, min_over, max_over, count_over, count_column_over) plus les frames ROWS/RANGE. Chaque backend que Rustango prend en charge (PG ≥ 9.0, MySQL ≥ 8.0, SQLite ≥ 3.25) livre la syntaxe native OVER (…), donc l'émission est uniforme.
use rustango::core::aggregates::max;
use rustango::core::window::{lag, rank, row_number};

// "Rank users by score within each tenant" — the canonical
// integration target.
let q = User::objects()
    .aggregate()
    .group_by("id")
    .group_by("tenant_id")
    .group_by("name")
    .group_by("score")
    .annotate("_a", max("id").into())  // satisfies GROUP BY on the projection
    .annotate(
        "tenant_rank",
        rank().partition_by("tenant_id").order_by(&[("score", true)]).into(),
    )
    .order_by(&[("tenant_id", false), ("score", true)])
    .compile()?;
let rows = rustango::sql::fetch_aggregate_dict(&pool, &q).await?;

// Day-over-day delta via LAG with a default for the first row.
let q = Event::objects()
    .aggregate()
    .group_by("id")
    .group_by("day")
    .group_by("count")
    .annotate("_a", max("id").into())
    .annotate(
        "prev_count",
        lag("count", 1, Some(SqlValue::I64(0)))
            .partition_by("user_id")
            .order_by(&[("day", false)])
            .into(),
    )
    .compile()?;

// Stable row index per group for "show me row N" pagination.
let q = Post::objects()
    .aggregate()
    .group_by("id")
    .group_by("status")
    .group_by("created_at")
    .annotate("_a", max("id").into())
    .annotate(
        "rn",
        row_number()
            .partition_by("status")
            .order_by(&[("created_at", true)])
            .into(),
    )
    .compile()?;
Builders dans rustango::core::window :
| Builder | SQL | Args |
|---|---|---|
row_number() | ROW_NUMBER() | — |
rank() | RANK() | — |
dense_rank() | DENSE_RANK() | — |
ntile(buckets) | NTILE(buckets) | nombre de compartiments |
lag(col, offset, default) | LAG(col, offset, default?) | colonne + décalage + défaut optionnel |
lead(col, offset, default) | LEAD(col, offset, default?) | colonne + décalage + défaut optionnel |
first_value(col) | FIRST_VALUE(col) | colonne |
last_value(col) | LAST_VALUE(col) | colonne |
sum_over(col) | SUM(col) | colonne |
avg_over(col) | AVG(col) | colonne |
min_over(col) | MIN(col) | colonne |
max_over(col) | MAX(col) | colonne |
count_column_over(col) | COUNT(col) | colonne |
count_over() | COUNT(*) | — |
Chacun renvoie un WindowBuilder avec trois modificateurs chaînables :
.partition_by("col")— ajoute une colonnePARTITION BY. Appelez plusieurs fois pour un partitionnement multi-colonnes..order_by(&[("col", desc)])— ajoute des colonnesORDER BY(desc = true→ DESC)..frame(WindowFrame { kind, start, end })— définit la clause de frameROWS/RANGEoptionnelle.FrameBoundary::UnboundedPreceding/Preceding(n)/CurrentRow/Following(n)/UnboundedFollowing.
Le builder s'abaisse via Into<AggregateExpr> afin que les fonctions de fenêtrage se composent avec annotate(). Into<Expr> est également implémenté (l'emplacement au niveau IR pour les expressions de fenêtrage), mais chaque backend que Rustango prend en charge restreint les fonctions de fenêtrage à la liste SELECT et à la clause ORDER BY d'une requête — elles ne peuvent pas apparaître dans WHERE / HAVING / GROUP BY / UPDATE SET / JOIN ON / RETURNING. Le writer ne conditionne pas l'émission sur ce point, donc set_expr("col", row_number()) se compile en un SQL que la base de données rejette à l'exécution. Construisez les expressions de fenêtrage via annotate() ; passez à une sous-requête si vous devez alimenter un résultat de fenêtrage dans un filtre WHERE ou un UPDATE.
Le piège de la frame par défaut de LAST_VALUE :
Un simple last_value(col).order_by(&[("x", false)]) émet LAST_VALUE("col") OVER (ORDER BY "x") et semble devoir renvoyer le dernier col de la partition. Ce n'est pas le cas — la frame de fenêtrage par défaut de SQL est RANGE BETWEEN UNBOUNDED PRECEDING AND CURRENT ROW, donc LAST_VALUE renvoie la valeur de la ligne courante, pas de la dernière ligne de la partition. Pour obtenir le comportement intuitif « dernière ligne de la partition », passez une frame illimitée explicite :
use rustango::core::{FrameBoundary, FrameKind, WindowFrame};

last_value("score")
    .partition_by("tenant_id")
    .order_by(&[("created_at", true)])
    .frame(WindowFrame {
        kind: FrameKind::Rows,
        start: FrameBoundary::UnboundedPreceding,
        end: Some(FrameBoundary::UnboundedFollowing),
    })
first_value n'a pas ce piège — le début de la frame par défaut coïncide avec le début de la partition, donc la réponse intuitive en découle.
Annotate et GROUP BY :
Un annotate() uniquement fenêtre sur .aggregate() n'émet désormais aucun GROUP BY — les fenêtres sont par ligne, il n'y a donc rien à grouper. Projeter des colonnes de ligne à côté d'une fenêtre passe toujours par le builder d'agrégat, d'où le fait que les exemples ci-dessous listent chaque colonne dans .group_by(...) et ajoutent annotate("_a", max("id").into()) comme no-op pour garder l'identité de ligne stable. Cette forme fonctionne toujours. À noter : .values(cols).annotate(window) ne fonctionne pas — une fenêtre n'agrège pas et renvoie ValuesRequiresAggregate.
Clauses de frame :
use rustango::core::{FrameBoundary, FrameKind, WindowFrame};

// Running total over the last 7 rows:
let frame = WindowFrame {
    kind: FrameKind::Rows,
    start: FrameBoundary::Preceding(6),
    end: Some(FrameBoundary::CurrentRow),
};

// Centered 11-row window:
let frame = WindowFrame {
    kind: FrameKind::Rows,
    start: FrameBoundary::Preceding(5),
    end: Some(FrameBoundary::Following(5)),
};
Émission tri-dialecte :
<fn>(args) OVER (PARTITION BY … ORDER BY … [frame]) est standard SQL — identique sur PG, MySQL 8+ et SQLite 3.25+. La seule bizarrerie : LAG / LEAD / NTILE requièrent des décalages/compartiments entiers sur PG (les lier en tant que paramètre bigint $N provoque function lag(bigint, bigint, bigint) does not exist). Le writer intègre directement les littéraux entiers dans le SQL pour ces emplacements ; les arguments de valeur par défaut sont liés normalement.
Mises en garde :
FILTER+Windowpas encore pris en charge : combiner.filter(...)avec une fonction de fenêtrage lèveSqlError::NestedAggregateWrapper { wrapper: "Filtered(Window)" }— la syntaxe sous-jacente varie selon le type de fonction (PG autoriseagg_fn() FILTER (WHERE …) OVER (…)pour les fonctions agrégat-fenêtre mais pas pour les fonctions de classement), et le writer n'a pas encore appris la répartition. Reporté à un suivi si la demande émerge.PercentRank/CumeDist/NthValuene sont pas dans la v1 — SQL définit davantage de fonctions de fenêtrage que celles couvertes ici. La v1 livre les quatorze ci-dessus ; les trois manquantes peuvent être ajoutées progressivement avec la même forme de builder.
Filtrage sur les agrégats (HAVING)
Un appel .filter(...) après .annotate(...) atterrit soit dans WHERE, soit dans HAVING, selon que le nom correspond ou non à un alias d'agrégat. Ainsi, filtrer sur une vraie colonne ajoute un WHERE, tandis que filtrer sur une annotation comme post_count ajoute un HAVING :
use rustango::core::aggregates::count_all;
use rustango::core::Op;

// "Authors with > 10 published posts" — the canonical pattern.
// status='published' is on the model       → routes to WHERE.
// post_count > 10 references the annotation → routes to HAVING.
let q = Post::objects()
    .aggregate()
    .group_by("author_id")
    .annotate("post_count", count_all().into())
    .filter("status",     Op::Eq, "published")
    .filter("post_count", Op::Gt, 10_i64)
    .compile()?;
let rows = rustango::sql::fetch_aggregate_dict(&pool, &q).await?;
Émet, sur PG :
SELECT "author_id", COUNT(*) AS "post_count"
FROM "post"
WHERE "status" = $1
GROUP BY "author_id"
HAVING COUNT(*) > $2
L'expression d'agrégat est élevée dans le HAVING, pas dans l'alias du SELECT. PG interdit strictement les alias dans le HAVING (seule l'expression se résout) ; MySQL + SQLite sont plus permissifs. Le writer émet la forme élevée uniformément sur les trois afin que la même requête fonctionne partout.
L'ordre de la chaîne compte. Appelez .annotate(alias, ...) AVANT le .filter(alias, ...) correspondant. Si l'ordre est inversé, filter() consulte un registre d'annotations vide et route vers WHERE — et le validateur resolve_pending fait remonter UnknownField à compile() car l'alias n'est pas une vraie colonne du modèle.
Lacune du validateur (conforme à la posture existante des agrégats) : les prédicats HAVING routés par alias sautent le parcours des colonnes du schéma du modèle. Les alias mal orthographiés remontent depuis la base de données, pas à compile(). Même lacune que Sum("typo_col") — préexistante et orthogonale.
Opérateurs pris en charge sur un .filter() routé par alias : l'ensemble des comparaisons binaires (Op::Eq / Ne / Lt / Lte / Gt / Gte) plus les prédicats standard SQL-92 qui se composent uniformément contre un membre gauche agrégé sur chaque backend — Op::In / NotIn, Between, IsNull, Like / NotLike, ILike / NotILike. Chacun émet la forme prévisible :
use rustango::core::{Op, SqlValue};

// HAVING COUNT(*) IN ($1, $2, $3)
Post::objects()
    .aggregate()
    .group_by("author_id")
    .annotate("post_count", count_all().into())
    .filter("post_count", Op::In, SqlValue::List(vec![5_i64.into(), 10_i64.into(), 20_i64.into()]))
    .compile()?;

// HAVING COUNT(*) BETWEEN $1 AND $2
.filter("post_count", Op::Between, SqlValue::List(vec![5_i64.into(), 10_i64.into()]))

// HAVING COUNT(*) IS NULL  /  IS NOT NULL  (bool: true = IS NULL)
.filter("post_count", Op::IsNull, SqlValue::Bool(false))

// HAVING MAX("name") LIKE $1  /  ILIKE $1 (PG) / LOWER(MAX("name")) LIKE LOWER(?) (MySQL/SQLite)
.filter("max_name", Op::ILike, "SMITH%")
Les opérateurs restants — la famille des opérateurs JSON (JsonContains / JsonContainedBy / JsonHasKey / JsonHasAnyKey / JsonHasAllKeys) et l'égalité tolérante aux NULL (IsDistinctFrom / IsNotDistinctFrom) — nécessitent encore des writers spécifiques au dialecte qui prennent un &str pour le membre gauche, ils rejettent donc à compile() avec QueryError::HavingOpNotSupported { alias, op }. Pour ceux-là, passez à la forme typée .having(<TypedExpr>) avec un prédicat préconstruit.
Gonflement du vecteur de paramètres avec des agrégats non triviaux : lorsque l'alias cible une annotation Filtered { Count, filter: pred } ou Coalesced { Sum, default: 0 }, le writer élève l'expression d'agrégat entière dans le HAVING — y compris ses prédicats internes et ses valeurs par défaut. Leurs littéraux liés obtiennent de nouveaux emplacements de paramètre dans le HAVING, distincts de l'émission de la liste SELECT. Concrètement :
SELECT … COUNT(*) FILTER (WHERE "status" = $1) AS "published_count" …
HAVING COUNT(*) FILTER (WHERE "status" = $2) > $3
              -- "published" bound twice (once at $1, once at $2)
La sémantique SQL est inchangée (les mêmes comptages de lignes reviennent), mais stmt.params.len() croît à chaque appel .filter() qui cible un alias non trivial. Pour les alias COUNT(*) (sans littéraux internes), le gonflement est nul. Documentez-le si votre suite de tests verrouille le nombre de paramètres.
Jointures et préchargement des lignes liées
Récupère la cible d'une clé étrangère en même temps que la ligne principale en une seule requête, afin de ne pas déclencher une requête supplémentaire par ligne (le problème N+1). .select_related("author") charge la relation d'avance (chargement anticipé). Un champ ForeignKey<T> arrive alors déjà rempli au lieu de nécessiter une recherche séparée.
let posts = Post::objects()
    .select_related("author")              // JOIN posts.author -> authors.id
    .fetch(&pool).await?;

for post in &posts {
    let author = post.author.value().unwrap();   // already loaded, no DB round-trip
    println!("{} by {}", post.title, author.name);
}
select_related résout les champs FK au moment de la compilation du queryset. Le champ ForeignKey<T> du parent passe de Unloaded(pk) à Loaded { pk, value }.
Pour les FK inverses (parent.children), utilisez la méthode _set générée par la macro :
let author_posts = author.post_set(&pool).await?;
Préchargement des relations many-to-many et inverses
Pour une liste de parents, fetch_with_prefetch_related charge par son nom une relation many-to-many (m2m(name = "tags", ...)) ou FK inverse (reverse_has(name = "items", ...)). Elle exécute une requête pour les parents et une pour la relation, quel que soit le nombre de parents.
rustango::sql::fetch_with_prefetch_related(Post::objects(), "tags", &pool) renvoie Vec<(Post, Vec<Tag>)>. Pour filtrer ou trier les lignes liées, passez un queryset à fetch_with_prefetch_related_filtered(Post::objects(), "tags", Tag::objects().order_by(&[("name", false)]), &pool) ; une limite sur celui-ci s'applique à tous les parents ensemble. crates/rustango/tests/prefetch_related_tri.rs exécute les deux sur PostgreSQL, MySQL et SQLite.
- Les clés des parents vont dans une seule liste
IN, découpée en lots au-delà de la limite de binds du backend (65 535 sur MySQL, 32 766 sur SQLite ; PostgreSQL lie un seul tableau). - Un many-to-many joint sa table de liaison, donc un tag partagé par de nombreux posts revient une fois sous chaque post. Les clés entières,
StringetUuidfonctionnent toutes. - Une FK inverse s'indexe sur le
self_pk_columnde la relation, donc des enfants pointant vers une colonne unique (ForeignKey<Shop, String>avecon = "code") sont groupés correctement. - Un nom inconnu donne
QueryError::UnknownField; demander le mauvais modèle enfant donneExecError::PrefetchTargetMismatch.
Pour précharger par champ FK plutôt que par nom de relation, fetch_with_prefetch_pool(Author::objects(), "author", &pool) fonctionne toujours de la même façon.
Jointures personnalisées
Lorsque la jointure n'est pas pilotée par une clé étrangère — un prédicat personnalisé, une non-équi-jointure, INNER au lieu de LEFT, une auto-jointure, ou une jointure sur une colonne non-PK — utilisez .join(Join { … }). Son champ on prend n'importe quel WhereExpr, donc and() / or() / Not / appels de fonction / colonne-contre-colonne / filtres littéraux se composent tous librement.
use rustango::core::joins::aliased;
use rustango::core::{Join, JoinKind, Op, WhereExpr};

// "Posts that have at least one APPROVED comment" — INNER JOIN with
// an extra predicate inside the ON. Posts with no approved comment
// drop out; LEFT JOIN would keep them.
Post::objects()
    .join(Join {
        target: Comment::SCHEMA,
        alias: "c",
        kind: JoinKind::Inner,
        on: WhereExpr::And(vec![
            // Column-on-column condition — both sides aliased.
            WhereExpr::ExprCompare {
                lhs: aliased("c", "post_id"),
                op: Op::Eq,
                rhs: aliased("post", "id"),
            },
            // Bare Filter — unqualified columns inside `on` resolve
            // to the joined alias ("c"), so this becomes
            // `"c"."is_approved" = $N`.
            Comment::is_approved.eq(true).into(),
        ]),
        project: vec![],
    })
    .fetch(&pool).await?;
Règles de qualification des colonnes à l'intérieur de on :
- Les colonnes
Filter/ColumnFilternues + les références de colonneF()se résolvent vers l'alias joint (le<alias>que vous avez passé). C'est la lecture naturelle car l'essentiel d'un prédicat ON concerne la table jointe. aliased(alias, col)émet explicitement"<alias>"."<col>"— à utiliser pour les références croisées vers la table externe (aliased("<outer_table>", "<col>")) ou vers un alias précédemment joint.WhereExpr::ExprCompare { lhs, op, rhs }est la bonne forme pour les comparaisons colonne-contre-colonne entre tables, puisque les deux côtés prennent n'importe quelExpr.
⚠️ MODÈLE DANGEREUX — filtres typés du modèle EXTERNE à l'intérieur de
on.Post::status.eq("draft").into()produit unWhereExpr::Predicate(Filter { column: "status", ... })et abandonne l'étiquette du modèlePostà la frontièreInto<WhereExpr>. La règle de qualification automatique ci-dessus route alors par erreur ce filtre vers l'alias joint, pas versPost. Vous obtenez"<joined_alias>"."status" = $N— mauvaise table — et le compilateur ne peut pas le détecter. Utilisezjoins::col_filterpour les prédicats contre toute colonne dont la table n'est pas l'alias par défaut de la jointure :use rustango::core::joins::{aliased, col_filter}; use rustango::core::Op; // SAFE: explicit alias on the LHS. col_filter("post", "status", Op::Eq, "draft")Réservez les filtres typés nus (
Comment::is_approved.eq(true).into()) uniquement aux colonnes du modèle JOINT — jamais pour les colonnes du modèle externe.
Prise en charge tri-dialecte de JoinKind :
| Type | PG | MySQL | SQLite |
|---|---|---|---|
Inner | ✓ | ✓ | ✓ |
Left (par défaut) | ✓ | ✓ | ✓ |
Right | ✓ | ✓ | ✗ SqlError::JoinKindNotSupported |
Full | ✓ | ✗ | ✗ |
Right est facile à contourner — échangez les opérandes et utilisez Left. Full sur MySQL est généralement émulé avec (LEFT JOIN) UNION (RIGHT JOIN) si vous en avez vraiment besoin.
Autres erreurs au moment de l'émission :
- Prédicat
onvide (WhereExpr::And(vec![])ou aucunExprCompare) est rejeté avecSqlError::EmptyJoinOnCondition. SQL requiert au moins un prédicat booléen à l'intérieur duON; le raccourcitrueautomatique du WHERE de premier niveau ne s'applique pas ici.
project est actuellement une donnée morte sur les jointures ad hoc.
Le champ Join.project indique au writer d'émettre des colonnes <alias>"."<col>" AS "<alias>__<col>" dans la liste SELECT. Aujourd'hui, seul select_related décode réellement celles-ci (via le décodeur de ligne complète de la cible FK) ; les jointures ad hoc émettent les colonnes mais le décodeur Vec<MainModel> les ignore, donc remplir project sur une jointure ad hoc ne fait qu'ajouter des octets sur le réseau. Laissez-le à vec![] jusqu'à ce que le rétrécissement de projection + le décodage de tuples arrivent.
Quand recourir aux jointures ad hoc :
| Besoin | Outil |
|---|---|
| Récupérer les lignes liées avec la ligne principale | select_related |
| Charger les lignes many-to-many ou de FK inverse pour une liste de parents | fetch_with_prefetch_related |
| Filtrer les lignes principales par un prédicat de table liée | exists(...) / not_exists(...) |
| Filtrer via INNER au lieu de LEFT, ou avec des prédicats ON supplémentaires | .join(...) |
Auto-jointure (p. ex. employee.manager_id = manager.id) | .join(...) |
| Anti-jointure (lignes de A SANS correspondance dans B) | not_exists(...) |
select_related reste le bon outil quand la jointure consiste à « suivre cette FK et projeter toutes ses colonnes ». Les jointures ad hoc sont l'échappatoire lorsque vous avez besoin : d'une clé de jointure non-FK, d'INNER au lieu de LEFT, d'un prédicat supplémentaire à l'intérieur du ON, ou d'une auto-jointure.
Sauvegarde de quelques champs seulement
Écrit uniquement les champs que vous avez modifiés au lieu de chaque colonne. Une sauvegarde normale réécrit chaque colonne non-PK ; save_partial(&[...], &pool) ne réécrit que celles que vous nommez.
let mut post = Post::objects().fetch(&pool).await?.pop().unwrap();
post.title = "new title".into();
post.save_partial(&["title"], &pool).await?;  // SET "title" = $1
                                                  // — leaves body, status, views untouched
Deux motivations :
- Performance. Les lignes larges avec des colonnes
TEXT/JSON/byteapaient pour re-lier et réécrire chaque champ à chaquesave(), même quand un seul a été modifié.save_partialmaintient la clauseSETà exactement ce qui a changé. - Sécurité en concurrence. Quand deux écrivains divergent après une lecture partagée, le perdant écrase silencieusement les modifications du gagnant sur les champs qu'il n'a pas touchés. Ne nommer que le champ que vous avez réellement modifié préserve le travail de l'autre écrivain partout ailleurs.
// Writer A — flips title.
a.title = "from-A".into();
a.save_partial(&["title"], &pool).await?;

// Writer B — started from the same read, flips status.
// B's local `title` is stale, but it's not in the list, so A's
// write survives.
b.status = "from-B".into();
b.save_partial(&["status"], &pool).await?;
Les noms de champs sont les champs de struct côté Rust, pas les colonnes SQL — ["author_id"] (pas ["author"] pour un champ de type FK). Les noms de champs inconnus renvoient ExecError::Query(QueryError::UnknownField). Une liste vide est une opération sans effet (renvoie Ok(0) (lignes affectées) et journalise un tracing::warn!) : il n'y a tout simplement rien à écrire. Les modèles audités (#[rustango(audit(...))]) restreignent l'instantané du journal d'audit au même ensemble de colonnes — le journal reflète exactement ce qui a été écrit.
Note sur l'auto-PK. save_partial est réservé à l'UPDATE ; l'appeler sur une PK Auto::Unset est une erreur de l'utilisateur (utilisez insert / save pour ce cas). Contrairement à save qui répartit automatiquement Unset → insert, cette méthode suppose que vous avez déjà inséré.
Liste de champs vérifiée à la compilation
La forme à clé de chaîne ci-dessus convient aux listes de champs dynamiques (formulaires d'admin, charges utiles d'API). Quand la liste est fixée dans votre code, save_partial_typed((Post::title, ...), &pool) détecte les champs mal orthographiés ou renommés à la compilation plutôt qu'à l'exécution :
post.save_partial_typed((Post::title, Post::slug), &pool).await?;
//                       ──────────  ──────────
//                       title_col   slug_col   ← distinct ZSTs
Chaque Post::<field> est son propre type de taille zéro — une slice homogène (&[Post::title, Post::slug]) ne passe pas la vérification de type en Rust, donc l'API prend un tuple à la place. Les appels à un seul champ utilisent l'idiome de la virgule finale : (Post::title,). Les tuples sont pris en charge de l'arité 1 jusqu'à 12 — au-delà, passez à save_partial(&[&str], _).
Les tuples inter-modèles sont une erreur de compilation — (Post::title, Author::name) échoue au bound de trait TypedFieldList<Post> car le Column::Model = Author de Author::name. C'est la valeur phare par rapport à la forme à clé de chaîne : les refactorisations de renommage sur un nom de colonne remontent au site d'appel typé, pas à l'exécution.
Se ramène en interne à save_partial — même restriction d'audit, même contrainte Auto::Unset, même sémantique d'opération sans effet pour liste vide.
Opérations en masse
bulk_insert(rows, &pool)etupsert(&pool)fonctionnent sur chaque backend ;bulk_insert_on/upsert_onprennent n'importe quelSqlExecutor. Au-delà de la limite de binds, une insertion en masse écrit par blocs dans une seule transaction. MySQL n'a pas deRETURNING:bulk_inserty laisse les champsAutovides.
Piège — les opérations en masse sautent les hooks par ligne.
bulk_insert, le.update().execute_pool()sur un queryset et les suppressions en masse (delete_where,destroy) s'exécutent comme du SQL basé sur des ensembles : ils ne déclenchent pas de signaux, ne passent pas par la suppression logique, et n'exécutent pas la validation par ligne. Utilisez-les pour la vitesse ; passez ausave()/delete()par ligne quand vous avez besoin de ces effets de bord.
Vider une table. Model::truncate(&pool) exécute DELETE FROM sur chaque backend et renvoie le nombre de lignes supprimées. Le on_delete de chaque FK s'applique : tant qu'une ligne restrict pointe vers la table, l'appel échoue avec ExecError::TruncateReferenced et ne change rien. Model::truncate_cascade(&pool) vide aussi chaque table qui la référence, de proche en proche et quel que soit son on_delete : TRUNCATE … CASCADE sur PostgreSQL, un DELETE par table avec les contrôles de FK désactivés (MySQL) ou différés (SQLite). Aucun des deux ne remet les ids à zéro. Sur MySQL et SQLite, une table qui se référence elle-même en restrict peut refuser un truncate simple ; utilisez truncate_cascade. La cascade de PostgreSQL atteint aussi les tables qui la référencent dans d'autres schémas, comme des tenants en mode schéma pointant vers une table partagée ; MySQL et SQLite restent dans la base courante.
Insère, met à jour ou supprime de nombreuses lignes en une seule instruction au lieu d'en émettre une par ligne. L'import as _ amène les méthodes d'un trait dans la portée sans nommer directement le trait.
// Bulk INSERT — rows FIRST (a `&mut [Self]`), executor/pool second.
let mut rows = [p1, p2, p3];
Post::bulk_insert_on(&mut rows, &pool).await?;

// Bulk UPDATE — applies the same set to every matched row. `.set`
// takes a string column name.
Post::objects()
    .where_(Post::status.eq("draft"))
    .where_(Post::created_at.lt(thirty_days_ago))
    .update()
    .set("status", "archived")
    .execute_on(&pool).await?;

// Bulk DELETE
Post::objects()
    .where_(Post::deleted_at.is_not_null())
    .delete_on(&pool).await?;
Insertion ou mise à jour (upsert)
Insère une ligne, ou la met à jour si une ligne avec la même clé existe déjà — un upsert. Cela émet le ON CONFLICT … DO UPDATE natif de la base de données.
Le .upsert_on(executor) d'instance unique entre en conflit sur le premier unique_together du modèle, sinon sur la clé primaire : avec une PK Auto::Unset, le serveur assigne une nouvelle clé (équivalent à insert) ; avec une PK Auto::Set, la ligne est insérée si absente ou toutes les colonnes non-PK sont écrasées si présente.
// Upsert on the PK — INSERT, or UPDATE every non-PK column if the
// PK already exists.
post.upsert_on(&pool).await?;
Pour faire un upsert sur une clé unique arbitraire, utilisez l'assistant en masse — il prend les lignes, les colonnes cibles du conflit, les colonnes à mettre à jour en cas de conflit, et le pool en DERNIER :
// ON CONFLICT (external_id) DO UPDATE SET title = EXCLUDED.title
Post::bulk_upsert_pool(
    &[post],
    &["external_id"],          // conflict target (unique key)
    &["title"],                // columns to overwrite on conflict
    &pool,
).await?;
Transactions
Ne mélangez pas les appels
&pooldans une transaction. Chaque appel entretransaction_pooletcommitdoit cibler la transaction (&mut tx). Un&pool/fetch()/save(&pool)égaré emprunte une seconde connexion et peut provoquer un interblocage du pool sous charge. Faites passer letx, ou utilisezrustango::sql::atomic.
Exécutez plusieurs écritures comme une unité qui réussit toute entière ou est entièrement annulée. Ouvrez-en une avec rustango::sql::transaction_pool(&pool) : cela fonctionne sur chaque backend. Lisez avec fetch_on(&mut tx) et écrivez avec les méthodes _tx (save_tx, insert_tx, delete_tx), pour que le travail atterrisse dans la transaction ouverte et non sur une nouvelle connexion du pool.
let mut tx = rustango::sql::transaction_pool(&pool).await?;

let mut a = Account::objects()
    .where_(Account::id.eq(1))
    .fetch_on(&mut tx).await?
    .pop().unwrap();
let mut b = Account::objects()
    .where_(Account::id.eq(2))
    .fetch_on(&mut tx).await?
    .pop().unwrap();

a.balance -= 100;
b.balance += 100;
a.save_tx(&mut tx).await?;
b.save_tx(&mut tx).await?;

tx.commit().await?;
Abandonnez le tx sans appeler commit() (p. ex. sur un retour anticipé via ?) et la transaction est annulée. Pour un hook après commit, la portée est rustango::sql::atomic(&pool, |tx| Box::pin(async move { … })), qui valide en cas de Ok et annule en cas de Err — et le hook lui-même est rustango::sql::on_commit(|| { … }), appelé à l'intérieur de cette closure. atomic vide la file une fois le commit passé ; appeler on_commit hors d'une portée atomic panique au lieu d'abandonner le callback. Dans la closure, tx est un AtomicTx : verrouillez-le à chaque instruction, insert_tx(&mut *tx.lock().await?, &q). Un atomic(&pool, …) imbriqué sur le même pool s'exécute dans un savepoint sur la même connexion, et ses hooks attendent le commit le plus externe. ; garder un TxGuard pendant l'appel renvoie ExecError::NestedAtomic. L'imbrication se fait par objet pool : transmettez le pool de la requête plutôt que de le rechercher à nouveau. Deux blocs imbriqués en même temps (join!) renvoient ExecError::NestedAtomic ; un savepoint en échec annule toute la transaction avec ExecError::AtomicAborted. Une tâche lancée par tokio::spawn n'hérite pas du bloc, donc un atomic à cet endroit valide de son côté. PostgreSQL ralentit au-delà de 64 savepoints dans une transaction : évitez l'imbrication dans des boucles chaudes ; sur MySQL, un deadlock dans un bloc imbriqué annule toute la transaction, et les instructions ORM suivantes renvoient ExecError::AtomicAborted. Sur MySQL, le DDL / TRUNCATE / LOCK TABLES valident implicitement et atomic renvoie ExecError::AtomicEndedEarly avec des écritures déjà validées. MySQL et SQLite n'annulent que l'instruction en échec (clé dupliquée, SQLITE_BUSY) : une closure qui ignore l'erreur et renvoie Ok valide donc le reste ; sur PG, une lecture ou une instruction brute en échec abandonne toute la transaction, alors qu'une écriture de l'ORM en échec est annulée par son propre savepoint.
Le guide Transactions couvre atomic en entier : ce qui rejoint un bloc, les échecs par backend, les niveaux d'isolation et paramètres (atomic_with), les courses de get_or_create_tx, les formes _on, le DDL et l'annulation.
Plusieurs-à-plusieurs
Relie de nombreuses lignes à de nombreuses autres via une table de jonction — une relation plusieurs-à-plusieurs. Déclarez la relation sur le modèle, puis utilisez l'accesseur généré pour ajouter, retirer, définir ou lister les ids liés.
#[rustango(
    table = "posts",
    m2m(name = "tags", to = "tags", through = "post_tags",
        src = "post_id", dst = "tag_id"),
)]
pub struct Post { ... }
Utilisez l'accesseur généré automatiquement :
let tag_ids: Vec<i64> = post.tags_m2m().all(&pool).await?;
post.tags_m2m().add(42, &pool).await?;
post.tags_m2m().remove(42, &pool).await?;
post.tags_m2m().set(&[1, 2, 3], &pool).await?;        // replace all
post.tags_m2m().clear(&pool).await?;
let has = post.tags_m2m().contains(42, &pool).await?;
all renvoie des ids i64 ; pour des clés String ou Uuid, utilisez all::<K>(&pool).
La table de jonction (post_tags) est créée automatiquement par make_migrations avec une PK composite + deux FK ON DELETE CASCADE. Actuellement, la jonction n'a que les deux colonnes FK — pour des colonnes supplémentaires (added_by, order, created_at), vous définirez un modèle séparé et le parcourrez manuellement jusqu'à ce que le « modèle through personnalisé » arrive.
JSON / JSONB
Stocke et interroge un document JSON dans une colonne. Déclarez le champ comme serde_json::Value (le type JSON générique), puis interrogez-le avec json_contains ou un filtre de chemin.
#[derive(Model)]
pub struct Event {
    #[rustango(primary_key)]
    pub id: Auto<i64>,
    #[rustango(default = r#"'{}'::jsonb"#)]
    pub data: serde_json::Value,
}
Interroger le contenu JSON :
use rustango::core::{Expr, Op, SqlValue, WhereExpr};
use rustango::core::funcs::json_path;
use rustango::core::F;

let with_email = Event::objects()
    .where_(Event::data.json_contains(serde_json::json!({"email_set": true})))
    .fetch(&pool).await?;

// Path extract — `json_path(F("data"), &["type"], true)` builds the
// `data ->> 'type'` text-extract LHS; compare it via `where_raw`.
let typed = Event::objects()
    .where_raw(WhereExpr::ExprCompare {
        lhs: json_path(F("data"), &["type"], true),
        op: Op::Eq,
        rhs: Expr::Literal(SqlValue::String("user.created".into())),
    })
    .fetch(&pool).await?;
Lisez/écrivez des types Rust via serde_json::from_value / to_value.
Les backends diffèrent à deux endroits :
json_containsdonne les mêmes lignes sur PostgreSQL et MySQL quand la valeur a la forme de la colonne à chaque clé ({"tags": ["a"]}contre{"tags": ["a", "b"]}). MySQL fait aussi correspondre un scalaire à l'intérieur d'un tableau ({"tags": "a"}) ; PostgreSQL non. SQLite n'a pas de containment.Event::data.contains(..)/icontains(..)et lessearch_fieldsde l'admin comparent le texte JSON stocké. Cela ne concorde qu'à l'intérieur d'une seule clé ou valeur chaîne (icontains("alice")) : SQLite stocke{"a":1}, PostgreSQL et MySQL affichent{"a": 1}, clés triées de la plus courte à la plus longue, puis octet par octet ; SQLite garde le texte que rustango a écrit.
Suppression logique
Marque une ligne comme supprimée en définissant un horodatage au lieu de la retirer — une suppression logique (soft delete). Marquez la colonne d'horodatage avec l'attribut #[rustango(soft_delete)] (une annotation de derive qui indique à la macro comment traiter le champ) :
#[derive(Model)]
pub struct Post {
    #[rustango(primary_key)]
    pub id: Auto<i64>,
    pub title: String,
    #[rustango(soft_delete)]
    pub deleted_at: Option<DateTime<Utc>>,
}
Utilisation :
post.soft_delete(&pool).await?;        // sets deleted_at = NOW()
post.restore(&pool).await?;            // sets deleted_at = NULL
post.force_delete(&pool).await?;       // real DELETE

// Default queries DO include soft-deleted rows. Filter explicitly:
let live = Post::objects().where_(Post::deleted_at.is_null()).fetch(&pool).await?;
Ces méthodes prennent le &Pool et tournent sur les trois backends ; soft_delete_on / restore_on sont les formes executor, sur tous les backends (pour passer une transaction). Le bouton « Delete » de l'admin supprime en douceur tout modèle qui possède la colonne. Les requêtes par défaut incluent toujours les lignes supprimées en douceur, mais vous n'avez plus à écrire le filtre à la main : .active() les exclut, .only_trashed() ne renvoie qu'elles et .with_trashed() est un marqueur qui exprime l'intention et ne change rien — il n'annule pas un .active() précédent. Pour les exclure par défaut, déclarez un global scope — #[rustango(global_scope(name = "live", apply = live_only))], où live_only() renvoie le filtre deleted_at IS NULL — et désactivez-le par requête avec .without_global_scope("live").
Les global scopes s'appliquent à chaque QuerySet et aux raccourcis de Model construits dessus (count, sum, avg, min, max, destroy, delete_where, …). Ils ne s'appliquent pas à Model::truncate, qui vide toute la table, ni aux méthodes d'instance indexées par la clé primaire (save, save_partial, delete, soft_delete, restore) : celles-ci agissent sur la ligne que vous tenez déjà.
Journal d'audit
Enregistre qui a modifié quels champs et quand, automatiquement à chaque sauvegarde et suppression — un historique des modifications par ligne. Annotez le modèle avec les champs à suivre :
#[derive(Model)]
#[rustango(audit(track = "title, body, status"))]
pub struct Post { ... }
Chaque sauvegarde/suppression écrit une ligne dans rustango_audit_log avec un diff JSONB before / after pour les champs listés. Définissez la source par requête :
use rustango::audit::{with_source, AuditSource};

with_source(
    AuditSource::User { id: user_id.to_string() },
    async {
        post.save(&pool).await
    },
).await?;
Le panneau d'historique par ligne de l'admin lit dans cette table ; le flux inter-modèles est à <admin prefix>/__audit (Builder::audit_url le change ; l'admin de tenant utilise RouteConfig::audit_url, par défaut /audit).
Les lignes auditées qu'une FK on_delete = "cascade" supprime reçoivent une entrée delete, lue avant la suppression dans sa transaction. Les lignes modifiées par set_null / set_default reçoivent une entrée update, et Model::truncate / truncate_cascade écrivent une entrée groupée par table auditée qu'ils modifient. Cela s'exécute sur les chemins pool et transaction (delete, PoolTx, PoolConn), par 500 lignes supprimées à la fois : les lignes en cascade de chaque tranche sont lues avec FOR UPDATE et gardées en mémoire avec leurs entrées jusqu'à la suppression de la tranche. Sur un exécuteur sqlx brut (delete_on(&mut pg_conn)), une telle suppression est refusée avec ExecError::AuditUnsupported. Une FK DEFERRABLE INITIALLY DEFERRED ne cascade qu'au commit, donc ses lignes ne reçoivent pas d'entrées.
Nettoyage :
rustango::audit::cleanup_older_than_pool(&pool, 90).await?;  // delete > 90 days
rustango::audit::cleanup_keep_last_n_pool(&pool, 50).await?; // keep most recent 50/row

// CLI
manage audit-cleanup --days 90
manage audit-cleanup --keep-last 50 --tenant acme
Les utilitaires _pool prennent un &Pool et fonctionnent sur les trois backends. Le verbe audit-cleanup nécessite la feature tenancy. Il élague le journal du registre et celui de chaque tenant actif ; --tenant <slug> ou --registry le restreint, et un N de 0 ou moins exige --yes.
Échappatoire vers le SQL brut
Passe au SQL écrit à la main quand le query builder ne peut pas exprimer ce dont vous avez besoin. Les macros sqlx exécutent une requête et décodent le résultat en un tuple, un Model typé, ou rien :
use rustango::sql::sqlx;

// sqlx runs on one driver's pool. Take it with `as_sqlite()` (or
// `as_postgres()` / `as_mysql()`) and write that backend's SQL.
let db = pool.as_sqlite().ok_or("not a SQLite pool")?;

// Raw query → typed rows
let rows = sqlx::query_as::<_, (i64, String)>("SELECT id, title FROM posts WHERE views > ? ORDER BY views DESC")
    .bind(1000)
    .fetch_all(db)
    .await?;

// Raw with model decoding
let posts: Vec<Post> = sqlx::query_as::<_, Post>("SELECT * FROM posts WHERE complicated_condition")
    .fetch_all(db)
    .await?;

// Raw without rows (DDL / DML)
sqlx::query("VACUUM").execute(db).await?;
Pour du SQL brut programmatique au sein de la couche de requêtes Rustango (tri-dialecte ; prend le SQL, un Vec<SqlValue> de valeurs à lier, puis le pool en DERNIER, et renvoie Vec<T>) :
use rustango::sql::raw_query_pool;

let rows = raw_query_pool::<(i64,)>(
    "SELECT COUNT(*) FROM posts WHERE complicated",
    vec![],
    &pool,
).await?;
let count = rows.first().map(|r| r.0).unwrap_or(0);
Chargement paresseux des clés étrangères
Une clé étrangère commence par ne détenir que l'id lié (Unloaded), et vous ne récupérez la ligne liée complète que lorsque vous la demandez (chargement paresseux). Faites un match sur la ForeignKey pour gérer les deux états, ou appelez .get_pool(&pool) pour la charger à la demande. Pour tout un lot, utilisez select_related (ci-dessus) afin de les précharger en une seule requête et de sauter la récupération par ligne.
let mut post = Post::objects().find_or_fail(1, &pool).await?;

// FK starts Unloaded — just the PK. `Loaded` is a struct variant
// `{ pk, value }`; `value` is a `Box<Author>`.
match &post.author {
    ForeignKey::Unloaded(pk) => println!("author id = {pk}"),
    ForeignKey::Loaded { pk, value } => println!("author = {}", value.name),
}

// Force-load
let author = post.author.get_pool(&pool).await?;     // fetches if Unloaded
get_pool prend le &Pool multi-backend, et get_on(executor) prend une connexion ou une transaction.
Utilisez select_related("author") sur le queryset pour précharger un lot.
Quatre façons de filtrer
Il y a quatre façons d'exprimer un filtre ; choisissez selon le contexte. Les colonnes typées sont vérifiées à la compilation et conviennent le mieux au code applicatif ; la forme chaîne field__lookup est la syntaxe adaptée à l'admin et au CRUD générique ; filter_op est pour quand vous détenez déjà un Op ; la chaîne de requête HTTP pilote l'API publique.
// 1. HTTP query string (set via ViewSet filter_fields)
//    GET /api/posts?author_id=42&status__ne=archived

// 2. String lookup (the same `field__lookup` grammar your
//    URL parser uses, but inside Rust). Suffix decides the operator
//    and value-shape; bare key is exact-eq. Field name is validated
//    at `.compile()`.
Post::objects()
    .filter("status", "published")                 // exact-eq
    .filter("title__icontains", "rust")            // ILIKE %rust%
    .filter("views__gt", 100_i64);

// 3. Explicit operator (legacy 3-arg shape — when you want to pass
//    an Op directly without parsing a suffix)
Post::objects().filter_op("author_id", Op::Eq, SqlValue::I64(42));

// 4. Typed columns (compile-time field check; preferred in app code)
Post::objects().where_(Post::author_id.eq(42));
Convention : typé dans le code applicatif, forme chaîne dans le code d'admin / CRUD générique, filter_op seulement lorsque vous avez déjà calculé un Op (p. ex. depuis un parseur de requête), requête HTTP pour la surface d'API publique.
Suffixes de lookup pris en charge
| Suffixe | Opérateur SQL | Forme de valeur | Notes |
|---|---|---|---|
(aucun) / __exact | = | scalaire | clé nue = égalité exacte ; None → IS NULL |
__ne | <> | scalaire | None → IS NOT NULL |
__gt / __gte / __lt / __lte | > >= < <= | scalaire | |
__contains | LIKE | chaîne | encapsule la valeur en %v% ; sensible à la casse partout (MySQL COLLATE utf8mb4_bin, SQLite GLOB) |
__icontains | ILIKE | chaîne | encapsule la valeur en %v% ; émulé sur MySQL via LOWER() |
__startswith | LIKE | chaîne | encapsule en v% |
__istartswith | ILIKE | chaîne | encapsule en v% |
__endswith | LIKE | chaîne | encapsule en %v |
__iendswith | ILIKE | chaîne | encapsule en %v |
__iexact | ILIKE | chaîne | pas d'encapsulation par joker — correspondance exacte insensible à la casse |
__in | IN (…) | SqlValue::List | rejette les valeurs non-liste |
__isnull | IS NULL / IS NOT NULL | bool | true → IS NULL, false → IS NOT NULL |
__between / __range | BETWEEN … AND … | SqlValue::List à 2 éléments | inclusif aux deux bornes |
__regex / __iregex | PG ~ / ~*, MySQL/SQLite REGEXP | chaîne | drapeau de casse inline (?i) / (?-i) sur MySQL/SQLite ; SQLite nécessite une fonction utilisateur regexp |
Les métacaractères de LIKE sont échappés.
__contains/__startswith/__endswith(et leurs variantesi) traitent la valeur comme une sous-chaîne littérale — un%ou_y correspond à lui-même, pas comme joker. Le framework les échappe et émetESCAPE '!', respecté sur les trois dialectes. Pour un motif brut où vous placez vos propres%/_, utilisez__like/__ilike, qui lient la valeur telle quelle.
Les erreurs remontent à .compile(), pas au moment de l'appel .filter() — les incohérences de forme de valeur (p. ex. __in avec un scalaire, __isnull avec un non-bool, __between avec la mauvaise arité) et les suffixes inconnus (status__nope) renvoient QueryError::UnknownLookup / QueryError::InvalidLookupValue depuis .compile() afin que la chaîne fluide reste propre au niveau du typage. Les clés qui traversent des relations (author__name__icontains) fonctionnent sur le chemin SELECT : compile() ajoute pour vous les JOIN de la chaîne de FK. Les chemins de mise à jour, de suppression et d'agrégation ne les prennent pas en charge et renvoient une erreur.
Chaque appel de filtre se joint par AND à ceux qui le précèdent ; mélangez librement forme chaîne, filter_op et where_ sur le même queryset.
Requêtes limitées au tenant
Dans une application multi-tenant, exécute chaque requête contre la connexion du tenant courant plutôt que contre le pool partagé. Saisissez une connexion par requête et passez-la à fetch_on (qui accepte n'importe quel exécuteur de base de données) au lieu de fetch (qui utilise toujours &pool).
use rustango::extractors::Tenant;

async fn handler(mut t: Tenant) -> Result<...> {
    let conn = t.conn().await?; // &mut PgConnection for this tenant
    let posts = Post::objects().fetch_on(&mut *conn).await?;
    Ok(...)
}
Les tenants en mode schéma partagent le pool du registre mais dépendent d'un
SET search_path par checkout, si bien que passer &PgPool toucherait
silencieusement le mauvais schéma.
En mode une base par tenant (SQLite, MySQL ou Postgres, avec un
DatabaseTenantContext), prenez TenantScope pour l'ORM (ou Tenant<DB> sur
SQLite et MySQL). Son t.pool() est le pool propre au tenant : toutes les méthodes de pool marchent,
écritures comprises, et aucune connexion n'est tenue avant la première requête.
Le t.conn() de l'extracteur DatabaseTenant ne sert qu'aux lectures _on.
Par exemple post.insert(t.pool()) et Post::objects().count(t.pool()) ;
l'exemple sqlite_tenant_demo fait exactement cela.
Une connexion par requête
Chaque fetch(&pool) emprunte sa propre connexion. Pour exécuter les requêtes
d'un handler sur une seule, prenez-la avec let mut conn = pool.acquire().await?;
(un PoolConn) et passez &mut conn aux méthodes _on, p. ex.
Post::objects().fetch_on(&mut conn). Cela fonctionne sur les trois backends.
conn.begin() ouvre un PoolTx sur la même connexion.
Les méthodes _on sont fetch_on, first_on, count_on, exists_on,
fetch_paginated_on, in_bulk_on, explain_on, delete_on sur un queryset,
execute_on sur update(), ForeignKey::get_on, annotate_count_children_on,
fetch_aggregate_on, et fetch_on sur values(), values_list(), values_list_flat()
(plus first_on) et aggregate(). Elles prennent n'importe quel SqlExecutor :
&mut PoolConn, &mut PoolTx, &Pool, ou sur Postgres n'importe quel exécuteur
sqlx (&PgPool, &mut PgConnection, t.conn()).
Une connexion retourne au pool avec tout état de session que vous y avez défini
(SET …, @vars MySQL, PRAGMA SQLite) ; l'emprunteur suivant en hérite, ce
qui, sur un pool de registre, peut être la requête d'un autre tenant. Après un
tel changement, appelez conn.close_on_drop(), pour que la connexion soit
fermée au lieu d'être réutilisée.
Tant que vous tenez un PoolConn, passez-le à chaque requête : une méthode
&Pool dans le même handler emprunte une seconde connexion. Avec
max_connections requêtes de ce type à la fois, chacune en tient une et en
attend une autre, et toutes expirent. Libérez la connexion avant d'appeler du
code qui prend &Pool.
Signaux
Exécute une fonction de rappel quand quelque chose se produit — les signaux. Il y a deux registres indépendants : un pour les écritures de modèle, un pour les requêtes HTTP.
Cycle de vie du modèle
Déclenche un hook avant ou après qu'un modèle soit sauvegardé ou supprimé : pre_save, post_save, pre_delete, post_delete. Enregistrez-en un avec connect_post_save::<Post, _, _>(...).
Sauvegarder ne les envoie pas : aucune écriture de l'ORM ne déclenche ces signaux, appelez donc vous-même send_post_save(&post, PostSaveContext { created }) (et les autres) après l'écriture.
use rustango::signals::{connect_post_save, PostSaveContext};

connect_post_save::<Post, _, _>(|post, ctx| async move {
    if ctx.created {
        tracing::info!("new post #{}", post.id.get().copied().unwrap_or(0));
    }
});
T: Clone + 'static est requis (le distributeur remet à chaque récepteur un clone Arc<T>). Les récepteurs s'exécutent séquentiellement dans l'ordre d'enregistrement. Déconnectez via le ReceiverId renvoyé par connect_*. Les quatre types de signaux + leurs formes de contexte sont documentés en ligne dans rustango::signals.
Cycle de vie de la requête
Déclenche un hook autour de chaque requête HTTP : request_started, request_finished, got_request_exception. Ajoutez le middleware RequestSignalsLayer à votre routeur, puis connectez les fonctions de rappel. Utile pour le traçage, l'audit, les métriques au moment de la requête et le reporting d'erreurs.
use axum::Router;
use rustango::signals::request::{
    connect_request_started, connect_request_finished, RequestSignalsLayer,
};

connect_request_started(|ctx| Box::pin(async move {
    tracing::info!(method = %ctx.method, path = %ctx.path, "started");
}));
connect_request_finished(|ctx| Box::pin(async move {
    metrics::histogram!("http_request_ms").record(ctx.elapsed_ms);
}));

let app: Router = Router::new()
    .route("/", get(home))
    .layer(RequestSignalsLayer::new());  // outermost — sees request first / response last
| Signal | Champs de contexte |
|---|---|
request_started | method, path, query |
request_finished | method, path, status, elapsed_ms |
got_request_exception | method, path, error |
Les récepteurs s'exécutent séquentiellement dans l'ordre d'enregistrement ; encapsulez un corps dans tokio::spawn pour un fanout parallèle ou l'isolation des paniques. Les registres de requête et de modèle sont indépendants — connecter / déconnecter / vider l'un ne touche pas l'autre.
Conseils de performance
Une liste de contrôle rapide pour garder les requêtes rapides à mesure que les données grandissent :
- Utilisez toujours des index pour les colonnes de
WHEREetORDER BY. Déclarez-les via#[rustango(index)]afin qu'ils soient dans les migrations. select_relatedpour l'affichage des FK dans les listes — élimine le N+1 dans les vues d'admin/liste..limit()/fetch_paginated_onau lieu de tout charger — ne chargez jamais des tables entières.- Pagination par curseur pour les tables énormes — évite le
COUNT(*)par page. bulk_insert_onoubulk_upsert_poolpour les lots — un seul aller-retour au lieu de N.upsert_onpour les imports idempotents —ON CONFLICTest plus rapide que SELECT-puis-INSERT.transaction_pool/atomicpour les écritures liées — réduit le surcoût de commit et maintient la cohérence.- Mettez en cache les lectures chaudes avec
cache::get_or_set— invalidez sur le gestionnaire de signalconnect_post_save<T>(...).
Voir aussi
- Modèles — déclarer un modèle : types de champs, clés primaires, chaque attribut (le compagnon de ce guide de requêtes).
- Sérialiseurs — mettre en forme les lignes de modèle en JSON.
- ViewSets — transformer un modèle en API CRUD JSON.
- L'admin — une UI générée automatiquement au-dessus des mêmes modèles.
- CLI
manage—makemigrations/migratepour les changements de schéma.