 Rustango
Caching
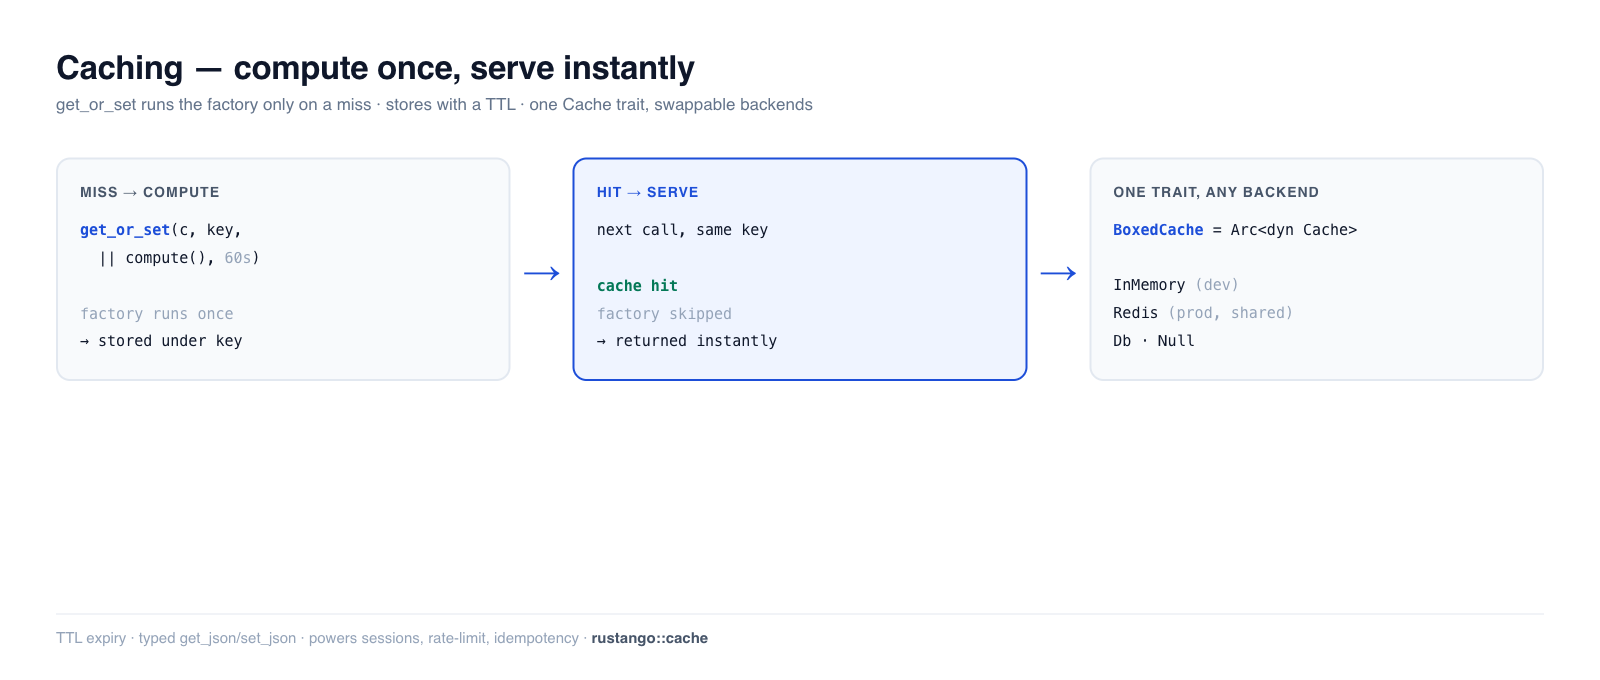
Caching speichert das Ergebnis teurer Arbeit — eine schwere Query, ein
gerendertes Fragment, einen Drittanbieter-API-Aufruf — sodass der nächste
Request es sofort erhält, statt es neu zu berechnen. Rustango gibt dir einen
Cache-Trait mit austauschbaren Backends (In-Memory, Redis, Datenbank), einen
Compute-on-Miss-Helfer (get_or_set) und typisierte JSON-Helfer. Tausche das
Backend, ohne eine einzige Aufrufstelle anzufassen: die Aufrufe bleiben gleich,
nur die Konfiguration ändert sich.
Ein Begriff hier neu für dich? Cache, TTL, Key, Backend — siehe das Glossar.
Quelle:
rustango::cache(Cache,InMemoryCache,NullCache,get_or_set,get_json,set_json,BoxedCache,from_settings) — hinter dercache-Feature (standardmäßig aktiv).RedisCachebenötigt diecache-redis-Feature (standardmäßig aus).Ausführbare Version: jeder Codeausschnitt ist aus
cache_doc.rskopiert (cargo test -p rustango --test cache_doc); das Datenbank-Backend wird per Dogfooding auf SQLite durchcache_db_backend_sqlite_live.rserprobt.
Inhaltsverzeichnis
- Schritt 1 — Ein Backend wählen
- Schritt 2 — get / set / delete
- Schritt 3 — get_or_set (Cache-Aside)
- Typisierte JSON-Werte
- TTL und Ablauf
- Backends tauschen
- Caching unter Multi-Tenancy
- Ganze Seiten cachen
- Referenz
- Siehe auch
Schritt 1 — Ein Backend wählen
Jedes Backend implementiert denselben Cache-Trait, dein Code ist also
identisch, welches du auch wählst. Der App-Code hält einen BoxedCache
(Arc<dyn Cache>) und nennt nie den konkreten Typ:
use rustango::cache::{BoxedCache, InMemoryCache};
use std::sync::Arc;

let cache: BoxedCache = Arc::new(InMemoryCache::new());
| Backend | Feature | [cache] backend | Verwenden für |
|---|---|---|---|
InMemoryCache | cache | memory (Standard) | Dev, Tests, Einzelprozess (HashMap pro Prozess + TTL) |
RedisCache | cache-redis | redis | Produktion; über Replicas geteilt |
DatabaseCache | cache | db / database | Produktion ohne Redis; eine rustango_cache-Tabelle |
FileCache | cache | file | eine Datei pro Key unter file_cache_dir; nur geteilt, wenn das Verzeichnis es ist |
NullCache | cache | null / none | Caching deaktivieren (jeder Read verfehlt) — praktisch in Tests |
Einen Wert postgres gibt es nicht — das DB-Backend ist db oder database.
Ein Doc-Kommentar von CacheSettings behauptete früher etwas anderes, und ein
unbekannter Wert liefert einen In-Memory-Cache mit einer Warnung.
Es gibt keinen Wert postgres — das DB-Backend heißt db oder database. Werte
sind kleingeschrieben. Ein unbekannter oder falsch geschriebener Wert (Redis,
ein Tippfehler) oder file ohne file_cache_dir wird abgelehnt: from_settings
panict beim Start, from_settings_async gibt den Fehler zurück. Ein Ersatz pro
Prozess würde brechen, was ein geteilter Cache garantiert.
FileCache räumt alle 16 Schreibvorgänge ein Sechzehntel seines Verzeichnisses
von abgelaufenen Einträgen. Rufe FileCache::purge_expired() regelmäßig auf, um
alles zu räumen. Neue Verzeichnisse werden unter Unix mit 0700 angelegt, Einträge
mit 0600.
Schritt 2 — get / set / delete
Der Kern des Traits sind vier async-Methoden. set nimmt ein optionales TTL
(None = kein Ablauf); get gibt Option<String> zurück (None bei einem
Miss):
use rustango::cache::{Cache, InMemoryCache};

let cache = InMemoryCache::new();

assert_eq!(cache.get("greeting").await?, None);     // miss
cache.set("greeting", "hello", None).await?;        // store, no expiry
assert_eq!(cache.get("greeting").await?.as_deref(), Some("hello"));
assert!(cache.exists("greeting").await?);

cache.delete("greeting").await?;                    // gone
Es gibt auch Batch-Varianten — get_many / set_many / delete_many.
Schritt 3 — get_or_set (Cache-Aside)
Das ist die, zu der du am häufigsten greifst. get_or_set gibt den gecachten
Wert zurück, oder — bei einem Miss — führt deine Factory aus, speichert das
Ergebnis mit einem TTL und gibt es zurück. Die Factory läuft nur bei einem
Miss:
use rustango::cache::get_or_set;
use std::time::Duration;

let stats: HomeStats = get_or_set(
    &*cache,                       // &dyn Cache
    "home:stats",
    || async { compute_home_stats(&pool).await },   // runs only on a miss
    Some(Duration::from_secs(60)),                   // cache for 60s
).await?;
Der zugrunde liegende Test ruft get_or_set zweimal für denselben Key auf und
stellt sicher, dass die Factory genau einmal lief — der zweite Aufruf wird
aus dem Cache bedient.
Bei Schreibvorgängen invalidieren. Cache-Aside bedeutet veraltete Daten, bis das TTL abläuft. Für Daten, die sich ändern, mache auch
delete(key), wenn du sie schreibst — z. B. aus einempost_save-Signal, das du nach dem Speichern sendest (das Speichern selbst sendet es nicht) — damit der nächste Read neu berechnet.
Typisierte JSON-Werte
get_json / set_json serialisieren jeden Serialize/Deserialize-Typ nach
JSON, sodass du Structs und Listen cachst, nicht nur Strings:
use rustango::cache::{get_json, set_json};

#[derive(serde::Serialize, serde::Deserialize)]
struct Profile { id: i64, name: String }

set_json(&*cache, "profile:7", &profile, None).await?;
let back: Option<Profile> = get_json(&*cache, "profile:7").await?;   // None on a miss
(get_or_set verwendet diese unter der Haube, weshalb sein Werttyp
Serialize + Deserialize sein muss.)
TTL und Ablauf
Übergib eine Duration an set (oder get_or_set) und der Eintrag verschwindet
danach. Verifiziert: ein 50-ms-Eintrag ist sofort lesbar und nach 80 ms weg.
cache.set("flash", "x", Some(Duration::from_millis(50))).await?;
// ...50ms later...
assert_eq!(cache.get("flash").await?, None);   // expired
InMemoryCache::with_default_ttl(d) setzt ein Standard-TTL, das angewendet wird,
wenn du None übergibst.
Ein TTL ist eine Obergrenze, keine Garantie
InMemoryCache ist standardmäßig größenbegrenzt — 256 MiB oder 100 000
Einträge, je nachdem, was zuerst erreicht wird — mit annähernder LRU-Verdrängung.
Eine Flut eindeutiger Schlüssel kann den Prozess so nicht unbegrenzt wachsen
lassen, bedeutet aber auch: ein Eintrag kann vor Ablauf seines TTL
verschwinden, wenn er beim Erreichen des Budgets der am längsten unbenutzte
ist. Die Verdrängung entfernt zuerst bereits abgelaufene Einträge, dann die am
längsten unbenutzten, bis beide Budgets um 10 % unterschritten sind. Mit
set_forever geschriebene Einträge (Feature-Flags) liegen außerhalb der Budgets
und werden nie verdrängt, solange sie in ihren eigenen Grenzen bleiben — 16 MiB
oder 10 000 Einträge (.with_max_pinned_bytes(..) / .with_max_pinned_entries(..)).
Darüber werden neue set_forever-Einträge als normale, verdrängbare Einträge
gespeichert, und einmal wird eine Warnung geloggt.
Behandle einen Cache-Read also auch innerhalb des TTL als „kann fehlen". Das gilt für jedes Cache-Backend, hier hat es aber eine Ursache, über die du nachdenken und an der du drehen kannst:
InMemoryCache::new()
    .with_max_bytes(512 * 1024 * 1024)   // Budget anheben
    .with_max_entries(0)                 // 0 = unbegrenzt (Verhalten vor der Begrenzung)
Das TTL selbst wird faul beim Lesen durchgesetzt — es gibt keinen Hintergrund-Thread zur Verdrängung, ein abgelaufener Eintrag belegt seinen Platz also weiter, bis etwas ihn abfragt oder die Verdrängung ihn erreicht.
Backends tauschen
Weil alles der Cache-Trait ist, ist der Wechsel von In-Memory zu Redis eine
einzeilige Änderung beim Start — meist von der Konfiguration gesteuert, sodass sie
sich pro Umgebung unterscheidet:
// Build the cache from `[cache]` settings. `from_settings_async` is the one
// to reach for — it can build the backends that need to connect.
let cache: BoxedCache = rustango::cache::from_settings_async(&settings.cache).await?;
backend | from_settings (sync) | from_settings_async |
|---|---|---|
memory, null, file | ✓ | ✓ |
redis | panik — synchron nicht baubar | ✓ |
db | panik — braucht einen &Pool zur Laufzeit | Fehler; dort bauen, wo der Pool ist |
Der synchrone Resolver bricht ab, statt einen anderen Backend unterzuschieben. Früher warnte er und
lieferte einen In-Memory-Cache — das ist kein abgeschwächter geteilter Cache,
sondern ein anderer. Ein prozesslokaler Cache multipliziert das Limit von
CacheRateLimitLayer mit der Anzahl der Replicas und lässt verify_single_use
nicht mehr fail-closed laufen, sodass derselbe Reset-Link einmal pro Replica
funktioniert. Beides ist dokumentiert als funktionierend, weil der Cache
geteilt ist, und eine Warnung beim Start erreicht niemanden, der das eine Woche
später debuggt.
db lässt sich überhaupt nicht aus [cache] bauen, weil DatabaseCache einen
Pool braucht, den die Settings nicht tragen:
let cache = DatabaseCache::new(pool.clone(), "rustango_cache");
cache.ensure_table().await?;
let boxed: BoxedCache = std::sync::Arc::new(cache);
In der Produktion richtest du es auf Redis (über alle deine Replicas geteilt):
use rustango::cache::RedisCache;   // needs the `cache-redis` feature
let cache: BoxedCache = std::sync::Arc::new(RedisCache::new("redis://localhost").await?);
Dieselben get / set / get_or_set-Aufrufe — nur der Konstruktor hat sich
geändert.
Caching unter Multi-Tenancy
Cache ist ein flacher, &str-indizierter Store — und das macht unter
Multi-Tenancy den naheliegenden Key zum undichten Key: ein Handler (oder
schlimmer ein Background-Task, der gar keinen ambienten Tenant hat) schreibt
"stats:monthly" für einen Tenant, und jeder andere Tenant liest es zurück.
Nimm die Sicht des Tenants mit CacheScope::for_tenant(..).app() (intern
ein ScopedCache), damit der Namespace für dich angewendet wird und die
Aufrufstelle es nicht vergessen kann:
use rustango::cache::CacheScope;

// From the Org the resolver already produced:
let tenant = TenantSlug::of(&t.org).expect("a registry org");
let cache = CacheScope::for_tenant(shared.clone(), &tenant).app();

cache.set("stats:monthly", &json, ttl).await?;   // stored as tenant:#org:7:acme:app:stats:monthly
cache.get("stats:monthly").await?;               // reads only acme's entry
cache.clear().await?;                            // drops ONLY acme's entries
Die Sicht ist selbst ein Cache und passt damit überall hinein, wo ein
BoxedCache erwartet wird — cache_page, cache_fragment, die Rate-Limiter,
DistributedLock. Sie leitet mit gemappten Keys an das innere Backend weiter,
statt etwas neu zu implementieren, sodass native Primitive (Redis INCRBY,
SET NX) ihre Atomarität behalten. get_many / set_many / delete_many werden
auch weitergeleitet, aber kein mitgeliefertes Backend bündelt sie bisher: jeder
Key ist ein eigener Roundtrip.
Atomare Zähler und Sperren. Cache::incr steckt hinter
Rate-Limiting und Konto-Sperren; Cache::add (set-if-absent)
steckt hinter DistributedLock. Cache::add ist bei allen dreien atomar — RedisCache
(SET NX), InMemoryCache (das seine Sperre über das Read-Modify-Write hält)
und DatabaseCache, das das Test-and-Set unter Zeilensperren ausführt, sodass
ein Wettlauf genau einen Gewinner hat. Cache::incr ist ebenfalls auf allen
dreien atomar: DatabaseCache erledigt es in einem Upsert. FileCache macht
beides unter einer Sperre pro Eintrag, die nur auf einem Host gilt. Ein
DistributedLock oder ein exakter Zähler funktioniert über Replikate hinweg also
mit Redis oder der Datenbank. Jedes Backend zählt über den ganzen i64-Bereich;
ein Überlauf ist ein Fehler und lässt den Zähler unverändert.
Ein gespeicherter Wert zählt nur in der exakten Form, die incr schreibt
("7", "-3"); "+7", "007", " 5" oder "abc" zählen überall als 0. Ein
Textwert mit NUL-Zeichen wird von jedem Backend abgelehnt; solche Daten mit
set_bytes speichern.
Zwei Dinge, die man wissen sollte:
| Ein Namespace, keine Sicherheitsgrenze | Alles liegt weiter in einem Backend, und Code mit dem ungescopeten Cache kann jeden Key lesen. Der Punkt ist, dass der ergonomische Pfad der korrekte ist. |
clear() braucht Key-Enumeration | Es läuft über Cache::delete_prefix, und jedes eingebaute Backend implementiert das: InMemoryCache filtert seine Map, DatabaseCache schickt ein DELETE … LIKE 'prefix%' mit escaptem %, _ und Escape-Zeichen, RedisCache nutzt SCAN+MATCH mit escapten Glob-Metazeichen, und FileCache scannt sein Verzeichnis und vergleicht den in jedem Eintrag gespeicherten Key. Ein Backend, das es nicht implementiert, liefert jetzt einen Fehler statt eines Fallbacks. DatabaseCache speichert Keys über 255 Bytes gehasht und vergleicht ein Präfix über 190 Bytes nur auf seinen ersten 190 Bytes; es löscht also eventuell mehr Keys, nie weniger. |
Das ungescopete Cache::clear() ist weiterhin prozessweit — greife also zur
gescopeten Sicht, wann immer die Änderung eines einzelnen Tenants die
Invalidierung ausgelöst hat.
Tenant-Keys sind tenant:#org:<id>:<slug>:<area>:<rest>, mit je einem
Bereich für App-Keys, Locks, Idempotency, Seiten, KeyBy::Tenant-Rate-Limits,
Sessions und Flag-Overrides. Login-Throttle, Account-Lockout und der
MCP-Key-Cache behalten ihr eigenes Layout und ihren eigenen Purge. Ein clear() des Tenant-App-Caches löscht nur den Bereich
app und gibt also nie den Lock eines laufenden Jobs frei.
Der Slug eines gelöschten Tenants kann von einem neuen Tenant wiederverwendet
werden. Damit purge-tenant die Keys des alten Tenants löscht, rufe beim Start
rustango::tenancy::decommission::clear_on_purge(cache) für jeden Cache auf,
der sie hält. Der Purge löscht dort jeden Bereich
(CacheScope::for_tenant(cache, &tenant).purge() tut dasselbe von Hand).
Ganze Seiten cachen
CachePageLayer::new(cache) (in rustango::cache_page) speichert GET-Antworten
in einem beliebigen BoxedCache; .timeout(dur) legt fest, wie lange (Standard
60 s). Es ist standardmäßig sicher:
- Ein Request mit
Authorization,CookieoderX-Api-Keywird weder aus dem Cache bedient noch darin gespeichert. Weitere Credential-Header (etwa einen eigenen Token-Header) nennst du mit.credential_headers(["x-my-token"])..cache_authenticated(true)schaltet das ab, nur für eine Route, deren Seite für jeden Aufrufer gleich ist. - Eine Antwort mit
Set-CookieoderCache-Control: private,no-cacheoderno-storewird nie gecacht. .vary_on([...])nimmt Request-Header in den Key auf.- Standardmäßig steht der rohe Query-String im Key: jede andere Query legt einen
eigenen Eintrag an, und
?x=<zufällig>kann den Cache füllen..query_keys(["page", "q"])nimmt nur diese Parameter, sortiert;.ignore_query()lässt die Query weg. .key_prefix(..)gibt jedem Layer einen eigenen Schlüsselraum (Standardrustango.cache_page)..cache_query(true)cacht auchQUERY-Anfragen, mit einem Digest des Bodys (bis 1 MiB) im Key..tenant_agnostic(true)cacht ohne aufgelösten Mandanten, nur für eine Seite, die für jeden Mandanten gleich ist.
Um eine Seite nach einem Schreibvorgang zu verwerfen, rufe
layer.invalidate(&[PageKey::new(path, host)]).await? auf einem Klon des Layers
auf (unter Tenancy hänge .tenant(&slug) an den Key, den TenantSlug der
Anfrage, z. B. aus RequestTenant::tenant()). Das löscht jede gecachte
Variante dieses Pfads: jeden Query-String, jeden vary_on-Wert, GET und QUERY
gleichermaßen. Es arbeitet mit einem Generationszähler pro Pfad, daher liest
jeder gecachte GET einen weiteren kleinen Cache-Key.
Unter Tenancy hängst du den Layer innerhalb des Tenancy-Layers ein; siehe Middleware.
Referenz
Cache-Trait: get · set(key, value, ttl) · set_forever · delete ·
exists / has_key · clear · delete_prefix · incr / decr · add
(setzen, falls fehlend) · touch (neuer TTL) · get_bytes / set_bytes ·
get_many / set_many / delete_many · get_or(key, default).
Freie Helfer: get_or_set(cache, key, factory, ttl) ·
get_json / set_json · from_settings(&CacheSettings) ·
from_settings_async(&CacheSettings).
Aufräumen: DatabaseCache::purge_expired() und
FileCache::purge_expired() löschen abgelaufene Einträge; rufe sie zeitgesteuert auf.
DatabaseCache löscht zudem alle 256 Schreibvorgänge einen Schub abgelaufener Zeilen
(.purge_every(n), 0 schaltet das ab). FileCache behält höchstens 100 000 Einträge
und 1 GiB (.max_entries(n), .max_bytes(n) oder file_cache_max_entries /
file_cache_max_bytes in [cache]; 0 hebt eine Grenze auf) und löscht die ältesten zuerst.
Was auf dem Cache aufbaut: serverseitige Sessions,
verteiltes Rate Limiting (CacheRateLimitLayer),
Idempotenz-Schlüssel und Feature-Flags nehmen alle einen BoxedCache — sodass
eine einzige Redis-Instanz sie alle stützt.
Siehe auch
- Hintergrund-Jobs — die andere Hälfte, um Requests schnell zu halten (Arbeit aufschieben, statt ihr Ergebnis zu cachen).
- Sessions — ein serverseitiger Store, der auf
Cacheaufbaut. - Middleware —
CacheRateLimitLayerteilt einen Zähler über Replicas hinweg via Cache. - ORM-Cookbook — gecachte Reads aus einem
post_save-Signal invalidieren.