 Rustango
Hintergrund-Jobs
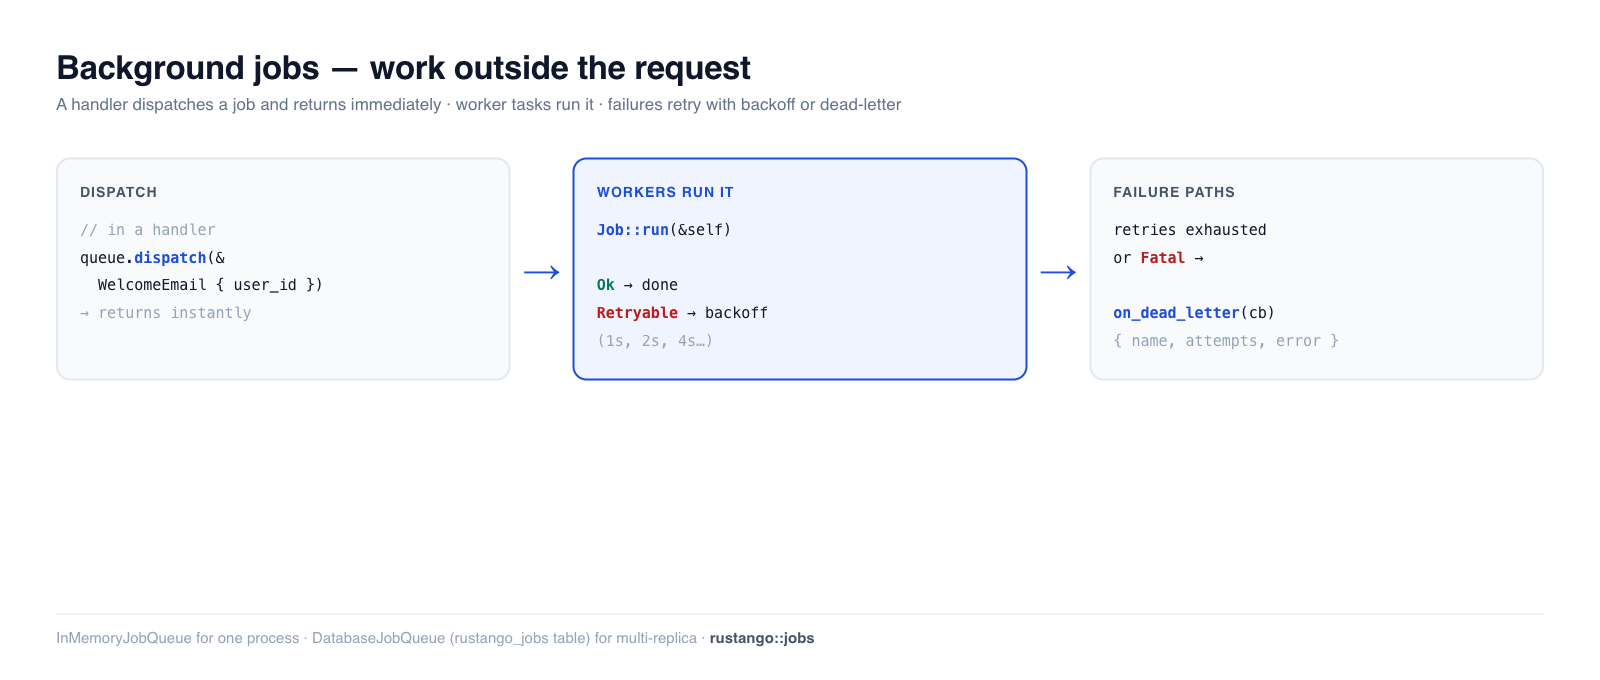
Manche Arbeit sollte nicht während eines Requests passieren — eine Willkommens-E-Mail senden, einen Upload skalieren, eine Drittanbieter-API synchronisieren. Es inline zu tun lässt den Benutzer warten und koppelt die Response an einen unzuverlässigen externen Aufruf. Ein Hintergrund-Job verschiebt diese Arbeit auf eine Queue: der Handler kehrt sofort zurück, und ein Pool von Workern führt den Job Augenblicke später aus, mit automatischen Retries und einem Dead-Letter-Pfad für Fehlschläge — eine Task-Queue, vollständig in Rust.
Ein Begriff hier neu für dich? Queue, Worker, Retry/Backoff, Dead-Letter — siehe das Glossar.
Quelle:
rustango::jobs(Job,JobQueue,InMemoryJobQueue,JobError,JobDeadLetter) undrustango::jobs::DatabaseJobQueue(die tabellengestützte Queue, Alias vonpg::PgJobQueue) — hinter derjobs-Feature;DatabaseJobQueueundmake:workerbrauchen zusätzlichjobs-postgres(beide standardmäßig aktiv).Ausführbare Version: die In-Memory-, Retry- und Dead-Letter-Snippets sind aus
jobs_doc.rskopiert (cargo test -p rustango --test jobs_doc); die persistente Queue wird per Dogfooding auf SQLite durchjobs_sqlite_live.rserprobt (cargo test -p rustango --features sqlite,jobs-postgres --test jobs_sqlite_live).
Inhaltsverzeichnis
- Schritt 1 — Einen Job definieren
- Schritt 2 — Eine Queue starten
- Schritt 3 — Aus einem Handler dispatchen
- Schritt 4 — In deine App verdrahten — das vollständige Beispiel
- Die Worker laufen lassen (CLI + Produktion)
- Retries und Backoff
- Der Job-Kontext: ID, Versuch, Stopp
- Der Dead-Letter-Handler
- Die persistente Queue (Produktion)
- Jobs unter Multi-Tenancy
- Geplante Sweeps unter Multi-Tenancy
- Referenz
- Siehe auch
Schritt 1 — Einen Job definieren
Ein Job ist ein serialisierbares Struct, das Job implementiert. Die Payload
ist das, was in die Queue gestellt wird (nach JSON serialisiert); run() ist
die Arbeit. NAME routet eine in die Queue gestellte Payload zurück zu ihrem
Handler, er muss also eindeutig sein.
Erzeuge ein Gerüst mit der CLI — cargo run -- make:job WelcomeEmail schreibt
src/welcome_email.rs; füge pub mod welcome_email; zu src/lib.rs hinzu — oder
schreibe es von Hand:
// src/welcome_email.rs
use rustango::jobs::{Job, JobError};
use serde::{Deserialize, Serialize};

#[derive(Serialize, Deserialize)]
pub struct WelcomeEmail {
    pub to: String,
}

#[async_trait::async_trait]   // the scaffolded Cargo.toml has `async-trait`
impl Job for WelcomeEmail {
    const NAME: &'static str = "welcome_email";

    async fn run(&self) -> Result<(), JobError> {
        tracing::info!(to = %self.to, "welcome email job ran");
        Ok(())
    }
}
run() bekommt nur das Payload: keinen Datenbank-Pool, keinen Mailer. Lege also
ins Payload, was der Job braucht, etwa die Adresse.
Schritt 4 gibt dem Job einen Mailer, damit
er wirklich senden kann.
run() gibt zurück:
Ok(())— erledigt.Err(JobError::Retryable(msg))— transient; der Worker wiederholt mit Backoff.Err(JobError::Fatal(msg))— permanent; überspringe Retries, Dead-Letter es sofort.
Überschreibe const MAX_ATTEMPTS: u32 = 3; auf dem Impl, um die Obergrenze für
Gesamtversuche zu ändern — nicht für Retries. Der Standard 5 bedeutet einen
ersten Lauf plus vier Retries; MAX_ATTEMPTS = 3 ergibt zwei Retries. 0 zählt
als 1: der Job läuft einmal.
Braucht ein Handler Zustand, den das Payload nicht tragen kann, etwa einen
Mailer, registriere ihn mit queue.register_with(move |job: WelcomeEmail| async move { … }).
Diese Closure läuft anstelle von Job::run und kann Werte halten, die du in sie
verschiebst. Beide eingebauten Queues können das. Schritt 4 zeigt ein
vollständiges Beispiel.
Schritt 2 — Eine Queue starten
Für einen einzelnen Prozess (und für Dev und Tests) führt InMemoryJobQueue
Jobs auf tokio-Worker-Tasks aus — ohne Datenbank. Registriere jeden Job-Typ,
dann start() die Worker (Jobs werden nicht aufgenommen, bis du es tust):
use rustango::jobs::{InMemoryJobQueue, JobQueue};
use std::sync::Arc;

let queue = Arc::new(InMemoryJobQueue::with_workers(4));   // 4 worker tasks
queue.register::<WelcomeEmail>().await;                    // before start/dispatch
queue.start().await;

// ... app runs ...

queue.shutdown().await;   // on shutdown: drain in-flight jobs, then stop
shutdown() gibt laufenden Jobs eine Schonfrist (shutdown_grace, Standard 5s),
bricht sie dann ab und stellt sie zurück in die Queue. Wartende Jobs und
geparkte Retries bleiben in der Queue, und ein erneutes start() nimmt sie auf.
Jobs sind at-least-once. Ein laufender Job sieht den Stopp über
JobCtx::stopping, und
ein abgebrochener Job läuft wieder von vorn (die DB-Queue gibt ihre Zeile frei,
auch wenn der Job gerade fertig war). Der Abbruch verbraucht einen Versuch.
Mache jeden Job idempotent.
Behalte den Arc<InMemoryJobQueue> in deinem App-State, damit Handler ihn
erreichen können.
In-Memory bedeutet In-Memory. In der Queue stehende oder in Bearbeitung befindliche Jobs gehen beim Neustart verloren. Für alles, dessen Verlust du dir nicht leisten kannst, verwende die persistente Queue.
Schritt 3 — Aus einem Handler dispatchen
Sobald die Queue läuft, ist das Dispatchen ein einziger Aufruf — er stellt in die Queue und kehrt sofort zurück, sodass der Request nicht auf die Arbeit wartet:
queue.dispatch(&WelcomeEmail { to: "[email protected]".into() }).await?;
Ein Worker nimmt ihn auf und führt run() Augenblicke später aus. Durchgängig
verifiziert: alle drei dispatchten Jobs laufen auf den Workern.
for to in ["[email protected]", "[email protected]", "[email protected]"] {
    queue.dispatch(&WelcomeEmail { to: to.into() }).await.unwrap();
}
// → all three WelcomeEmail::run() calls execute on the worker pool
Schritt 4 — In deine App verdrahten
Die Schritte 1–3 zusammengesetzt, für die App aus Erste Schritte: gib dem Job einen Mailer, registriere ihn einmalig beim Boot, starte die Worker, übergib die Queue an eine Route und drain beim Shutdown.
Zuerst die Job-Datei. Sie behält den WelcomeEmail-Job aus Schritt 1 und fügt
zwei Dinge hinzu: eine register-Funktion und eine /signup-Route.
// src/welcome_email.rs
use std::sync::Arc;

use axum::{http::StatusCode, routing::post, Extension, Json, Router};
use rustango::email::{BoxedMailer, Email};
use rustango::jobs::{InMemoryJobQueue, Job, JobError, JobQueue};
use serde::{Deserialize, Serialize};

#[derive(Serialize, Deserialize)]
pub struct WelcomeEmail {
    pub to: String,
}

#[async_trait::async_trait]
impl Job for WelcomeEmail {
    const NAME: &'static str = "welcome_email";

    // Not called here: `register` below gives the queue a handler instead.
    async fn run(&self) -> Result<(), JobError> {
        tracing::info!(to = %self.to, "welcome email job ran");
        Ok(())
    }
}

/// Register the job with a handler that holds the mailer. Call it once at
/// boot, before `start()`.
pub async fn register<Q: JobQueue>(queue: &Q, mailer: BoxedMailer) {
    queue
        .register_with(move |job: WelcomeEmail| {
            // The closure runs once per job, so each run takes its own copy.
            let mailer = mailer.clone();
            async move {
                Email::new()
                    .to(job.to)
                    .subject("Welcome")
                    .body("Thanks for signing up.")
                    .send(&*mailer)
                    .await
                    .map_err(|e| {
                        if e.is_retryable() {
                            JobError::Retryable(e.to_string()) // mail server down
                        } else {
                            JobError::Fatal(e.to_string()) // bad address: no retry
                        }
                    })
            }
        })
        .await;
}

#[derive(Deserialize)]
pub struct Signup {
    pub email: String,
}

async fn signup(
    Extension(queue): Extension<Arc<InMemoryJobQueue>>,
    Json(form): Json<Signup>,
) -> StatusCode {
    // ... create the user here ...
    // `dispatch` returns at once; a worker sends the email.
    match queue.dispatch(&WelcomeEmail { to: form.email }).await {
        Ok(()) => StatusCode::CREATED,
        Err(e) => {
            tracing::error!(error = %e, "could not queue the welcome email");
            StatusCode::INTERNAL_SERVER_ERROR
        }
    }
}

pub fn router(queue: Arc<InMemoryJobQueue>) -> Router {
    Router::new()
        .route("/signup", post(signup))
        .layer(Extension(queue))
}
mailer ist ein Arc, also übergibt &*mailer den Mailer darin.
Dann src/main.rs. Das ist die generierte Datei aus Erste Schritte, ergänzt um
die Queue. Der Scaffolder legt den Rumpf in run(); die Zeilen kommen dorthin.
Die mit NEW markierten Zeilen sind neu — behalte die Admin- und
Settings-Zeilen:
// src/main.rs: keep the scaffolded main(), which calls run()
use std::sync::Arc;

use myblog::urls;
use rustango::jobs::{InMemoryJobQueue, JobQueue}; // NEW

async fn run() -> Result<(), Box<dyn std::error::Error>> {
    let _ = dotenvy::dotenv();
    let loaded = rustango::config::Settings::load_from_env();
    let settings = loaded.as_ref().cloned().unwrap_or_default();
    let admin_settings = settings.clone();

    // NEW 1. The mailer, from the [mail] settings (see the email guide).
    let mailer = rustango::email::from_settings(&settings.mail)?;

    // NEW 2. Build the queue and register every job type BEFORE start().
    let queue = Arc::new(InMemoryJobQueue::with_workers(4));
    myblog::welcome_email::register(&*queue, mailer).await;
    queue
        .on_dead_letter(|dl| async move {
            tracing::error!(job = dl.name, attempts = dl.attempts, error = %dl.error,
                            "job dead-lettered");
        })
        .await;

    // NEW 3. Start the workers — tokio tasks that run inside THIS process.
    queue.start().await;
    let draining = Arc::clone(&queue);

    rustango::manage::Cli::new()
        // NEW 4. Mount the /signup route, which holds the queue.
        .api(urls::api().merge(myblog::welcome_email::router(queue)))
        .try_nest_with(urls::admin_prefix(&settings), move |pool| {
            urls::admin_router(pool, &admin_settings)
        })
        .with_health()
        .with_loaded_settings(loaded)
        // NEW 5. Drain the queue after the server stops (SIGINT and SIGTERM).
        .on_shutdown(move || async move { draining.shutdown().await })
        .run()
        .await
}
Probiere es mit cargo run aus, und in einem zweiten Terminal:
curl -X POST http://localhost:8080/signup \
     -H "content-type: application/json" \
     -d '{"email":"[email protected]"}'
Der Request antwortet sofort mit 201. Mit dem Standard-Mail-Backend (Konsole)
erscheint die E-Mail einen Moment später im Terminal des Servers.
Um eine Email zu senden, die du im Handler baust, brauchst du keinen eigenen
Job-Typ: rustango::email_jobs::register_email_job und dispatch_email erledigen
das mit zwei Aufrufen. Siehe
Sie außerhalb des Requests versenden.
Den Drain in
on_shutdownlegen, nicht hinterrun(). Frühere Fassungen dieses Beispiels riefenqueue.shutdown()in der Zeile nachrun()auf, und die konnte nie ausgeführt werden: SIGTERM wurde nirgends behandelt, ein Stopp durch den Orchestrator beendete den Prozess also sofort.run()kehrt jetzt beim Signal zurück — aberon_shutdownbleibt der richtige Ort, weil der Hook auch auf dem Tenancy-Pfad läuft und korrekt gegen den Drain des Servers geordnet ist.
Speichere den konkreten Queue-Typ. Der
JobQueue-Trait ist nicht object-safe (seineregister/dispatchsind generisch), du kannst also nichtArc<dyn JobQueue>im State halten — behalte den konkretenArc<InMemoryJobQueue>(oderArc<DatabaseJobQueue>).
Ein Job, der die Datenbank liest
In main.rs kann ein Job den Datenbank-Pool des Servers nicht halten. Cli öffnet
diesen Pool erst, wenn der Server startet, und das ist nach dem Bau deiner Queue.
Du hast zwei Möglichkeiten:
- Lege die Daten ins Payload, so wie
WelcomeEmaildie Adresse. Der Handler kann die Datenbank lesen: Eine mitnest_witheingehängte Route bekommt den Pool, wie in Erste Schritte, Schritt 12b. - Lass den Job in einem Worker-Prozess
laufen. Er öffnet seinen eigenen Pool, und
register_withkann den Pool neben dem Mailer halten.
Die Worker laufen lassen (CLI + Produktion)
start() spawnt die Worker als tokio-Tasks innerhalb des aktuellen
Prozesses. Wenn du also deine App mit der CLI startest — cargo run (das den
Server ausführt) — laufen die Worker direkt daneben. Für die meisten Apps ist
das alles, was du brauchst: ein Prozess bedient Requests und leert die
Queue; es gibt keinen separaten Worker-Befehl.
cargo run                 # starts the server AND the in-process workers
cargo run -- make:job WelcomeEmail   # scaffold a new job type
Ein dedizierter Worker-Prozess (Produktion)
Im großen Maßstab willst du die Worker oft getrennt von der Web-Ebene — damit
ein Traffic-Spike keine Jobs aushungern kann und du beide unabhängig skalierst.
Mit der persistenten Queue zieht jeder Prozess
aus derselben rustango_jobs-Tabelle, führe also einfach ein zweites,
serverloses Binary aus, das die Queue baut, startet und bis zu einem Signal
blockiert. cargo run -- make:worker Worker schreibt ein Gerüst. Hier öffnet der
Worker seinen eigenen Pool, also kann seine register_with-Closure den Pool und
den Mailer halten. Der Job liest das Post-Model aus Erste Schritte:
// src/bin/worker.rs — run with `cargo run --bin worker`
use std::sync::Arc;

use myblog::blog::models::Post;
use myblog::welcome_email::WelcomeEmail;
use rustango::email::Email;
use rustango::jobs::{DatabaseJobQueue, JobError, JobQueue};
use rustango::sql::{FetcherPool, Pool};

#[rustango::main]
async fn main() -> Result<(), Box<dyn std::error::Error>> {
    // A worker never runs main.rs, so it loads `.env` and the settings itself.
    let _ = dotenvy::dotenv();
    let settings = rustango::config::Settings::load_from_env()?;
    let mailer = rustango::email::from_settings(&settings.mail)?;
    let pool = Pool::connect_from_env().await?; // DATABASE_URL
    DatabaseJobQueue::ensure_table_pool(&pool).await?;

    let queue = Arc::new(DatabaseJobQueue::with_workers_pool(pool.clone(), 8));
    // Register the SAME job types the web process dispatches.
    queue
        .register_with(move |job: WelcomeEmail| {
            let pool = pool.clone();
            let mailer = mailer.clone();
            async move {
                let posts = Post::objects()
                    .fetch(&pool)
                    .await
                    .map_err(|e| JobError::Retryable(e.to_string()))?;
                Email::new()
                    .to(job.to)
                    .subject("Welcome")
                    .body(format!("There are {} posts waiting for you.", posts.len()))
                    .send(&*mailer)
                    .await
                    .map_err(|e| JobError::Retryable(e.to_string()))
            }
        })
        .await;
    queue.start().await;

    // Blocks until Ctrl-C (SIGINT) *or* SIGTERM. `tokio::signal::ctrl_c()`
    // alone is SIGINT-only on Unix, so a worker waiting on it is killed
    // outright by `docker stop` / a pod eviction and drains nothing.
    rustango::shutdown::shutdown_signal().await;
    queue.shutdown().await;                     // drain in-flight, then exit
    Ok(())
}
Deploye es als eigenen Container/Service und skaliere auf N Replicas — sie
ziehen alle sicher aus der geteilten Tabelle. Der Web-Prozess muss dann nur noch
dispatch, muss aber jeden Job-Typ, den er sendet, registern (ohne start()), oder seine Queue mit .allow_unregistered_dispatch() bauen; ein nicht registrierter Dispatch wird abgelehnt. Kopple den Worker mit einem
periodischen reclaim_stuck_jobs_pool-Sweep,
um Jobs eines abgestürzten Workers zurückzuholen.
Zwei verschiedene Queues auf einer Tabelle (etwa ein Mailer und ein Report-Runner
mit eigenen Handlern) greifen sich gegenseitig die Jobs. Gib jeder mit
.queue_name("mailer") auf der dispatchenden und der arbeitenden Seite einen
eigenen Namen: Eine benannte Queue führt nur ihre Jobs aus, eine unbenannte nur
unbenannte Jobs. Worker von vor queue_name ignorieren es und führen auch
benannte Jobs aus: Stoppe sie, bevor du auf eine benannte Queue dispatchst.
Retries und Backoff
Ein Job, der Retryable zurückgibt, wird mit exponentiellem Backoff (1s, 2s,
4s, 8s, …, gedeckelt bei 1024s) erneut in die Queue gestellt, bis MAX_ATTEMPTS
Gesamtversuche aufgebraucht sind. Verwende es für transiente Fehler — einen
Timeout, eine rate-limitierte API, einen Deadlock:
#[async_trait::async_trait]
impl Job for FlakyImport {
    const NAME: &'static str = "flaky_import";
    async fn run(&self) -> Result<(), JobError> {
        match call_external_api().await {
            Ok(_)  => Ok(()),
            Err(e) => Err(JobError::Retryable(e.to_string())),   // try again later
        }
    }
}
Der zugrunde liegende Test dispatcht einen Job, der einmal fehlschlägt und dann gelingt, und stellt sicher, dass er mehr als einmal lief und schließlich gelang — das Retry findet tatsächlich statt.
Um die Wartezeit für jeden Job eines Typs zu ändern, überschreibe
fn retry_backoff(failed_attempt: u32) -> Duration im Impl
(failed_attempt ist 0 nach dem ersten Lauf). Um die Obergrenze oder die
Wartezeit aus dem Payload zu setzen, überschreibe fn max_attempts(&self) -> u32
oder fn retry_delay(&self, failed_attempt: u32) -> Duration; standardmäßig
liefern sie MAX_ATTEMPTS und retry_backoff. Die Obergrenze wird beim
Dispatch gelesen. jobs::exponential_backoff(base, failed_attempt) ist die
Standardkurve mit eigener Basis: base, pro Fehlschlag verdoppelt, gedeckelt bei
base · 1024.
Der Job-Kontext: ID, Versuch, Stopp
Beide Queues rufen Job::run_with(&self, ctx: &JobCtx) auf. Standardmäßig ruft es
run() auf, also laufen Jobs, die nur run implementieren, unverändert. Überschreibe
es, um Folgendes zu lesen:
ctx.id()— die ID des Jobs, bei jedem Retry dieselbe. Nur in ihrer Queue eindeutig.ctx.idempotency_key(scope)— die ID unter deinem Scope, für ein externes System.ctx.attempt()— 1 beim ersten Lauf, 2 beim ersten Retry.ctx.stopping()/ctx.is_stopping()— die Queue fährt herunter; beende den Job innerhalb vonshutdown_grace, sonst wird der Lauf abgebrochen und neu eingereiht.
Nutze idempotency_key als Schlüssel für ein externes System, damit eine
wiederholte Abbuchung nicht doppelt abbucht. Die ID der Datenbank-Queue ist die
Zeilen-ID plus ihr Einreihungszeitpunkt, eine neu angelegte Tabelle wiederholt sie
also nicht. Tenants mit eigener Job-Tabelle beginnen trotzdem bei Zeile 1; übergib
daher einen Scope, der die Tabellen unterscheidet, etwa den Tenant-Slug:
use rustango::jobs::{Job, JobCtx, JobError};

#[async_trait::async_trait]
impl Job for ChargeCard {
    const NAME: &'static str = "charge_card";

    async fn run(&self) -> Result<(), JobError> {
        Err(JobError::Fatal("ChargeCard runs through run_with".into()))
    }

    async fn run_with(&self, ctx: &JobCtx) -> Result<(), JobError> {
        let key = ctx.idempotency_key(&self.tenant);   // bei jedem Retry derselbe Schlüssel
        stripe_charge(self.order_id, self.cents, &key)
            .await
            .map_err(|e| JobError::Retryable(e.to_string()))
    }
}
Ein Handler, der an register_with übergeben wird, bekommt nur den Payload, nicht den
Kontext.
Der Dead-Letter-Handler
Wenn ein Job seine Retries erschöpft — oder sofort Fatal zurückgibt — wird er
an den Dead-Letter-Callback übergeben, statt zu verschwinden. Registriere
einen (vor start), um den Fehlschlag zu loggen, zu alarmieren oder zu
persistieren:
queue
    .on_dead_letter(|dl| async move {
        // dl: JobDeadLetter { name, payload, attempts, error }
        tracing::error!(job = dl.name, attempts = dl.attempts, error = %dl.error,
                        "job dead-lettered");
    })
    .await;
Ein Fatal-Fehler überspringt Retries und landet hier beim ersten Versuch:
async fn run(&self) -> Result<(), JobError> {
    Err(JobError::Fatal("unprocessable payload".into()))   // → dead-letter now
}
Der Test bestätigt, dass der Callback für einen Fatal-Job genau einmal
feuert, mit intaktem name und error des Jobs.
Die persistente Queue (Produktion)
InMemoryJobQueue ist Einzelprozess und vergisst beim Neustart. Für echte
Deployments — mehrere Worker, mehrere Replicas, Jobs, die einen Absturz
überstehen müssen — verwende DatabaseJobQueue (derselbe Typ wie
PgJobQueue). Jobs leben in einer rustango_jobs-Tabelle; Worker nehmen sie
innerhalb einer Transaktion auf (FOR UPDATE SKIP LOCKED auf PostgreSQL und
MySQL, ein einzelnes UPDATE … RETURNING auf SQLite), es ist also über
Prozesse hinweg sicher. Sie ist tri-dialektisch (PostgreSQL, MySQL, SQLite).
Die Job-Definitionen aus Schritt 1 bleiben unverändert.
use rustango::jobs::DatabaseJobQueue;   // = rustango::jobs::pg::PgJobQueue
use rustango::jobs::JobQueue;
use std::sync::Arc;
use std::time::Duration;

// 1. Create the jobs table once at boot (idempotent, tri-dialect).
DatabaseJobQueue::ensure_table_pool(&pool).await?;

// 2. Build the queue over your pool + N workers, and start it.
let queue = Arc::new(
    DatabaseJobQueue::with_workers_pool(pool.clone(), 4)
        .poll_interval(Duration::from_millis(50)),
);
queue.register::<WelcomeEmail>().await;
queue.start().await;

// 3. Dispatch exactly as before — now it's durable.
queue.dispatch(&WelcomeEmail { to: "[email protected]".into() }).await?;
Dispatch innerhalb einer Transaktion. Innerhalb eines atomic-Blocks auf dem
eigenen Pool der Queue tritt dispatch dem Block bei: Der Job wird mit ihm
zurückgerollt, und kein Worker wacht vor dem Commit auf. Halte den TxGuard des
Blocks nicht über den Aufruf hinweg.
Abgestürzte Worker wiederherstellen. Stirbt ein Worker mitten im Job, bleibt die Zeile gesperrt. Führe einen periodischen Sweep aus, um Sperren älter als eine Schwelle freizugeben, damit ein anderer Worker den Job wieder aufnimmt:
// e.g. from a scheduled task every few minutes:
let reclaimed = DatabaseJobQueue::reclaim_stuck_jobs_pool(&pool, Duration::from_secs(300)).await?;
Oder die Queue erledigt es: .reclaim_stuck_after(Duration::from_secs(300)) am
Builder fegt den eigenen Pool der Queue beim start und danach alle
min(Schwelle, 60s). Standardmäßig aus; die Schwelle wird auf mindestens drei
Heartbeats angehoben.
Ein laufender Job erneuert seine Sperre alle heartbeat_interval (Standard 10 s),
halte die Schwelle also deutlich darüber. Jede Aufnahme verbraucht einen Versuch,
ein Job, der seinen Worker abstürzen lässt, landet also im Dead-Letter, sobald
MAX_ATTEMPTS Läufe verbraucht sind. Ein Job, der paniert, ist ein
Retryable-Fehlschlag; der Worker läuft weiter.
Sowohl der Dispatch-and-Run-Fluss als auch reclaim_stuck_jobs_pool werden per
Dogfooding gegen SQLite in jobs_sqlite_live.rs erprobt.
Jobs unter Multi-Tenancy
Ein Worker ist kein Request. Nichts hat für ihn einen Tenant aufgelöst — kein
Host, kein Header, keine Middleware lief — also trägt ein Job keinen
Tenant-Kontext: run(&self) erhält nur das deserialisierte Payload. Die
Isolation kommt aus dem Pool, auf dem die Queue gebaut wurde, und daraus
folgt die Regel:
Eine Queue pro Tenant-Pool. Eine Tenant-Id im Payload ist Routing, keine Isolation.
Diese eine Entscheidung ist es, die jeden Modus sicher macht:
| Modus | Wo rustango_jobs liegt | Warum ein Worker gescoped bleibt |
|---|---|---|
database | in der eigenen Datenbank / SQLite-Datei des Tenants | die Zeilen eines anderen Tenants stehen nicht in der Tabelle, die der Worker abfragt — Cross-Tenant-Lesezugriffe sind nicht ausdrückbar |
schema (PG) | im Schema des Tenants | scoped_pool_dyn liefert einen Pool, in dessen Connect-Options search_path eingebacken ist, statt eines SET pro Request — jeder Checkout ist also für die gesamte Lebensdauer des Pools gescoped, auch bei einem Worker, der tagelang läuft |
Baue die Queues beim Boot, eine pro aktivem Tenant:
use rustango::core::Column as _;
use rustango::jobs::{DatabaseJobQueue, JobQueue};
use rustango::sql::FetcherPool as _;
use rustango::tenancy::{Org, TenantPools};
use std::sync::Arc;
use std::time::Duration;
let pools = Arc::new(TenantPools::new(registry));
let registry_pool = pools.registry_pool();
// The registry holds the tenant list; each `Org` names its own
// database (or PG schema).
let orgs: Vec<Org> = Org::objects()
.where_(Org::active.eq(true))
.fetch(®istry_pool)
.await?;
let mut queues = Vec::new();
for org in orgs {
let pool = pools.scoped_pool_dyn(&org).await?; // scoped for its lifetime
DatabaseJobQueue::ensure_table_pool(&pool).await?;
let queue = Arc::new(
DatabaseJobQueue::with_workers_pool(pool, 2)
.poll_interval(Duration::from_secs(1)),
);
queue.register::<WelcomeEmail>().await;
queue.start().await;
queues.push((org.slug, queue));
}
Der Dispatch geht dann an die Queue dieses Tenants — in einem
Request-Handler an die, die unter dem Org liegt, das der Resolver schon
erzeugt hat.
Was man nicht tun sollte. Eine Queue auf dem Registry-Pool mit einem
org_id-Feld im Payload legt die Jobs aller Tenants in eine gemeinsame
Tabelle und überlässt es jedem run(), sich ans Re-Scoping zu erinnern. Ein
einziges vergessenes Re-Scoping ist ein Cross-Tenant-Write. Wenn du aus
betrieblichen Gründen eine gemeinsame Queue brauchst, löse den Tenant-Pool als
erstes in run() auf und fasse den Registry-Pool danach nicht mehr an.
Bekannte Grenzen. Das Framework übernimmt den Fan-out nicht für dich: es
gibt keinen Worker-Supervisor pro Tenant, kein Job::run(&ctx) mit
angehängtem Tenant und keinen Tenant-bewussten reclaim_stuck_jobs_pool-Sweep
— du iterierst selbst über die Tenants, wie oben (.reclaim_stuck_after(..) an
der Queue jedes Tenants fegt den Pool dieses Tenants). Tenants, die nach dem Boot
provisioniert werden, bekommen bis zum Prozess-Neustart keine Worker.
Das ist eine bekannte Lücke.
Ambienter Kontext: nur Audit-Quelle und Zeitzone. InMemoryJobQueue
erfasst sie bei dispatch, der Scheduler bei every(), und beide setzen sie
um den Lauf wieder ein. PgJobQueue speichert sie in rustango_jobs.context;
ensure_table_pool fügt die Spalte einer älteren Tabelle hinzu. Ohne die Spalte
laufen Jobs als AuditSource::System. Keine Queue trägt eine Session oder einen
Tenant.
Eine Quelle aus dem Tenant-Admin nennt einen Benutzer dieses Tenants. Sie wird
nur bei Schreibvorgängen über den Pool erfasst, den tenancy::with_tenant (oder
for_each_tenant) für diesen Tenant übergibt. Andere Schreibvorgänge, auch über
einen anderen Pool darin, erfassen system:
rustango::tenancy::with_tenant(&pools, &org, |pool| async move {
    note.insert(&pool).await
})
.await??;
Geplante Sweeps unter Multi-Tenancy
Dasselbe „ein Worker ist kein Request"-Problem trifft auch zeitbasierte
Arbeit, und die Sweep-Helfer des Frameworks sind die Stelle, an der es beißt:
MediaManager::purge_orphans, audit::cleanup_older_than_pool und
prunable::prune_all nehmen jeweils einen Pool, und jede Tabelle, die sie
anfassen, ist pro Tenant. Ein Pool heißt ein Tenant — und ein Registry-Pool im
Schema-Modus heißt nur public, während die Zeilen jedes Tenants anwachsen und
der Sweep trotzdem Erfolg meldet.
Mach den Fan-out mit for_each_tenant: es löst für jeden aktiven Tenant
dessen eigenen Pool auf und macht weiter, wenn ein Tenant scheitert:
use rustango::tenancy::for_each_tenant;

let opts = &opts;
let sweep = for_each_tenant(&pools, move |_org, pool| async move {
    rustango::prunable::prune_all(&pool, opts).await
})
.await?;

tracing::info!(ok = sweep.succeeded(), failed = sweep.failed(), "nightly prune");
for (slug, err) in sweep.errors() {
    tracing::warn!(%slug, %err, "tenant prune failed");
}
Ein kaputter Tenant — rotiertes Credential, nicht erreichbare Datenbank —
landet im Report, statt den Lauf abzubrechen, und kann so die Tenants danach
nicht aushungern. Inaktive Orgs werden übersprungen. purge_orphans ist der
eine Sweep, der über die Datenbank hinausgreift (er löscht Storage-Objekte),
darum gibt es purge_orphans_dry_run: dieselbe Query, löscht nichts — ein Blick
darauf lohnt sich, bevor du das echte Ding verdrahtest.
Wenn du den Sweep so absicherst, dass nur eine Replica ihn ausführt, dann scope das Lock pro Tenant:
use rustango::cache::CacheScope;

let tenant = TenantSlug::of(&org).expect("a registry org");
let lock = CacheScope::for_tenant(cache.clone(), &tenant).locks();
// Tick every minute; this runs once per UTC day across replicas.
lock.once_per_period("nightly_prune", day, || prune(&org)).await;
Ungescoped konkurrieren alle Tenants um dasselbe lock:nightly_prune: der
erste Tenant gewinnt, die übrigen werden für die gesamte TTL übersprungen — und
zwar still, denn ein abgelehntes Acquire ist das erwartete Ergebnis, es wird
nichts geloggt. Das ist eine bekannte Lücke.
Referenz
Backends
| Backend | Verwenden für | Übersteht Neustart? |
|---|---|---|
InMemoryJobQueue | Einzelprozess, Dev, Tests | nein |
DatabaseJobQueue (PgJobQueue) | Produktion; Multi-Worker / Multi-Replica | ja (rustango_jobs-Tabelle) |
JobError
| Variante | Wirkung |
|---|---|
Retryable(String) | erneut in die Queue mit exponentiellem Backoff, bis zu MAX_ATTEMPTS |
Fatal(String) | Retries überspringen → sofort Dead-Letter |
Queue(String) | interner Queue-Fehler (Serialisierung/Registrierung) |
JobQueue-Methoden: register::<T>() · dispatch(&payload) · start() ·
register_with::<T, _, _>(handler) · shutdown() · pending_count() (Jobs, die
auf Aufnahme warten). Job::run_with bekommt einen JobCtx (id, attempt,
stopping). Beide Queues haben on_dead_letter und shutdown_grace.
DatabaseJobQueue ergänzt ensure_table_pool, with_workers_pool, new_pool,
poll_interval, heartbeat_interval, queue_name, reclaim_stuck_after und
reclaim_stuck_jobs_pool. jobs::inmemory_from_settings(&settings.jobs) baut eine
InMemoryJobQueue mit [jobs] concurrency Workern (Standard 4).
Siehe auch
- Scheduler — für zeitbasierte wiederkehrende Arbeit in festem
Intervall (
Scheduler::every+Duration; keine Cron-Ausdrücke), im Gegensatz zu On-Demand-Jobs. - E-Mail — die kanonische „mach es in einem Job"-Workload.
- Caching — der andere Weg, Request-Handler schnell zu halten.
- Signals — Fire-and-Forget-Hooks, die oft einen Job dispatchen.
- Tenancy-Befehle — das Provisionieren der Tenants, über die eine Queue pro Tenant fan-out macht.